
زاوية Anderson
إزالة الأجسام من الفيديو بشكل أكثر كفاءة باستخدام التعلم الآلي

 أضف Unite.AI إلى مصادرك المفضلة على Google
النقاط الرئيسيةيجمع E2FGVI بين ثلاث مراحل لملء الفيديو في نظام واحد متكامل لتحقيق مكاسب كبيرة في…
عرض المزيد
- يجمع E2FGVI بين ثلاث مراحل لملء الفيديو في نظام واحد متكامل لتحقيق مكاسب كبيرة في الكفاءة.
- يعمل النظام أسرع بخمس عشرة مرة من طرق تدفق البصريات السابقة مع تحقيق نتائج متطورة.
- محول بؤري زمني جديد يوسع الانتباه من ثنائي الأبعاد إلى ثلاثي الأبعاد لتوليد محتوى متماسك عبر الإطارات.
تُظهر الأبحاث الجديدة من الصين نتائج تضاهي أفضل ما توصلت إليه الأبحاث، بالإضافة إلى تحسين ملحوظ في الكفاءة، لنظام جديد لاستكمال الفيديو يمكنه ببراعة إزالة الأجسام من اللقطات.
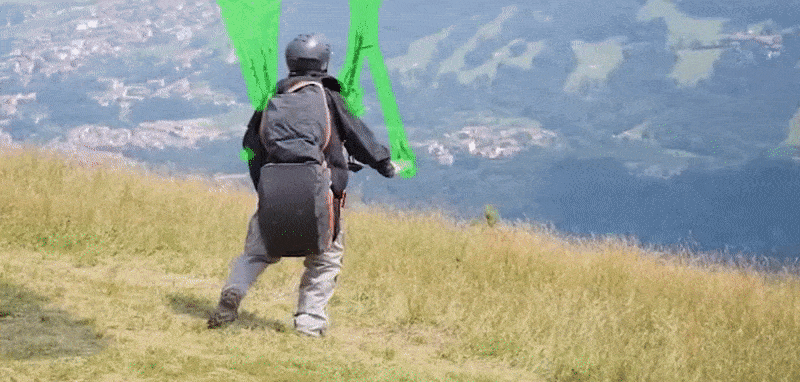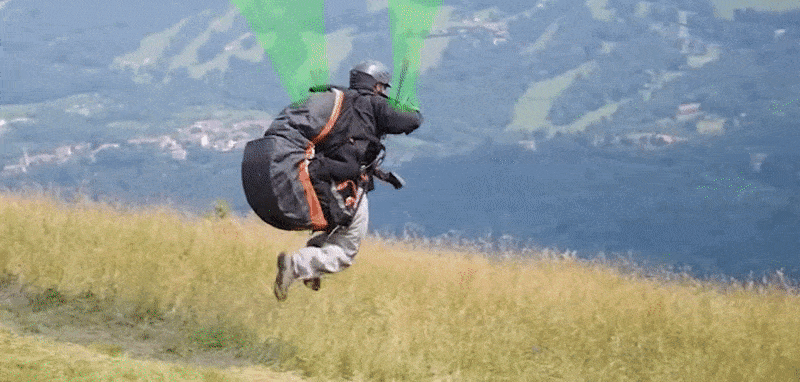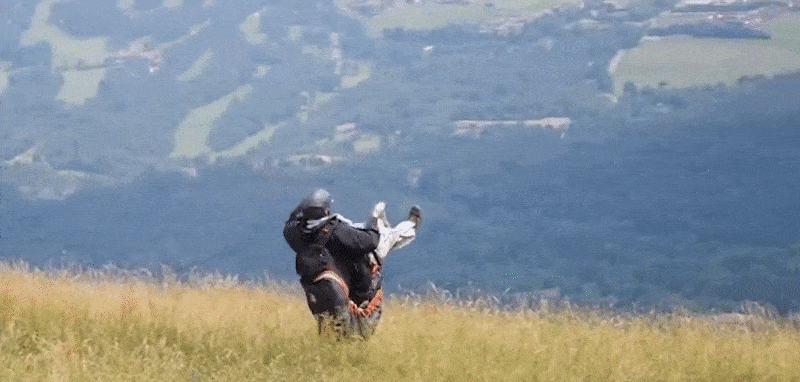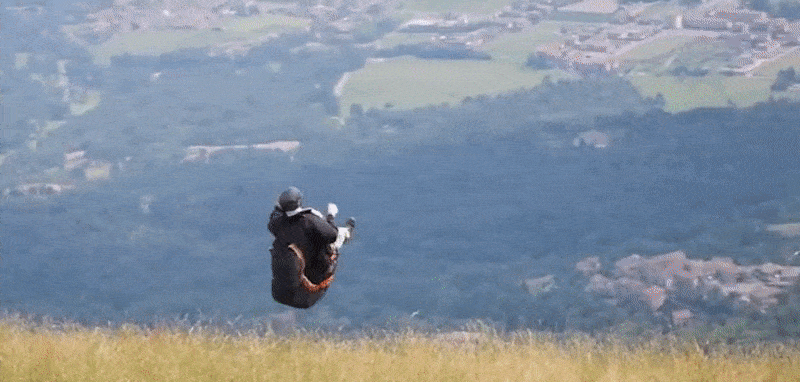
تمت إزالة حزام تثبيت طيار الطائرة الشراعية المعلّقة بواسطة الإجراء الجديد. انظر الفيديو المصدر للحصول على دقة أفضل وأمثلة أكثر. المصدر: https://www.youtube.com/watch?v=N–qC3T2wc4
تسمى هذه التقنية إطار نهاية إلى نهاية لاستكمال الفيديو بواسطة التدفق (E2FGVI)، وهي قادرة أيضًا على إزالة العلامات المائية والأنواع الأخرى من الحجب من محتوى الفيديو.
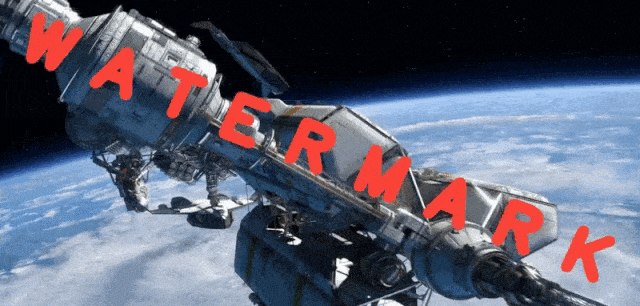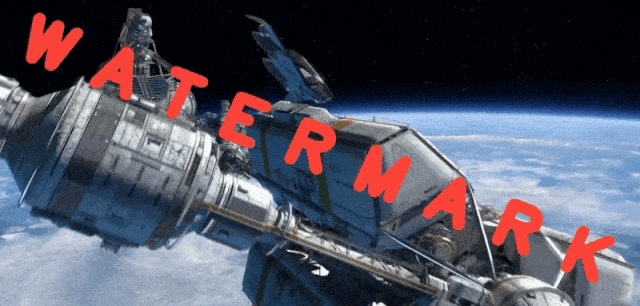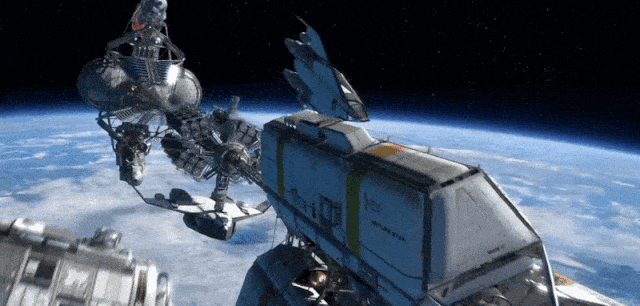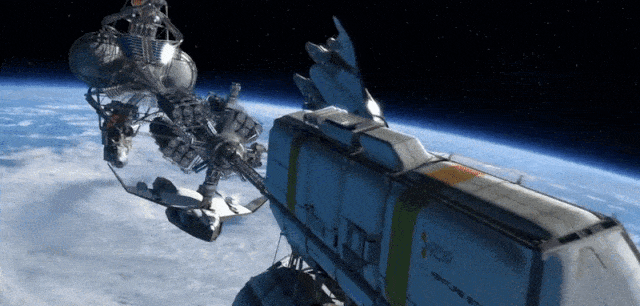
يحسب E2FGVI التنبؤات لمحتوى يقع خلف الحجب، مما يسمح بإزالة العلامات المائية حتى البارزة والصعبة. المصدر: https://github.com/MCG-NKU/E2FGVI
(لمشاهدة المزيد من الأمثلة بدقة أفضل، انظر الفيديو)
على الرغم من أن النموذج المذكور في الورقة المنشورة تم تدريبه على فيديوهات بحجم 432px x 240px (أحجام مدخلات منخفضة بشكل شائع، مقيدة بمساحة GPU المتاحة مقابل أحجام الدفعة المثالية والعوامل الأخرى)، إلا أن المؤلفين قد أصدروا E2FGVI-HQ، الذي يمكنه التعامل مع الفيديوهات بدقة تعسفية.
يتوفر رمز الإصدار الحالي في GitHub، بينما يمكن تحميل الإصدار HQ، الذي تم إصداره الأحد الماضي، من Google Drive و Baidu Disk.

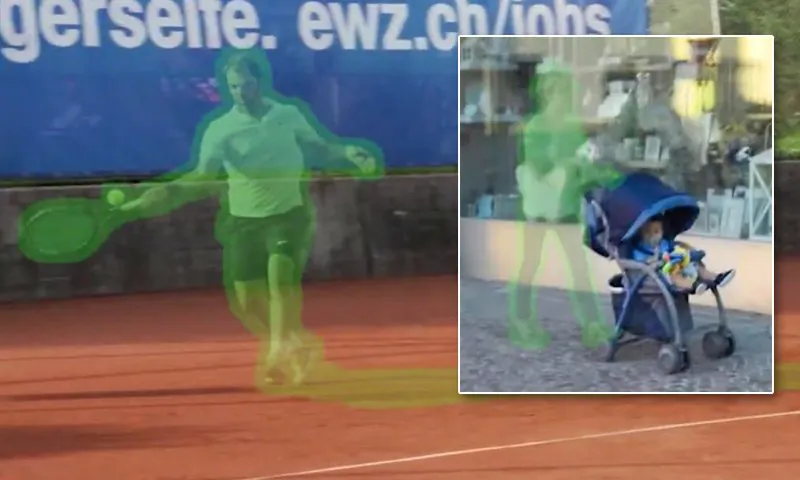
يبقى الطفل في الصورة.
يمكن لـ E2FGVI معالجة فيديو 432×240 في 0.12 ثانية لكل إطار على جهاز Titan XP GPU (12GB VRAM)، ويبلغ المؤلفون أن النظام يعمل خمسة عشر مرة أسرع من الطرق السابقة الأكثر تقدمًا القائمة على التدفق البصري.
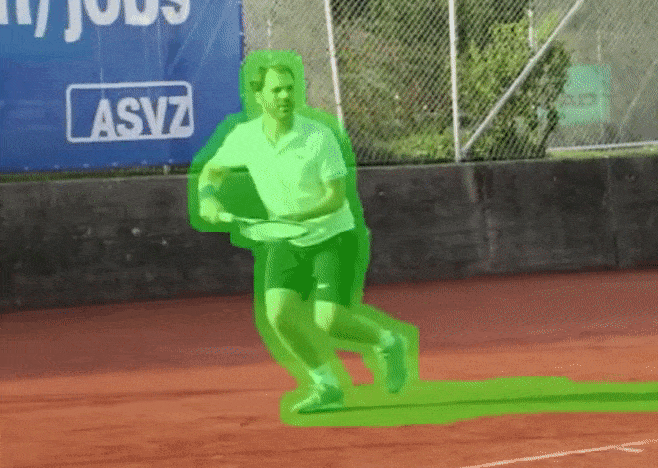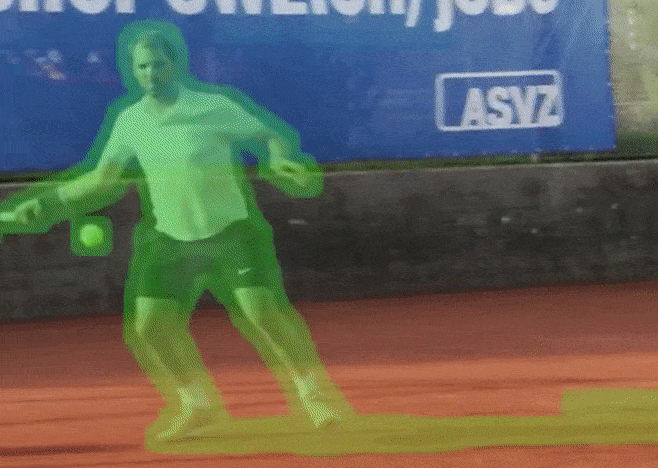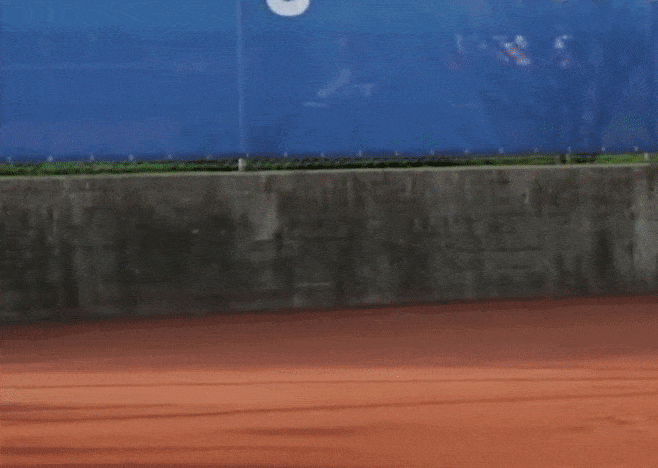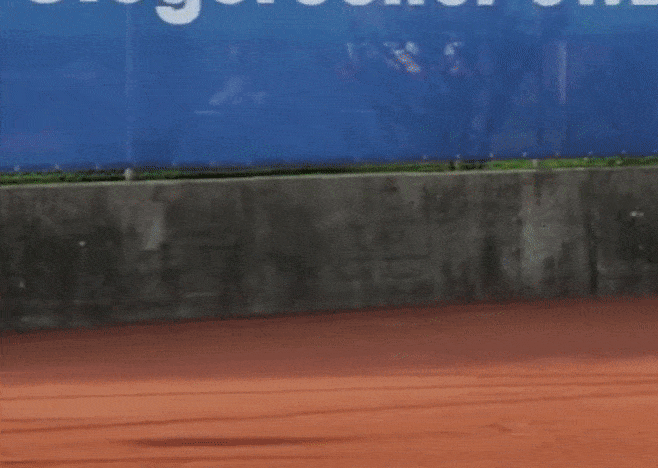
يغادر لاعب التنس بشكل غير متوقع.
تم اختبار الطريقة الجديدة على مجموعات بيانات معيارية لهذا القسم من أبحاث تركيب الصور، وتمكنت من التفوق على منافسيها في الجلسات التقييمية النوعية والكمية.

اختبارات ضد النهج السابقة. المصدر: https://arxiv.org/pdf/2204.02663.pdf
الورقة بعنوان نحو إطار نهاية إلى نهاية لاستكمال الفيديو بواسطة التدفق، وهي تعاون بين أربعة باحثين من جامعة نانكاي، إلى جانب باحث من شركة Hisilicon Technologies.
ما الذي يفتقد في هذه الصورة
بجانب التطبيقات الواضحة للتأثيرات البصرية، من المتوقع أن يصبح استكمال الفيديو عالي الجودة سمة أساسية لتقنيات تركيب الصور وتعديلها القائمة على الذكاء الاصطناعي الجديدة.
هذا هو الحال بشكل خاص لتطبيقات الموضة التي تعمل على تعديل الجسم، وإطارات أخرى تسعى إلى تنحيف الجسم أو تعديل المشاهد في الصور والفيديو. في مثل هذه الحالات، من الضروري “ملء” الخلفية الإضافية التي يتم الكشف عنها بواسطة عملية تركيب الصور.

من ورقة حديثة، يتم تكليف خوارزمية “تحويل” الجسم باستكمال الخلفية التي تظهر عند تغيير حجم الشخص في الصورة. هنا، يتم تمثيل هذا النقص بواسطة الخط الأحمر الذي كان يشغله الشخص ذو البنية الأكثر امتلاءً (انظر الصورة على اليسار). استنادًا إلى مواد مصدر من https://arxiv.org/pdf/2203.10496.pdf
التدفق البصري المتسق
أصبح التدفق البصري (OF) تكنولوجيا أساسية في تطوير إزالة الأجسام من الفيديو. مثل الأطلس، يوفر OF خريطة واحدة لتسلسل زمني. غالبًا ما يتم استخدامه لقياس السرعة في مبادرات الرؤية الحاسوبية، يمكن للتدفق البصري أيضًا أن يتيح التعبئة المتسقة زمنيًا، حيث يمكن اعتبار المهمة بأكملها في مرور واحد، بدلاً من نهج “الانتباه لكل إطار” على غرار ديزني، مما يؤدي حتماً إلى انقطاع زمني.
ركزت طرق استكمال الفيديو حتى الآن على عملية ثلاثية المراحل: استكمال التدفق، حيث تُرسم بموجبه خريطة للفيديو بشكل أساسي إلى كيان منفصل ويمكن استكشافه؛ نشر البكسلات، حيث يتم ملء الثقوب في الفيديوهات “التالفة” عن طريق نشر البكسلات بشكل ثنائي الاتجاه؛ و تخيل المحتوى (اختراع البكسل الذي يعرفه معظمنا من deepfakes و إطارات نص-صورة مثل سلسلة DALL-E) حيث يتم اختراع المحتوى “الناقص” المتوقع وادخاله في اللقطات.
الابتكار المركزي لـ E2FGVI هو الجمع بين هذه المراحل الثلاث في نظام نهاية إلى نهاية، مما يلغي الحاجة إلى تنفيذ عمليات يدوية على المحتوى أو العملية.

تلاحظ الورقة أن الحاجة إلى التدخل اليدوي تتطلب أن لا تأخذ العمليات القديمة ميزة GPU، مما يجعلها تستغرق وقتًا طويلاً. من الورقة*:
‘إذا اخذنا DFVI كمثال، فإن استكمال فيديو بحجم 432 × 240 من DAVIS، والذي يحتوي على حوالي 70 إطارًا، يحتاج إلى حوالي 4 دقائق، وهو ما لا يُقبل في معظم التطبيقات الواقعية. بالإضافة إلى ذلك، إلى جانب العيوب المذكورة أعلاه، فإن استخدام شبكة مدرّبة مسبقًا لاستكمال الصور فقط في مرحلة تخيل المحتوى يغفل العلاقات بين المحتوى عبر الجيران الزمنيين، مما يؤدي إلى محتوى غير متسق في الفيديوهات.’
من خلال توحيد المراحل الثلاث لاستكمال الفيديو، يمكن لـ E2FGVI استبدال المرحلة الثانية، نشر البكسلات، بنشر السمات. في العمليات المقطعة من الأعمال السابقة، لا تكون الميزات متاحة بسهولة، لأن كل مرحلة هي نسبيًا مغلقة، والعملية نصف أوتوماتيكية فقط.
علاوة على ذلك، قام الباحثون بتصميم مُحَوِّل بؤري زمني لمرحلة تخيل المحتوى، والذي يأخذ في الاعتبار ليس فقط الجيران المباشرين للبكسل في الإطار الحالي (أي ما يحدث في ذلك الجزء من الإطار في الصورة السابقة أو التالية)، ولكن أيضًا الجيران البعيدين الذين تفصلهم إطارات عديدة ويؤثرون على التأثير المتسق للعمليات التي تتم على الفيديو ككل.

هيكل E2FGVI.
الجزء المركزي الجديد للمسار يمكن أن يستفيد من المزيد من العمليات على مستوى الميزة وإزاحات أخذ العينات القابلة للتعلم، بينما يمدد محوّل البؤرة الجديد، وفقًا للمؤلفين، حجم النوافذ البؤرية “من 2D إلى 3D”.
الاختبارات والبيانات
لاختبار E2FGVI، قام الباحثون بتقييم النظام ضد مجموعتين شائعتين من مجموعات بيانات تقسيم الأجسام في الفيديو: YouTube-VOS و DAVIS. تتميز YouTube-VOS ب 3741 مقطع فيديو للتدريب و 474 مقطعًا للتحقق و 508 مقاطع اختبار، بينما تتميز DAVIS ب 60 مقطعًا للتدريب و 90 مقطعًا اختبارًا.
تم تدريب E2FGVI على YouTube-VOS وتقييمه على كلا المجموعتين. خلال التدريب، تم توليد أقنعة الأجسام (المناطق الخضراء في الصور أعلاه والفيديو المصاحب على YouTube) لمحاكاة استكمال الفيديو.
للمقاييس، اعتمد الباحثون نسبة الإشارة إلى الضوضاء القصوى (PSNR) والتشابه الهيكلي (SSIM) ومسافة Fréchet Inception القائمة على الفيديو (VFID) وخطأ لفّ التدفق – الأخير لقياس الاستقرار الزمني في الفيديو المتأثر.
البنى السابقة التي تم اختبار النظام ضدها كانت VINet و DFVI و LGTSM و CAP و FGVC و STTN و FuseFormer.

من قسم النتائج الكمية في الورقة. تشير السهام للأعلى والأسفل إلى أن الأرقام الأعلى أو الأقل هي أفضل، على التوالي. يحقق E2FGVI أعلى الدرجات عبر اللوحة. تم تقييم الطرق وفقًا لـ FuseFormer، على الرغم من أن DFVI و VINet و FGVC ليست أنظمة نهاية إلى نهاية، مما يجعل من المستحيل تقدير FLOPs الخاصة بهم.
بالإضافة إلى تحقيق أفضل النتائج ضد جميع الأنظمة المنافسة، أجرى الباحثون دراسة نوعية للمستخدمين، حيث تم عرض فيديوهات محولة ب خمس طرق ممثلة على متطوعين عشرين، وتمت مطالبتهم بتقييمها من حيث الجودة البصرية.

يمثل المحور العمودي نسبة المشاركين الذين فضلوا إخراج E2FGVI من حيث الجودة البصرية.
يلاحظ المؤلفون أنه على الرغم من التفضيل الموحد لطريقتهم، فإن أحد النتائج، FGVC، لا يعكس النتائج الكمية، وهم يقترحون أن هذا يشير إلى أن E2FGVI قد يولّد، على نحو مضلل، “نتائج أكثر إمتاعًا بصريًا”.
فيما يتعلق بالكفاءة، يلاحظ المؤلفون أن نظامهم يقلل بشكل كبير من عمليات النقطة العائمة في الثانية (FLOPs) ووقت الاستدلال على جهاز Titan GPU واحد على مجموعة بيانات DAVIS، ويشيرون إلى أن النتائج تظهر E2FGVI يعمل 15 مرة أسرع من الطرق القائمة على التدفق.
هم يعلقون:
‘[E2FGVI] يحمل أقل FLOPs مقارنة بجميع الطرق الأخرى. هذا يشير إلى أن الطريقة المقترحة كفؤة جدًا لاستكمال الفيديو.’
* تحويلي لمراجع المؤلفين الداخلية إلى روابط.
نُشر لأول مرة في 19 مايو 2022.
تم تعديله يوم الثلاثاء 28 أكتوبر 2025، لإزالة تضمين الفيديو المعيب وتصحيح الإشارات إلى الفيديو المضمن في جسم المقالة.


