
زاوية Anderson
نموذج الانتشار eDiffi من NVIDIA يتيح الرسم بالكلمات والمزيد

 أضف Unite.AI إلى مصادرك المفضلة على Google
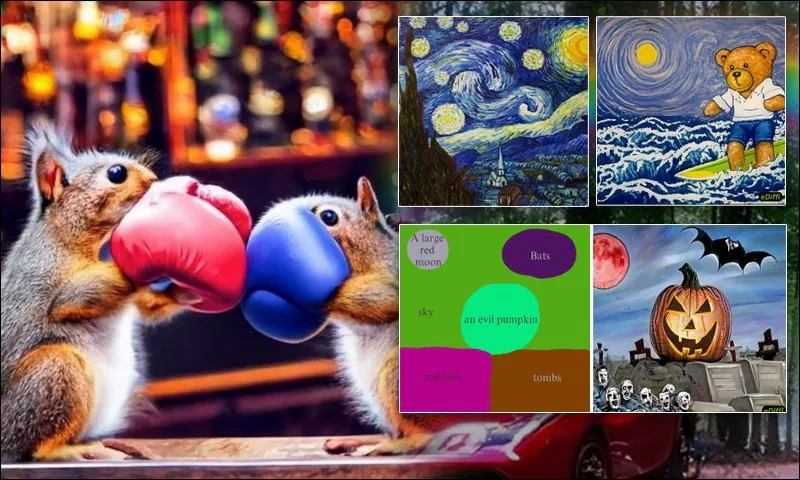
النقاط الرئيسيةيستخدم eDiffi من NVIDIA مجموعة من خبراء إزالة التشويش للتحكم الفائق في تحويل النص إلى…
عرض المزيد
- يستخدم eDiffi من NVIDIA مجموعة من خبراء إزالة التشويش للتحكم الفائق في تحويل النص إلى صورة.
- يدمج النموذج مشفرات T5 وCLIP لتحسين التفاصيل الدقيقة والتكوين العام.
- يتيح eDiffi الرسم بالكلمات من خلال ربط الألوان بعناصر المطالبة لتحقيق تخطيط دقيق.
قد تكون محاولة إنشاء تكوينات دقيقة باستخدام نماذج الصور التوليدية القائمة على الانتشار الكامن، مثل Stable Diffusion، شبيهة بمحاولة جمع قطيع من القطط. فالقدرات التخيلية والتفسيرية نفسها التي تنتج تفاصيل وصورًا استثنائية من أوصاف نصية بسيطة نسبيًا يصعب إيقافها عندما نريد تحكمًا في توليد الصور بمستوى Photoshop.
تقدم أبحاث NVIDIA (NVDA ) نهجًا جديدًا يسمى ensemble diffusion for images، أي الانتشار التجميعي للصور (eDiffi). وهو يمزج عدة طرائق للتضمين والتفسير، بدل استخدام الطريقة نفسها في مسار المعالجة كله، ليتيح تحكمًا أكبر بكثير في المحتوى المولّد. في المثال أدناه يرسم المستخدم عناصر، ويمثل كل لون كلمة واحدة في الوصف النصي.
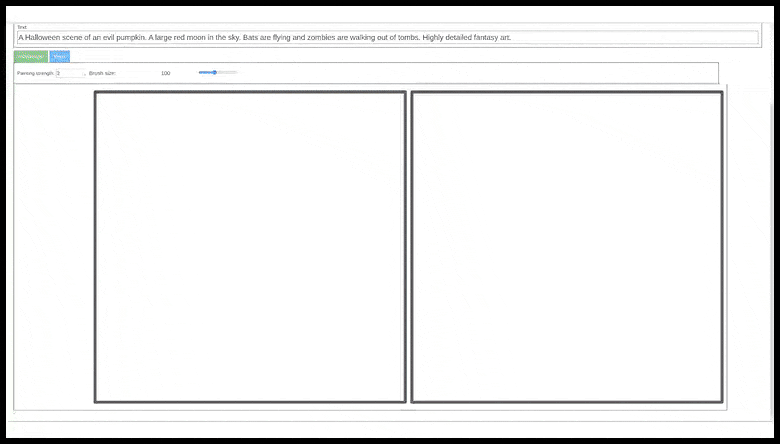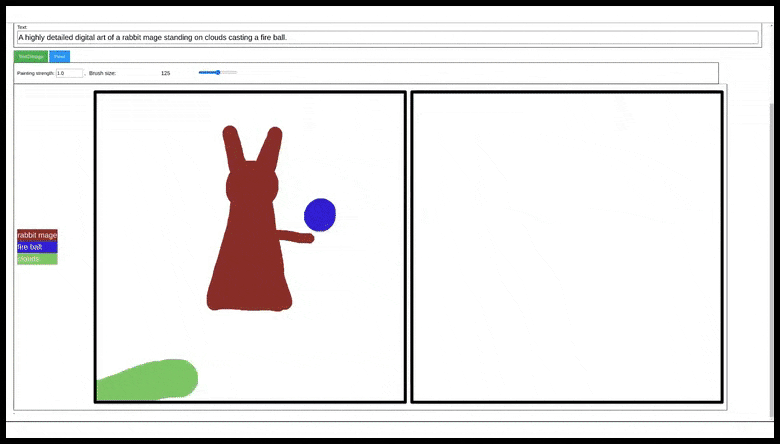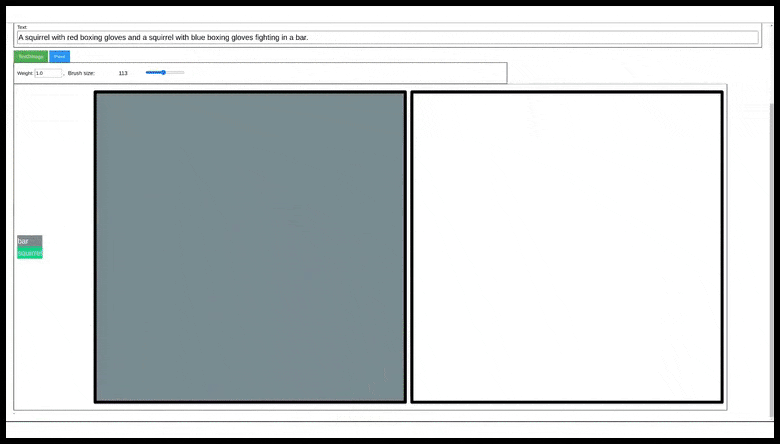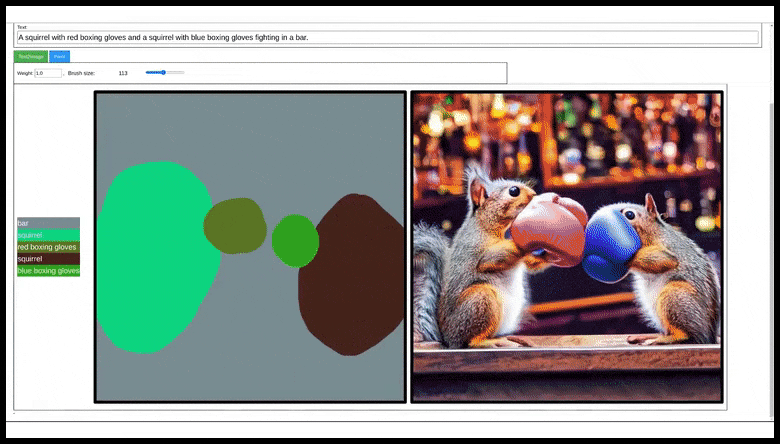
الرسم بالكلمات إحدى ميزتين جديدتين في نموذج eDiffi من NVIDIA. يمثل كل لون كلمة من الوصف، وتظهر الكلمات على اليسار أثناء التوليد، ولا تحتوي المنطقة الملونة إلا على العنصر المقابل. راجع الفيديو الرسمي لمزيد من الأمثلة وبدقة أعلى. https://www.youtube.com/watch?v=k6cOx9YjHJc
هذا في جوهره رسم بالأقنعة، وهو يعكس نهج الترميم داخل الصورة (inpainting) في Stable Diffusion، الذي يصلح الصور التالفة أو غير المرضية، أو يوسع صورًا كان من الممكن إنشاؤها بالحجم المطلوب منذ البداية.
هنا تحدد حواف المساحات الملونة الحدود التقريبية المسموح بها لعنصر منفرد يمثل مفهومًا واحدًا. يستطيع المستخدم بذلك تحديد الحجم النهائي للوحة منذ البداية، ثم إضافة العناصر كلًّا على حدة.

أمثلة من الورقة البحثية الجديدة. المصدر: https://arxiv.org/pdf/2211.01324.pdf
تساعد طرائق eDiffi المتنوعة أيضًا على تضمين جميع عناصر الأوصاف الطويلة والمفصلة. أما Stable Diffusion وDALL-E 2 من OpenAI فيميلان إلى إعطاء الأولوية لأجزاء معينة، تبعًا لمدى ظهور الكلمات المستهدفة مبكرًا في الوصف، أو لعوامل مثل صعوبة فصل العناصر المختلفة اللازمة لتكوين كامل وشامل يطابق الوصف النصي.

من الورقة: يعالج eDiffi الوصف بصورة أشمل حتى يرسم أكبر عدد ممكن من العناصر. ورغم انتقاء النتائج المحسنة في العمود الأيمن لصالح eDiffi، فقد انتُقيت كذلك صور المقارنة الخاصة بـStable Diffusion وDALL-E 2.
يتيح مشفّر T5 المخصص للتحويل من نص إلى نص رسم عبارات إنجليزية مقروءة. يمكن طلب ذلك بصورة مجردة مثل تحتوي الصورة على النص [x]، أو بصورة صريحة مثل مكتوب على القميص Nvidia Rocks.

تعني معالجة النص إلى نص المخصصة في eDiffi إمكان إظهار الكلمات حرفيًا في الصور، بدل الاقتصار على طبقة تفسير من النص إلى الصورة قد تشوه الناتج.
ومن مزايا الإطار الجديد إمكانية تقديم صورة واحدة لتحديد الأسلوب، بدل تدريب نموذج DreamBooth أو تضمين نصي على أمثلة عديدة من نوع أو أسلوب معين.

يمكن نقل الأسلوب من صورة مرجعية إلى طلب توليد صورة من نص، أو حتى إلى طلب تحويل صورة إلى صورة.
عنوان الورقة الجديدة هو eDiffi: نماذج انتشار من النص إلى الصورة باستخدام مجموعة من خبراء إزالة الضوضاء.
مشفّر النص T5
يعد Text-to-Text Transfer Transformer من Google، أو T5، عنصرًا حاسمًا في تحسن نتائج eDiffi. يركز مسار الانتشار الكامن المعتاد على الروابط بين صور التدريب والأوصاف المصاحبة لها عند جمعها من الإنترنت. وقد تُعدل الأوصاف يدويًا لاحقًا، لكن ذلك تدخل مكلف ونادر.

تحويلات نصية من ورقة T5 المنشورة في يوليو 2020، يمكن أن تدعم سير عمل توليد الصور في eDiffi، وربما في نماذج الانتشار الكامن الأخرى. المصدر: https://arxiv.org/pdf/1910.10683.pdf
يمكن بإعادة صياغة النص المصدر وتشغيل وحدة T5 الحصول على روابط وتمثيلات أدق مما تعلمه النموذج أصلًا. يشبه ذلك إسناد تسميات يدوية بأثر لاحق، مع دقة أكبر في تلبية شروط الوصف النصي المطلوب.
يوضح المؤلفون:
«في معظم الأعمال السابقة حول نماذج الانتشار، يُستخدم نموذج إزالة الضوضاء نفسه عبر جميع مستوياتها، وتُمثل الديناميكيات الزمنية بتضمين زمني بسيط يصل إلى النموذج عبر شبكة MLP. ونرى أن النموذج المشترك محدود السعة قد لا يتعلم من البيانات بكفاءة الديناميكيات الزمنية المعقدة لانتشار إزالة الضوضاء.
«نقترح بدلًا من ذلك زيادة سعة النموذج بإدخال مجموعة من خبراء إزالة الضوضاء؛ يتخصص كل خبير في نطاق محدد من مستويات الضوضاء. وبهذا نزيد سعة النموذج دون إبطاء أخذ العينات، لأن التعقيد الحسابي لتقييم العنصر المعالَج في كل مستوى من الضوضاء يظل كما هو».

المخطط المفاهيمي لسير العمل في eDiffi.
يمكن لوحدات ترميز CLIP الموجودة في DALL-E 2 وStable Diffusion أيضًا إيجاد تفسيرات بصرية بديلة للنص الذي يدخله المستخدم. لكنها تدربت على معلومات مشابهة لمعلومات النموذج الأصلي، ولا تُستخدم طبقة تفسير مستقلة كما هو الحال مع T5 في eDiffi.
يذكر المؤلفون أن eDiffi أول مسار يجمع مشفّري T5 وCLIP معًا:
«لأن هذين المشفّرين تدربا على هدفين مختلفين، تفضل تضميناتهما تكوين صور مختلفة للنص المدخل نفسه. تساعد تضمينات CLIP النصية على تحديد المظهر العام للصور المولدة، لكن المخرجات تميل إلى إغفال التفاصيل الدقيقة في النص.
«في المقابل، تعكس الصور المولدة باستخدام تضمينات T5 النصية وحدها الأجسام الفردية الموصوفة بصورة أفضل، لكن مظهرها العام أقل دقة. ويحقق استخدام الاثنين معًا أفضل نتائج توليد الصور في نموذجنا».
التدخل في عملية الانتشار وتعزيزها
تشير الورقة إلى أن نموذج الانتشار الكامن المعتاد يبدأ الانتقال من الضوضاء الخالصة إلى الصورة بالاعتماد على النص وحده في مراحل التوليد المبكرة.
عندما تتحول الضوضاء إلى تخطيط تقريبي يمثل الوصف النصي، يتلاشى عمليًا الجزء الذي يقوده النص، وينتقل باقي العمل إلى تعزيز الخصائص البصرية.
لذلك يصعب إدخال أي عنصر لاحقًا إذا لم يُحسم في المرحلة المبكرة لتفسير الضوضاء بالنص. فالتداخل محدود بين مرحلتي النص إلى التخطيط والتخطيط إلى الصورة، ويكون التخطيط الأساسي قد تشابك إلى حد بعيد عند بلوغ مرحلة تحسين الصورة.

خرائط الانتباه لأجزاء مختلفة من مسار المعالجة. ينخفض تأثير CLIP في الصورة بشدة في الصف السفلي مع التقدم من الضوضاء إلى الصورة، بينما يستمر تأثير T5 إلى مراحل أبعد بكثير من عملية الرسم.
الإمكانات المهنية
تركز أمثلة صفحة المشروع وفيديو YouTube على توليد صور ميمات لطيفة ومناسبة للعلاقات العامة. وكالمعتاد، تقلل أبحاث NVIDIA من إبراز إمكانات ابتكارها في تحسين الصور الواقعية أو سير عمل المؤثرات البصرية، وكذلك تحسين صور وفيديوهات التزييف العميق.
يرسم المستخدم المبتدئ أو الهاوي في الأمثلة حدودًا تقريبية لمواضع العناصر. أما في سير عمل أكثر تنظيمًا للمؤثرات البصرية فقد يفسر eDiffi عدة إطارات من الفيديو بتحويل النص إلى صورة، مستندًا إلى حدود دقيقة، مثل حدود أشخاص أزيلت خلفياتهم بالشاشة الخضراء أو بطرائق خوارزمية.

يوفر Runway ML بالفعل فصل العناصر بالذكاء الاصطناعي عبر الروتوسكوب. تمثل المساحة الخضراء حول الشخص هنا طبقة ألفا؛ وقد استُخرج الشخص بالتعلم الآلي، لا بإزالة خوارزمية لخلفية شاشة خضراء حقيقية. المصدر: https://twitter.com/runwayml/status/1330978385028374529
قد يتيح استخدام شخصية مدربة بواسطة DreamBooth ومسار تحويل صورة إلى صورة في eDiffi البدء في معالجة الاستقرار الزمني، وهو من أصعب مشكلات أي نموذج انتشار كامن. توضع حدود الصورة ومحتواها مسبقًا على لوحة المستخدم. ويمكن لنموذج DreamBooth ثابت حفظ بيانات تدريبه أن يوفر الاستمرارية الزمنية للمحتوى، مثل تحويل شخص حقيقي يمارس التاي تشي إلى روبوت. هذا سيئ لقابلية التفسير، لكنه جيد لقابلية إعادة الإنتاج والدقة والاستمرارية.
الطريقة والبيانات والاختبارات
تدرب eDiffi على مجموعة من البيانات العامة والمملوكة، صُفيت بكثافة باستخدام نموذج CLIP مدرب مسبقًا لاستبعاد الصور التي قد تخفض التقييم الجمالي العام للناتج. تضم المجموعة النهائية نحو مليار زوج من النصوص والصور، ويزيد طول أقصر ضلع في صور التدريب على 64 بكسل.
دُربت عدة نماذج، واستخدم النموذج الأساسي ونموذجا الدقة الفائقة محسّن AdamW بمعدل تعلم 0.0001، واضمحلال أوزان 0.01، وحجم دفعة 2048.
دُرب النموذج الأساسي على 256 وحدة NVIDIA A100، وكل من نموذجي الدقة الفائقة على 128 وحدة NVIDIA A100.
اعتمد النظام على مكتبة Imaginaire المبنية على PyTorch من NVIDIA. استُخدمت مجموعتا COCO وVisual Genome للتقييم، ولم تدخلا في تدريب النماذج النهائية؛ وكانت MS-COCO النسخة المحددة للاختبارات. شملت الأنظمة المقارنة GLIDE وMake-A-Scene وDALL-E 2 وStable Diffusion، ونظامي Google: Imagen وParti.
تماشيًا مع الأعمال السابقة المشابهة، استُخدم مقياس zero-shot FID-30K للتقييم. اختيرت عشوائيًا 30,000 عبارة وصفية من مجموعة التحقق في COCO، أي ليست الصور أو النصوص المستخدمة للتدريب، واستُخدمت مطالبات نصية لتوليد الصور.
حُسبت مسافة Fréchet Inception، أو FID، بين الصور المولدة والصور المرجعية الحقيقية، وسُجلت أيضًا درجات CLIP للصور المولدة.

نتائج اختبارات FID دون تدريب خاص بالمهمة مقارنة بأحدث الأساليب على مجموعة التحقق COCO 2014. القيم الأقل أفضل.
حقق eDiffi أقل درجة، أي أفضل نتيجة، في FID دون تدريب خاص بالمهمة، حتى مقارنة بأنظمة ذات معلمات أكثر بكثير. يضم Parti عشرين مليار معلمة، مقابل 9.1 مليار في أعلى نماذج eDiffi مواصفاتً من بين النماذج المدربة للاختبار.
الخلاصة
يمثل eDiffi من NVIDIA بديلًا مرحبًا به عن الاستمرار في إضافة البيانات والتعقيد إلى الأنظمة الحالية؛ فهو يتبع نهجًا أذكى ومتعدد الطبقات لمعالجة بعض أصعب عوائق تشابك العناصر وعدم قابلية التحرير في توليد الصور بالانتشار الكامن.
تجري بالفعل نقاشات في مجتمعات Stable Diffusion على Reddit وDiscord حول دمج أي شفرة قد تُتاح لـeDiffi مباشرة، أو إعادة تنفيذ مبادئه بصورة مستقلة. لكن المسار الجديد مختلف جذريًا إلى درجة تستدعي تغيير الإصدار الرئيسي لـSD، مع التخلي عن بعض التوافق مع الإصدارات السابقة، مقابل تحكم أكبر بكثير في الصور النهائية دون التضحية بالخيال الجذاب للانتشار الكامن.
نُشر أول مرة في 3 نوفمبر 2022.


