
زاوية Anderson
هل يكتفي DALL-E 2 بلصق الأشياء دون فهم العلاقات بينها؟

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةيفشل DALL-E 2 في إعادة إنتاج العلاقات المكانية الأساسية مثل 'في' أو 'على' في الصور…
عرض المزيد
- يفشل DALL-E 2 في إعادة إنتاج العلاقات المكانية الأساسية مثل 'في' أو 'على' في الصور المُنشأة.
- فقط 22% من صور DALL-E 2 تطابقت مع أوصافها في دراسة شملت 169 مشاركًا.
- تتفاقم إخفاقات النظام في العلاقات عندما تفتقر بيانات التدريب إلى أمثلة للحدث المُصوَّر.
تشير ورقة بحثية جديدة من جامعة هارفارد إلى أن DALL-E 2، إطار OpenAI اللافت للانتباه لتوليد الصور من النصوص، يواجه صعوبة ملحوظة في إعادة إنتاج العلاقات بين عناصر الصور المركبة، حتى العلاقات التي يفهمها الرضيع، رغم التعقيد المذهل لكثير من مخرجاته.
أجرى الباحثون دراسة شملت 169 مشاركًا جرى تجنيدهم عبر منصة جماعية. عُرضت عليهم صور DALL-E 2 القائمة على أبسط مبادئ فهم العلاقات البشرية، مع المطالبات النصية التي ولّدتها. وعند سؤالهم عن توافق الصور والمطالبات، اعتُبرت أقل من 22% من الصور مناسبة للمطالبات المرتبطة بها، فيما يخص العلاقات البسيطة جدًا المطلوب تجسيدها.

لقطة شاشة من تجارب الورقة الجديدة. طُلب من المشاركين اختيار جميع الصور المطابقة للمطالبة. ورغم التنبيه أسفل الواجهة، كانت كل الصور في الواقع مولّدة من المطالبة المعروضة، وهو أمر لم يعرفه المشاركون. المصدر: https://arxiv.org/pdf/2208.00005.pdf
تشير النتائج أيضًا إلى أن قدرة DALL-E الظاهرية على الجمع بين عناصر مختلفة قد تتراجع كلما قل احتمال اجتماع هذه العناصر في بيانات التدريب المستمدة من العالم الحقيقي.
فمثلًا حصلت صور مطالبة «طفل يلمس وعاء» على اتفاق بنسبة 87%؛ أي إن المشاركين اختاروا معظم الصور باعتبارها ذات صلة بالمطالبة. أما الصور الواقعية المشابهة لمطالبة «قرد يلمس إغوانا» فلم تحقق سوى 11%.

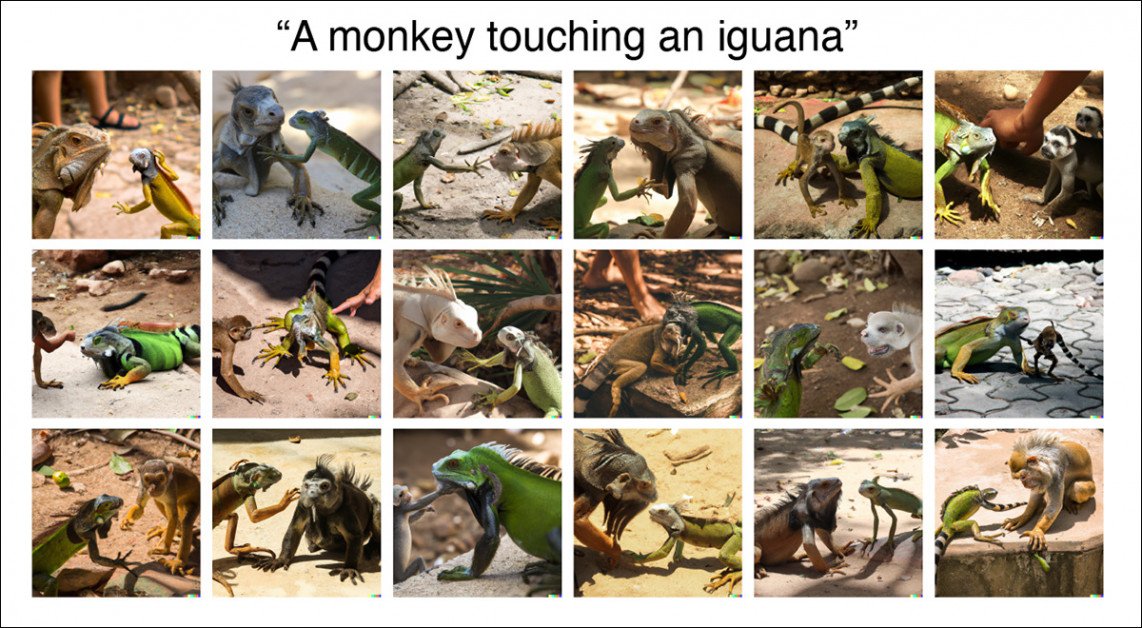
يجد DALL-E صعوبة في تصوير حدث غير مرجح مثل «قرد يلمس إغوانا»، ربما لأنه نادر أو غير موجود أصلًا في مجموعة التدريب.
في المثال الثاني، كثيرًا ما يخطئ DALL-E 2 في الحجم وحتى في نوع الحيوان، على الأرجح لقلة الصور الحقيقية التي تصوّر الحدث. في المقابل، من المعقول توقّع صور تدريب كثيرة عن الأطفال والطعام، وأن يكون هذا المجال الفرعي متطورًا جيدًا.
تشير صعوبة DALL-E في وضع عناصر بصرية شديدة الاختلاف معًا إلى أن الجمهور منبهر حاليًا بواقعية النظام وقدرته التفسيرية الواسعة، إلى حد أنه لم يطوّر نظرة نقدية للحالات التي يكتفي فيها النظام بلصق عنصر بصورة صارخة فوق آخر، كما في هذه الأمثلة من موقع DALL-E 2 الرسمي.
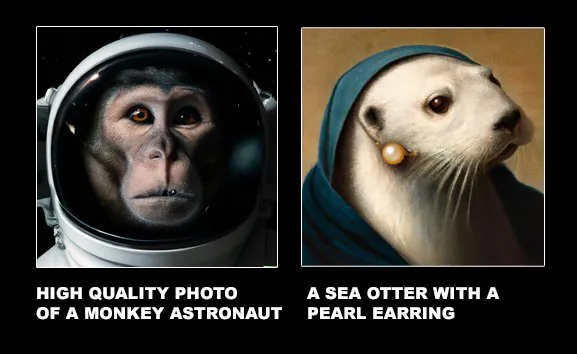
تركيب بالقص واللصق من أمثلة DALL-E 2 الرسمية. المصدر: https://openai.com/dall-e-2/
تقول الورقة الجديدة*:
«فهم العلاقات مكوّن أساسي للذكاء البشري، ويظهر مبكرًا في النمو، ويُحسب سريعًا وتلقائيًا أثناء الإدراك.
«صعوبة DALL-E 2 حتى مع العلاقات المكانية الأساسية، مثل داخل، فوق، تحت، تشير إلى أنه مهما تعلّم، فإنه لم يتعلم بعد التمثيلات التي تتيح للبشر تنظيم العالم بهذه المرونة والمتانة.
«التفسير المباشر لهذه الصعوبة أن أنظمة مثل DALL-E 2 لا تملك بعد القدرة على التركيب القائم على العلاقات.»
يقترح المؤلفان أن تستفيد أنظمة توليد الصور الموجّهة بالنصوص، مثل سلسلة DALL-E، من خوارزميات شائعة في الروبوتات، تنمذج هويات الأشياء وعلاقاتها معًا. فالوكيل يحتاج إلى التفاعل فعليًا مع البيئة، لا مجرد إنشاء مزيج من عناصر متنوعة.
ومن هذه الأساليب CLIPort، الذي يستخدم آلية CLIP نفسها التي تؤدي دور تقييم الجودة في DALL-E 2.
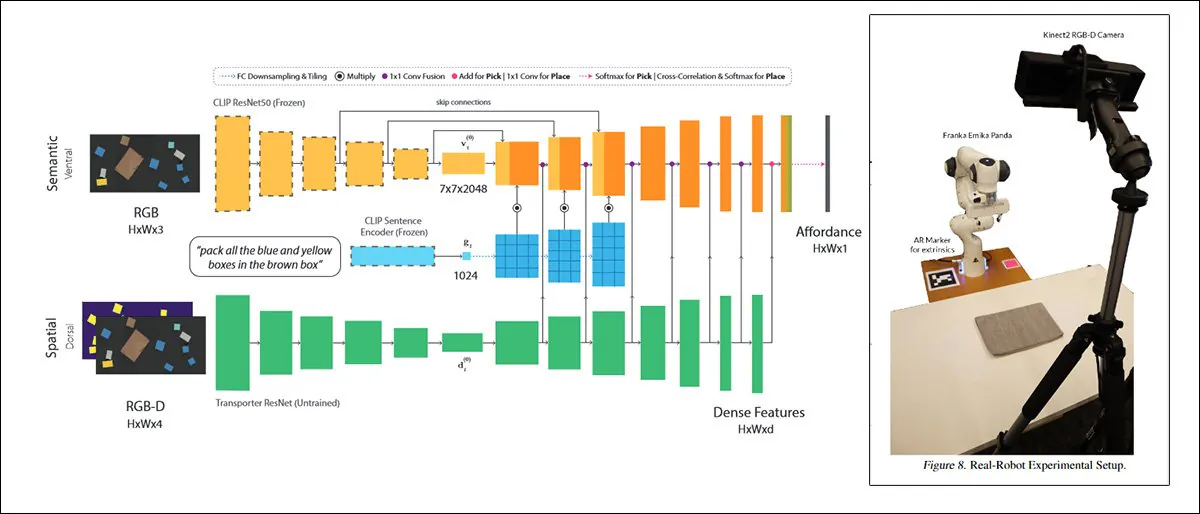
يستخدم CLIPort، وهو تعاون عام 2021 بين جامعة واشنطن وNVIDIA، آلية CLIP في سياق عملي للغاية، بحيث تضطر الأنظمة المدربة فيه إلى فهم العلاقات المادية. وهذا الدافع غائب عن DALL-E 2 وأطر تركيب الصور الخيالية المشابهة. المصدر: https://arxiv.org/pdf/2109.12098.pdf
يقترح المؤلفان تحسينًا محتملًا آخر في بنية أنظمة تركيب الصور مثل DALL-E، وهو دمج تأثيرات ضرب في طبقة حسابية واحدة، لإتاحة حساب العلاقات بطريقة مستلهمة من قدرات معالجة المعلومات لدى المنظومات البيولوجية.
الورقة الجديدة بعنوان اختبار فهم العلاقات في توليد الصور الموجّه بالنص، وأعدّها Colin Conwell وTomer D. Ullman من قسم علم النفس بجامعة هارفارد.
ما بعد الانتقادات المبكرة
عند التعليق على «الخدعة» وراء واقعية مخرجات DALL-E 2 وتماسكها، يشير المؤلفان إلى أعمال سابقة وجدت أوجه قصور في أنظمة توليد الصور من هذا النوع.
في يونيو من هذا العام، أشارت جامعة كاليفورنيا في بيركلي إلى صعوبة معالجة الانعكاسات والظلال. وفي الشهر نفسه، فحصت دراسة كورية تفرّد مخرجات DALL-E 2 وأصالتها بنظرة نقدية. كما كشف تحليل أولي لصور DALL-E 2 أجرته جامعة نيويورك وجامعة تكساس بعد الإطلاق بقليل، مشكلات في القدرة التركيبية وعوامل أساسية أخرى. وفي الشهر الماضي، قدّم عمل مشترك بين جامعة إلينوي ومعهد ماساتشوستس للتكنولوجيا مقترحات لتحسين بنية هذه الأنظمة من ناحية القدرة التركيبية.
ويشير الباحثان كذلك إلى أن شخصيات بارزة في DALL-E، مثل Aditya Ramesh، أقرّت بمشكلات الإطار في ربط السمات والأحجام النسبية والنصوص وغير ذلك.
واقترح مطورو Imagen، نظام Google المنافس لتركيب الصور، أيضًا DrawBench، وهو نظام مقارنة جديد يقيس دقة الصور عبر الأطر باستخدام معايير متنوعة.
لكن مؤلفي الورقة الجديدة يقترحان أن تقييم البشر للصور الناتجة، بدلًا من المقاييس الخوارزمية المتنافسة، قد يحقق نتائج أفضل في تحديد مواضع الضعف وسبل تخفيفها.
الدراسة
لذلك، يبني المشروع الجديد نهجه على مبادئ نفسية، ويحاول التراجع خطوة عن موجة الاهتمام الحالية بـهندسة المطالبات، التي تمثل في الواقع إقرارًا بعيوب DALL-E 2 أو الأنظمة المماثلة، من أجل دراسة القيود التي تجعل هذه الحلول الالتفافية ضرورية، ومعالجتها إن أمكن.
تقول الورقة:
«يركز العمل الحالي على 15 علاقة أساسية سبق وصفها أو فحصها أو اقتراحها في أدبيات الإدراك أو النمو أو اللغة. وتشمل المجموعة علاقات مكانية ملموسة، مثل X فوق Y، وعلاقات أكثر تجريدًا بين الفاعلين، مثل X يساعد Y.
«المطالبات بسيطة عمدًا، دون تعقيد في السمات أو تفصيل. فبدلًا من مطالبة مثل: حمار وأخطبوط يلعبان لعبة. يمسك الحمار أحد طرفي حبل ويمسك الأخطبوط الطرف الآخر. يحمل الحمار الحبل في فمه. تقفز قطة فوق الحبل، نستخدم: صندوق فوق سكين.
«ومع ذلك يلتقط هذا التبسيط نطاقًا واسعًا من العلاقات في فروع علم النفس البشري، ويجعل إخفاقات النموذج المحتملة أكثر وضوحًا وتحديدًا.»
جنّد المؤلفان 169 مشاركًا من Prolific، جميعهم مقيمون في الولايات المتحدة، بمتوسط عمر 33 عامًا، وكانت نسبة النساء 59%.
عُرضت على المشاركين 18 صورة مرتبة في شبكة 3×6، والمطالبة أعلاها وتنبيه أسفلها يقول إن الصور كلها أو بعضها أو لا شيء منها ربما وُلّد من المطالبة المعروضة. ثم طُلب منهم اختيار الصور التي اعتقدوا أنها مرتبطة بالمطالبة.
استندت الصور إلى أدبيات اللغة والنمو والإدراك، وشملت ثماني علاقات مادية وسبع علاقات بين الفاعلين، كما يتضح أدناه.
العلاقات المادية
داخل، فوق، تحت، يغطي، قرب، محجوب بواسطة، متدلٍ فوق، ومربوط بـ.
العلاقات بين الفاعلين
دفع، سحب، لمس، ضرب، ركل، مساعدة، و عرقلة.
استُمدت جميع هذه العلاقات من مجالات الدراسة المذكورة سابقًا خارج علوم الحاسوب.
واختير اثنا عشر كيانًا لاستخدامها في المطالبات، منها ستة أشياء وستة فاعلين:
الأشياء
صندوق، أسطوانة، بطانية، وعاء، فنجان شاي، و سكين.
الفاعلون
رجل، امرأة، طفل، روبوت، قرد، و إغوانا.
(يقرّ الباحثان بأن إضافة الإغوانا، وهي ليست عنصرًا مألوفًا في البحوث الاجتماعية أو النفسية الجافة، كانت «لمسة ممتعة».)
لكل علاقة، أُنشئت خمس مطالبات مختلفة باختيار كيانين عشوائيًا خمس مرات، فبلغ المجموع 75 مطالبة. أُدخلت كل منها إلى DALL-E 2، واستُخدمت الصور الثماني عشرة الأولى لكل مطالبة، دون السماح بتعديلات أو محاولات ثانية.
النتائج
تقول الورقة*:
«أبلغ المشاركون في المتوسط عن توافق منخفض بين صور DALL-E 2 والمطالبات التي ولّدتها، بمتوسط 22.2% [18.3, 26.6] عبر 75 مطالبة مختلفة.
«حققت مطالبات الفاعلين، بمتوسط 28.4% [22.8, 34.2] عبر 35 مطالبة، توافقًا أعلى من المطالبات المادية، التي بلغ متوسطها 16.9% [11.9, 23.0] عبر 40 مطالبة.»

نتائج الدراسة. تمثل النقاط السوداء جميع المطالبات، وكل نقطة مطالبة منفردة. وتفصل الألوان بين ما إذا كان الموضوع فاعلًا أم ماديًا، أي شيئًا.
لمقارنة الإدراك البشري والخوارزمي للصور، مرّر الباحثان الصور عبر إطار OpenAI مفتوح المصدر ViT-L/14 القائم على CLIP. وبعد حساب متوسط الدرجات، وجدا «علاقة متوسطة» بين مجموعتي النتائج. وقد يكون ذلك مفاجئًا بالنظر إلى أن CLIP نفسه يساعد في توليد الصور.

نتائج مقارنة CLIP (ViT-L/14) باستجابات البشر.
يقترح الباحثان أن آليات أخرى داخل البنية، ربما مع وفرة البيانات أو نقصها بالمصادفة في مجموعة التدريب، قد تفسّر قدرة CLIP على تمييز قيود DALL-E دون التمكن من معالجة المشكلة في كل الحالات.
ويخلص المؤلفان إلى أن قدرة DALL-E 2 على إعادة إنتاج صور تتضمن فهم العلاقات هي قدرة اسمية فقط، إن وُجدت أصلًا. وفهم العلاقات جانب أساسي من الذكاء البشري ينمو لدينا مبكرًا جدًا.
«قد تفاجئ فكرة افتقار أنظمة مثل DALL-E 2 إلى القدرة التركيبية من رأى ردودها المعقولة بصورة لافتة على مطالبات مثل: رسم كرتوني لفجل دايكون صغير يرتدي تنورة باليه ويُنزّه كلب بودل. فهذه المطالبات كثيرًا ما تنتج تقريبًا معقولًا لمفهوم مركّب، تكون فيه جميع العناصر موجودة وفي مواضعها الصحيحة.
«لكن القدرة التركيبية ليست مجرد لصق الأشياء، حتى تلك التي لم نرها معًا من قبل. بل تتطلب فهم القواعد التي تربط الأشياء ببعضها. والعلاقات هي هذه القواعد.»
رجل يعضّ تي ريكس
رأي مع استقبال OpenAI عدد أكبر من المستخدمين بعد تحويل النسخة التجريبية من DALL-E 2 إلى خدمة مدفوعة، أصبحت عيوب فهم العلاقات أكثر بروزًا على الأرجح. فمعظم عمليات التوليد تتطلب الدفع الآن، ولكل محاولة «فاشلة» كلفة مالية، ولا تُقدّم استردادات.
من تلقّوا دعوة مبكرة منا أتيح لهم وقت لملاحظة بعض «اختلالات العلاقات» التي يصدرها النظام، وكانت حرية تجربة النظام أكبر حتى وقت قريب.
فمثلًا، بالنسبة إلى معجب بـالحديقة الجوراسية، يصعب جدًا جعل ديناصور يطارد شخصًا في DALL-E 2، رغم أن مفهوم المطاردة لا يبدو مدرجًا في نظام الرقابة الخاص به. كما يُفترض أن التاريخ الطويل لأفلام الديناصورات يوفّر أمثلة تدريب كثيرة، على الأقل في المقاطع الدعائية والصور الترويجية، لهذا اللقاء المستحيل واقعيًا بين النوعين.
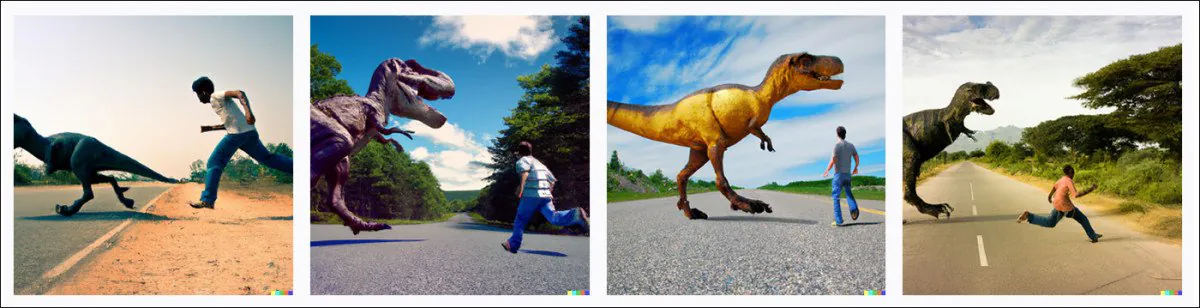
استجابة DALL-E 2 المعتادة لمطالبة «صورة ملوّنة لتي ريكس يطارد رجلًا على طريق». المصدر: DALL-E 2
وجدت أن الصور أعلاه نموذجية للتنويعات على مطالبة «[ديناصور] يطارد [شخصًا]» ، وأن أي قدر من التفصيل لا يجعل تي ريكس يمتثل فعلًا. في الصورتين الأولى والثانية يطارد الرجل تي ريكس إلى حد ما؛ وفي الثالثة يقترب منه باستهتار بالسلامة؛ وفي الأخيرة يبدو كأنه يركض بمحاذاة الوحش الكبير. وعبر نحو 10–15 محاولة حول هذا الموضوع، بدا الديناصور «مشتت الانتباه» على نحو مشابه.
ربما كانت بيانات التدريب الوحيدة المتاحة لـDALL-E 2 من نوع «رجل يقاتل ديناصورًا»، في صور ترويجية لأفلام قديمة مثل مليون سنة قبل الميلاد (1966). وربما كان الهروب الشهير لجيف غولدبلوم من ملك المفترسات مجرد حالة شاذة في هذه المجموعة الصغيرة من البيانات.
* حوّلتُ إحالات المؤلفين داخل النص إلى روابط تشعبية.
نُشر أول مرة في 4 أغسطس 2022.





