زاوية Anderson
كيف تعرف ما إذا كانت أنظمة تركيب الصور تنتج محتوى أصليًا حقًا

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةيقيس مؤشر الندرة (Rarity Score) من KAIST وNAVER أصالة الصورة عبر مسافات الجار الأقرب.
عرض المزيد
- يقيس مؤشر الندرة (Rarity Score) من KAIST وNAVER أصالة الصورة عبر مسافات الجار الأقرب.
- تفضل المقاييس الحالية مثل تقنية الاقتطاع (Truncation Trick) الأصالة على الجدة في الصور المُولَّدة.
- يمكن لمؤشر الندرة تحديد المخرجات المبتكرة حقًا من أنظمة مثل DALL-E 2.
اقترحت دراسة جديدة من كوريا الجنوبية طريقة لتحديد ما إذا كانت أنظمة تركيب الصور تنتج صورًا جديدة حقًا أو “متغيرات صغيرة” على بيانات التدريب ، مما قد يخيب هدف هذه الهياكل (مثل إنتاج صور جديدة وأصلية).
في كثير من الأحيان ، يقترح البحث ، يكون الأمر الأخير صحيحًا ، لأن المقاييس الحالية التي تستخدمها هذه الأنظمة لتحسين القدرات التوليدية خلال التدريب مجبرة على تفضيل الصور التي هي قريبة نسبيًا من الصور المصدر (الغير مزيفة) في مجموعة البيانات.
بعد كل شيء ، إذا كانت الصورة المولدة “قريبة بصريًا” من بيانات المصدر ، فمن المحتمل أن تسجل نتائج أفضل للاختبارات من حيث “الصدق” أكثر من “الأصالة” ، لأنها “مخلصة” – حتى لو كانت غير ملهمة.
في قطاع لا يزال في مرحلة الطفولة ولا يزال غير مألوف ، قد يصبح ذلك قضية قانونية مهمة ، إذا تبين أن محتوى الصور الاصطناعية التجاري لا يختلف بما فيه الكفاية عن مواد المصدر المملوكة (التي غالبًا ما تكون محمية بحقوق الطبع والنشر) التي يتم حاليًا السماح لها بالتدفق إلى قطاع البحث في شكل مجموعات بيانات مأخوذة من الويب (لقد أصبحت إمكانية المطالبات بالانتهاك المحتملة من هذا النوع بارزة مؤخرًا نسبيًا فيما يتعلق بذكاء Microsoft GitHub Co-Pilot).
فيما يتعلق بالمخرجات المتزايد للوضوح والدقة من أنظمة مثل OpenAI DALL-E 2 ، و Google Imagen ، و الصين CogView (بالإضافة إلى DALL-E mini ذو المواصفات الأقل) ، هناك طرق قليلة للتحقق اللاحق من أصالة الصورة المولدة.
في الواقع ، البحث عن بعض الصور الشائعة من الصور الجديدة التي تم إصدارها بواسطة DALL-E 2 غالبًا ما يؤدي فقط إلى المزيد من تلك الصور ، حسب محرك البحث.

رفع مجموعة كاملة من تسع صور ناتجة عن DALL-E 2 يقود فقط إلى مجموعات أخرى مشابهة، لأن الشبكة هي السمة الأقوى. فصل الصورة الأولى من هذا المنشور على Twitter بتاريخ 8 يونيو 2022 من حساب Weird Dall-E Generations ورفعها يجعل Google يركز على كرة السلة، ويدفع البحث إلى طريق دلالي مسدود. أما Yandex فيبدو أنه يجري على الأقل تحليلًا فعليًا للبكسلات ومطابقة للخصائص للصورة نفسها.
على الرغم من أن Yandex أكثر احتمالًا لاستخدام الخصائص الفعلية (أي الخصائص المشتقة أو المحسوبة للصورة ، وليس بالضرورة ميزات الوجه للأشخاص) والخصائص البصرية (بدلاً من الميزات الدلالية) للصورة المرسلة للعثور على صور مشابهة ، جميع محركات البحث بالصور إما لديها بعض النية أو الممارسة التي قد تجعل من الصعب تحديد حالات الانتحال من المصدر>إلى الصورة المولدة عبر عمليات البحث على الويب.
بالإضافة إلى ذلك ، قد لا تكون بيانات التدريب لنموذج مولد متاحة للجمهور بالكامل ، مما يعيق الفحص الجنائي لأصالة الصور المولدة.
من المثير للاهتمام ، عند إجراء بحث بالصور على واحدة من الصور التخيلية المميزة بواسطة Google في موقع Imagen المخصص ، لن يجد شيء مشابه لموضوع الصورة ، من حيث النظر إلى الصورة والبحث المحايد عن صور مشابهة. بل تظل نتائج Google Images أسيرة الدلالة، ولا تتيح بحثًا يعتمد على الصورة وحدها دون إضافة imagen google كمعامل إضافي ومقيّد.

Yandex ، من ناحية أخرى ، يجد مجموعة من الصور الحقيقية المتشابهة (أو على الأقل المرتبطة بصرية) من مجتمع الفن الهواة.

بشكل عام ، سيكون من الأفضل إذا كان يمكن قياس جديد أو أصالة إخراج أنظمة تركيب الصور بطريقة ما ، دون الحاجة إلى استخراج الميزات من كل صورة على الويب في وقت تدريب النموذج ، أو في مجموعات بيانات غير عامة قد تستخدم مواد مملوكة بحقوق الطبع والنشر.
مرتبط بهذه القضية ، قام باحثون من مدرسة كيم جايتشول للدراسات العليا لذكاء الاصطناعي في معهد كوريا المتقدم للعلوم والتكنولوجيا (KAIST AI) بالتعاون مع شركة NAVER Corp العالمية لتقنية المعلومات والبحث لتطوير رقم ندرة يمكن أن يساعد في تحديد الإبداعات الأكثر أصالة لأنظمة تركيب الصور.

هذه الصور مولدة باستخدام StyleGAN-FFHQ. الأعمدة مرتبة من الأسوأ إلى الأفضل من اليسار إلى اليمين. لمقياسي Truncation trick وRealism أهداف خاصة، بينما يبحث رقم الندرة الجديد في الصف العلوي عن صور متماسكة وأصلية، لا متماسكة فقط. بسبب قيود حجم الصور في المقال، راجع الدراسة الأصلية لمزيد من التفاصيل والدقة الأعلى. المصدر: https://arxiv.org/pdf/2206.08549.pdf
الورقة الجديدة بعنوان رقم ندرة: مقياس جديد لتقييم ندرة الصور المولدة ، وتأتي من ثلاثة باحثين من KAIST وثلاثة من NAVER Corp.
ما وراء الحيلة الرخيصة
من بين المقاييس السابقة التي تسعى الورقة الجديدة إلى تحسينها هي “حيلة القطع” المقترحة في عام 2019 في تعاون بين جامعة Heriot-Watt في المملكة المتحدة وشركة Google DeepMind.
تستخدم حيلة القطع أساسًا توزيعًا كامنًا مختلفًا للعينة أكثر من الذي تم استخدامه لتدريب نموذج التوليد.
كان الباحثون الذين طوروا هذه الطريقة مفاجئين من أنها عملت ، لكنهم يعترفون في الورقة الأصلية بأنها تقلل من تنوع الإخراج المولد. ومع ذلك ، أصبحت حيلة القطع فعالة وشائعة ، في سياق ما يمكن وصف بأنه “حيلة رخيصة” للحصول على نتائج تبدو حقيقية دون أن تدمج جميع الإمكانيات الكامنة في البيانات، وقد تشبه بيانات المصدر أكثر مما هو مرغوب.
بخصوص حيلة القطع ، يلاحظ مؤلفو الورقة الجديدة ما يلي:
‘ليست حيلة القطع مصممة لإنتاج عينات نادرة في مجموعات التدريب ، ولكنها لتوليد صور نمطية أكثر استقرارًا. نحن نخمن أن النماذج التوليدية الحالية ستكون قادرة على إنتاج عينات أكثر غنى في توزيع البيانات الحقيقية إذا تمكن المولد من إنتاج عينات نادرة بشكل فعال.’
من الناحية العامة ، هناك ميل للاعتماد على المقاييس التقليدية مثل Frechet Inception Distance (FID ، والتي خضعت لانتقادات شديدة في ديسمبر 2021) ، و inception score (IS) و Kernel Inception Distance (KID) كمؤشرات للتقدم خلال تدريب نموذج التوليد ، يعلق المؤلفون كذلك*:
‘يؤدي مخطط التعلم هذا إلى أن المولد لا يولّد عينات نادرة كثيرًا ، والتي هي فريدة وتتميز بميزات قوية لا تمثل جزءًا كبيرًا من توزيع الصور الحقيقية. أمثلة على العينات النادرة من مجموعات البيانات العامة تشمل أشخاصًا مع إكسسوارات مختلفة في FFHQ ، و حيوانات بيضاء في AFHQ ، و تماثيل غير شائعة في Metfaces.
‘إمكانية توليد العينات النادرة مهمة لا فقط لأنها تتعلق بالقدرات الحدية للنماذج التوليدية ، ولكن أيضًا لأن الفردية تلعب دورًا مهمًا في التطبيقات الإبداعية مثل البشر الافتراضيين.
‘ومع ذلك ، النتائج النوعية لدراسات حديثة نادرًا ما تحتوي على هذه الأمثلة النادرة. نحن نخمن أن مخطط التعلم التنافسي يؤدي إلى توزيع الصور المولدة مشابه لتوزيع مجموعة التدريب. وبالتالي ، الصور التي تتميز بالفردية أو الندرة لا تمثل جزءًا كبيرًا من الصور المولدة بواسطة النماذج.’
التقنية
يكيّف رقم الندرة الجديد فكرة مقدمة في أعمال سابقة أخرى – استخدام K-Nearest Neighbors (KNNs) لتمثيل مصفوفات البيانات الحقيقية (المدربة) والبيانات المولدة (الخرج) في نظام تركيب الصور.
بخصوص هذه الطريقة الجديدة للتحليل ، يؤكد المؤلفون:
‘نحن نخمن أن العينات العادية ستكون أقرب إلى بعضها البعض ، بينما العينات الفريدة والنادرة ستكون متباعدة على نحو متناثر في فضاء الميزات.’
تُظهر صورة النتائج أعلاه مسافات أقرب جار (NND) من الأصغر إلى الأكبر ، في هيكل StyleGAN مدرب على FFHQ.
‘لجميع مجموعات البيانات ، العينات ذات أصغر مسافات لأقرب جار تظهر صورًا تمثيلية ونمطية. على العكس ، العينات ذات أكبر مسافات لأقرب جار تتميز بالفردية وتختلف بشكل كبير عن الصور النمطية ذات أصغر مسافات لأقرب جار.’
في النظرية ، يمكن استخدام هذا المقياس الجديد كمميّز ، أو على الأقل إدراجه في بنية مميّز أكثر تعقيدًا ، لتوجيه نظام التوليد بعيدًا عن التقليد البحت نحو خوارزمية أكثر اختراعًا ، مع الحفاظ على تماسك المفاهيم الأساسية التي قد تكون حاسمة لإنتاج صور حقيقية (أي “رجل” ، “امرأة” ، “سيارة” ، “كنيسة” ، إلخ.).
المقارنات والتجارب
أجريت المقارنات بين أداء رقم الندرة وحيلة القطع و نقطة الواقعية التي قدمتها NVIDIA في عام 2019 ، ووجد أن هذا النهج يمكنه تمييز نتائج “فريدة” في مجموعة متنوعة من الإطارات ومجموعات البيانات.
على الرغم من أن النتائج الموجزة في الورقة طويلة جدًا لدرجها هنا ، يبدو أن الباحثين قد أثبتوا قدرة هذا النهج لتحديد الندرة في كل من الصور الحقيقية والمولدة في إجراء التوليد:
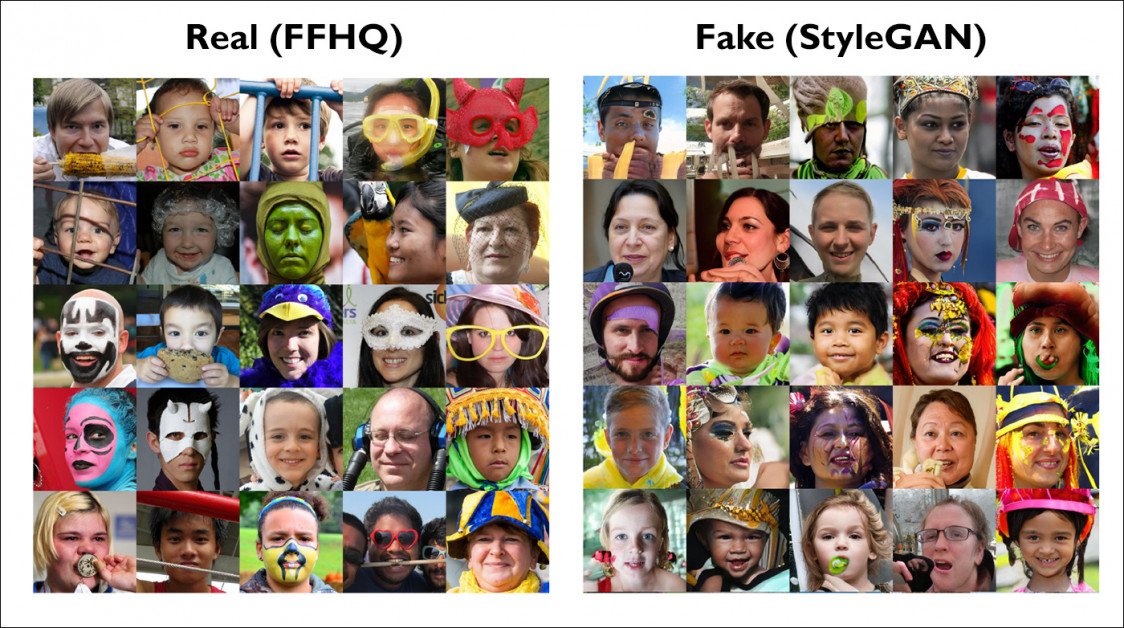
أمثلة مختارة من النتائج البصرية الواسعة للدراسة؛ راجع المصدر أعلاه للتفاصيل. يسارًا أمثلة حقيقية من FFHQ لها جيران قريبون قليلون جدًا في المجموعة الأصلية، أي إنها جديدة وغير مألوفة. يمينًا صور أنشأها StyleGAN وحددها المقياس الجديد بأنها جديدة حقًا. بسبب قيود حجم الصور، راجع الدراسة الأصلية للتفاصيل والدقة الأعلى.
يسمح رقم الندرة الجديد ليس فقط بتحديد الإخراج المولد الجديد في هيكل معين ، ولكن أيضًا بالمقارنات بين نماذج مولدة مختلفة القوام (أي محول التشفير ، VAE ، GAN ، إلخ.).
تلاحظ الورقة أن رقم الندرة يختلف عن المقاييس السابقة من خلال التركيز على قدرة إطار التوليد لإنشاء صور فريدة ونادرة ، بدلاً من المقاييس “التقليدية” التي تدرس (بصورة أكثر تقليدية) التنوع بين الأجيال خلال تدريب النموذج.
ما وراء المهام المحدودة
على الرغم من أن باحثي الورقة الجديدة قد أجروا اختبارات على إطارات مجال محدود (مثل أزواج مولد ومجموعة بيانات مصممة لإنتاج صور لأشخاص أو قطط ، على سبيل المثال) ، يمكن تطبيق رقم الندرة بشكل محتمل على أي إجراء لتركيب الصور حيث يُريد تحديد الأمثلة المولدة التي تستخدم التوزيعات المشتقة من بيانات التدريب ، بدلاً من زيادة الصدق (وتقليل التنوع) من خلال وضع توزيعات كامنة أجنبية ، أو الاعتماد على “حيل” أخرى التي تضحي بالجدة لصالح الصدق.
في الواقع ، يمكن أن يكون هذا المقياس وسيلة لتحديد نتائج حقيقية جديدة في أنظمة مثل سلسلة DALL-E ، عن طريق استخدام المسافة المحددة بين نتيجة واضحة “مختلفة” ، وبيانات التدريب ، ونتائج من تعليمات أو مدخلات مشابهة (أي تعليمات قائمة على الصور).
في الممارسة ، وفي غياب فهم واضح لمدى امتصاص النظام للفهم البصري والدلالي (الذي غالبًا ما يتم حظره بسبب المعرفة المحدودة حول بيانات التدريب) ، يمكن أن يكون هذا النهج وسيلة لتحديد “لحظة الإلهام” الحقيقية في نظام مولد – النقطة التي يكون فيها عدد كافٍ من مفاهيم المدخلات والبيانات قد أدى إلى شيء مخترع حقًا ، بدلاً من شيء مفرط في الاشتقاق أو قريب من بيانات المصدر.
* تحويلي لمراجع المؤلفين الداخلية إلى روابط.
نشر لأول مرة في 20 يونيو 2022.