

نماذج ومنصات الذكاء الاصطناعي
AniPortrait:合成照片级人像动画

 أضف Unite.AI إلى مصادرك المفضلة على Google
多年来,静态图像和音频的逼真和富有表现力的肖像动画的创建已发现了包括游戏、数字媒体、虚拟现实等在内的广泛应用。尽管它具有潜在的应用,但开发人员仍然难以创建能够生成高质量动画的框架,这些动画保持时间一致性并且视觉上吸引人。一个主要原因是需要精细地协调嘴唇运动、头部位置和面部表情,以制造视觉上令人信服的效果。
在本文中,我们将讨论AniPortrait,一种旨在使用参考图像和音频样本生成高质量动画的新型框架。AniPortrait框架的工作分为两个阶段。首先,AniPortrait框架从音频样本中提取中间3D表示,并将其投影到2D面部标志点序列中。然后,框架使用强大的扩散模型和运动模块将标志点序列转换为时间上一致且照片级的动画。实验结果表明AniPortrait框架能够生成高质量动画,具有出色的视觉质量、姿势多样性和面部自然性,从而提供增强和丰富的感知体验。此外,AniPortrait框架在可控性和灵活性方面具有显著的潜力,可以有效地应用于面部重演、面部运动编辑等领域。本文旨在深入介绍AniPortrait框架,我们将探讨其机制、方法、架构以及与最先进框架的比较。让我们开始吧。
AniPortrait:照片级人像动画
创建逼真和富有表现力的肖像动画已成为研究人员的焦点,考虑到其令人难以置信的潜力和应用范围,从数字媒体和虚拟现实到游戏等。尽管经过多年的研究和开发,但生成高质量动画仍然是一个重大挑战,尤其是需要保持时间一致性和视觉上吸引人的效果。开发人员面临的一个主要障碍是需要精细地协调头部位置、视觉表达和嘴唇运动,以制造视觉上令人信服的效果。现有的方法未能解决这些挑战,主要是因为它们依赖于有限容量的生成器,如NeRF、基于运动的解码器和GAN,用于视觉内容创建。这些网络表现出有限的泛化能力,并且在生成高质量内容时不稳定。然而,扩散模型的最近出现促进了高质量图像的生成,一些基于扩散模型和时间模块的框架促进了令人信服的视频的创建,使扩散模型脱颖而出。
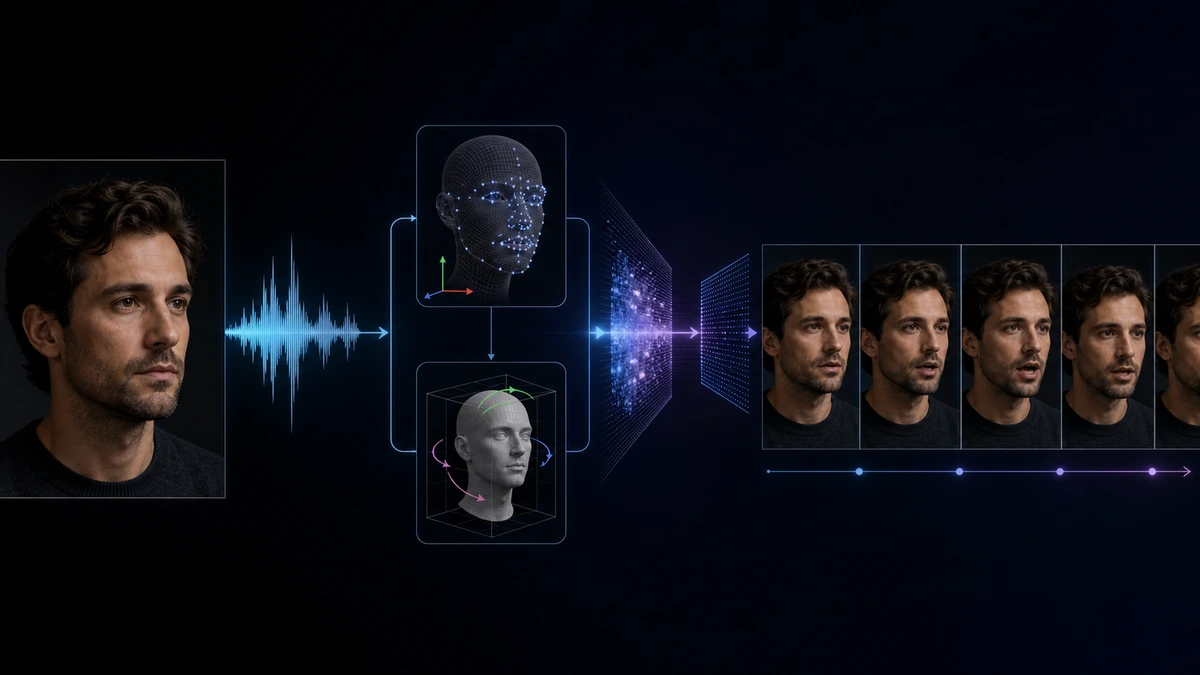
在扩散模型的进步基础上,AniPortrait框架旨在使用参考图像和音频样本生成高质量动画。AniPortrait框架的工作分为两个阶段。在第一个阶段,AniPortrait框架使用基于变换器的模型从音频输入中提取3D面部网格和头部姿势序列,并将其投影到2D面部标志点序列中。第一个阶段使AniPortrait框架能够从音频中捕捉嘴唇运动和细微表达,以及与音频样本的节奏同步的头部运动。第二阶段,AniPortrait框架使用强大的扩散模型和运动模块将面部标志点序列转换为照片级和时间上一致的动画。更具体地说,AniPortrait框架借鉴了AnimateAnyone模型的网络架构,该模型使用Stable Diffusion 1.5,一个强大的扩散模型,根据参考图像和身体运动序列生成逼真和流畅的动画。值得注意的是,AniPortrait框架没有使用AnimateAnyone框架中实现的姿势引导模块,而是重新设计了它,使AniPortrait框架不仅保持轻量级设计,还在生成嘴唇运动方面表现出增强的精度。
实验结果表明AniPortrait框架在创建具有出色面部自然性、视觉质量和姿势多样性的动画方面的优越性。通过使用3D面部表示作为中间特征,AniPortrait框架获得了修改这些表示以满足其需求的灵活性。这种适应性显著增强了AniPortrait框架在面部重演和面部运动编辑等领域的应用。
AniPortrait:工作原理和方法
所提出的AniPortrait框架由两个模块组成,即Lmk2Video和Audio2Lmk。Audio2Lmk模块尝试从音频输入中提取一系列标志点,以捕捉复杂的嘴唇运动和面部表情,而Lmk2Video模块使用此标志点序列生成具有时间一致性的高质量肖像视频,并保持与参考图像一致的外观。以下图表展示了AniPortrait框架的工作概述。如图所示,AniPortrait框架首先从音频中提取3D面部网格和头部姿势,并将这两个元素投影到2D关键点中。在第二阶段,框架使用扩散模型将2D关键点转换为具有两个阶段的肖像视频,在网络中同时训练。

Audio2Lmk
对于给定的语音片段序列,AniPortrait框架的主要目标是预测相应的3D面部网格序列,具有平移和旋转的矢量表示。AniPortrait框架使用预训练的wav2vec方法提取音频特征,该模型表现出高泛化能力,并能够从音频中准确识别语调和发音,这在生成逼真面部动画中起着至关重要的作用。通过利用获取的强大的语音特征,AniPortrait框架能够有效地使用一个简单的架构,包括两个全连接层,将这些特征转换为3D面部网格。AniPortrait框架观察到,这种简单的设计不仅增强了推理过程的效率,还确保了准确性。当将音频转换为姿势时,AniPortrait框架使用相同的wav2vec网络作为骨干,尽管该模型与音频到网格模块不共享权重。这主要是因为姿势与音频中的音调和节奏更相关,这与音频到网格任务有不同的强调。为了考虑前状态的影响,AniPortrait框架使用变换器解码器来解码姿势序列。在此过程中,框架使用跨注意力机制将音频特征集成到解码器中,并且对于两个模块,框架使用L1损失进行训练。一旦模型获得姿势和网格序列,AniPortrait框架使用透视投影将这些序列转换为2D面部标志点序列,然后将其用作下一阶段的输入信号。
Lmk2Video
对于给定的参考肖像图像和面部标志点序列,所提出的Lmk2Video模块创建一个时间上一致的肖像动画,该动画与标志点序列的运动一致,并保持与参考图像一致的外观,最后,框架将肖像动画表示为肖像帧序列。Lmk2Video的网络结构设计借鉴了现有的AnimateAnyone框架。AniPortrait框架使用Stable Diffusion 1.5,一个极其强大的扩散模型作为其骨干,并集成了一个时间运动模块,该模块有效地将多帧噪声输入转换为视频帧序列。同时,ReferenceNet网络组件反映了Stable Diffusion 1.5的结构,并使用它从参考图像中提取外观信息,并将其集成到骨干中。这种战略设计确保面部ID在整个输出视频中保持一致。不同于AnimateAnyone框架,AniPortrait框架增强了PoseGuider的设计复杂性。AnimateAnyone框架的原始版本仅包含几个卷积层,之后标志点特征与骨干的输入层合并。AniPortrait框架发现这种设计在捕捉嘴唇的复杂运动方面存在不足,并为了解决这个问题,框架采用了ConvNet架构的多尺度策略,并将对应尺度的标志点特征集成到骨干的不同块中。此外,AniPortrait框架引入了一个额外的改进,即包括参考图像的标志点作为额外输入。PoseGuider组件的跨注意力模块促进了每个帧的目标标志点和参考标志点之间的交互。这种过程为网络提供了额外的线索,以理解外观和面部标志点之间的相关性,从而有助于生成具有更精确运动的肖像动画。
AniPortrait:实现和结果
对于Audio2Lmk阶段,AniPortrait框架采用wav2vec2.0组件作为其骨干,并利用MediaPipe架构提取3D网格和6D姿势用于注释。模型从其内部数据集中获取Audio2Mesh组件的训练数据,该数据集包含大约60分钟的高质量语音数据,来源于单个演讲者。为了确保MediaPipe组件提取的3D网格稳定,语音演讲者被指示在整个录音过程中面对摄像头并保持稳定的头部位置。对于Lmk2Video模块,AniPortrait框架实现了一个两阶段的训练方法。在第一阶段,框架专注于训练ReferenceNet和PoseGuider,即骨干的2D组件,并排除运动模块。在第二步中,AniPortrait框架冻结所有其他组件,并专注于训练运动模块。对于这一阶段,框架使用两个大规模、高质量的面部视频数据集来训练模型,并使用MediaPipe组件处理所有数据以提取2D面部标志点。此外,为了增强网络对嘴唇运动的敏感性,AniPortrait模型在渲染2D标志点的姿势图像时使用不同的颜色区分上下嘴唇。
如以下图像所示,AniPortrait框架生成了一系列动画,展示了卓越的质量和真实性。

然后,框架使用中间的3D表示,可以编辑以操纵输出以满足要求。例如,用户可以从某个源提取标志点并改变其ID,从而允许AniPortrait框架创建面部重演效果。
最后的思考
在本文中,我们讨论了AniPortrait,一种旨在使用参考图像和音频样本生成高质量动画的新型框架。通过简单地输入参考图像和音频片段,AniPortrait框架能够生成具有自然头部运动和平滑嘴唇运动的肖像视频。通过利用扩散模型的强大泛化能力,AniPortrait框架生成的动画展示了令人印象深刻的真实图像质量和逼真的运动。AniPortrait框架的工作分为两个阶段。首先,AniPortrait框架从音频样本中提取中间的3D表示,并将其投影到2D面部标志点序列中。然后,框架使用强大的扩散模型和运动模块将标志点序列转换为时间上一致且照片级的动画。实验结果表明AniPortrait框架能够生成高质量动画,具有出色的视觉质量、姿势多样性和面部自然性,从而提供增强和丰富的感知体验。此外,AniPortrait框架在可控性和灵活性方面具有显著的潜力,可以有效地应用于面部重演、面部运动编辑等领域。


