
Nền tảng AI
K-Means Clustering là gì?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
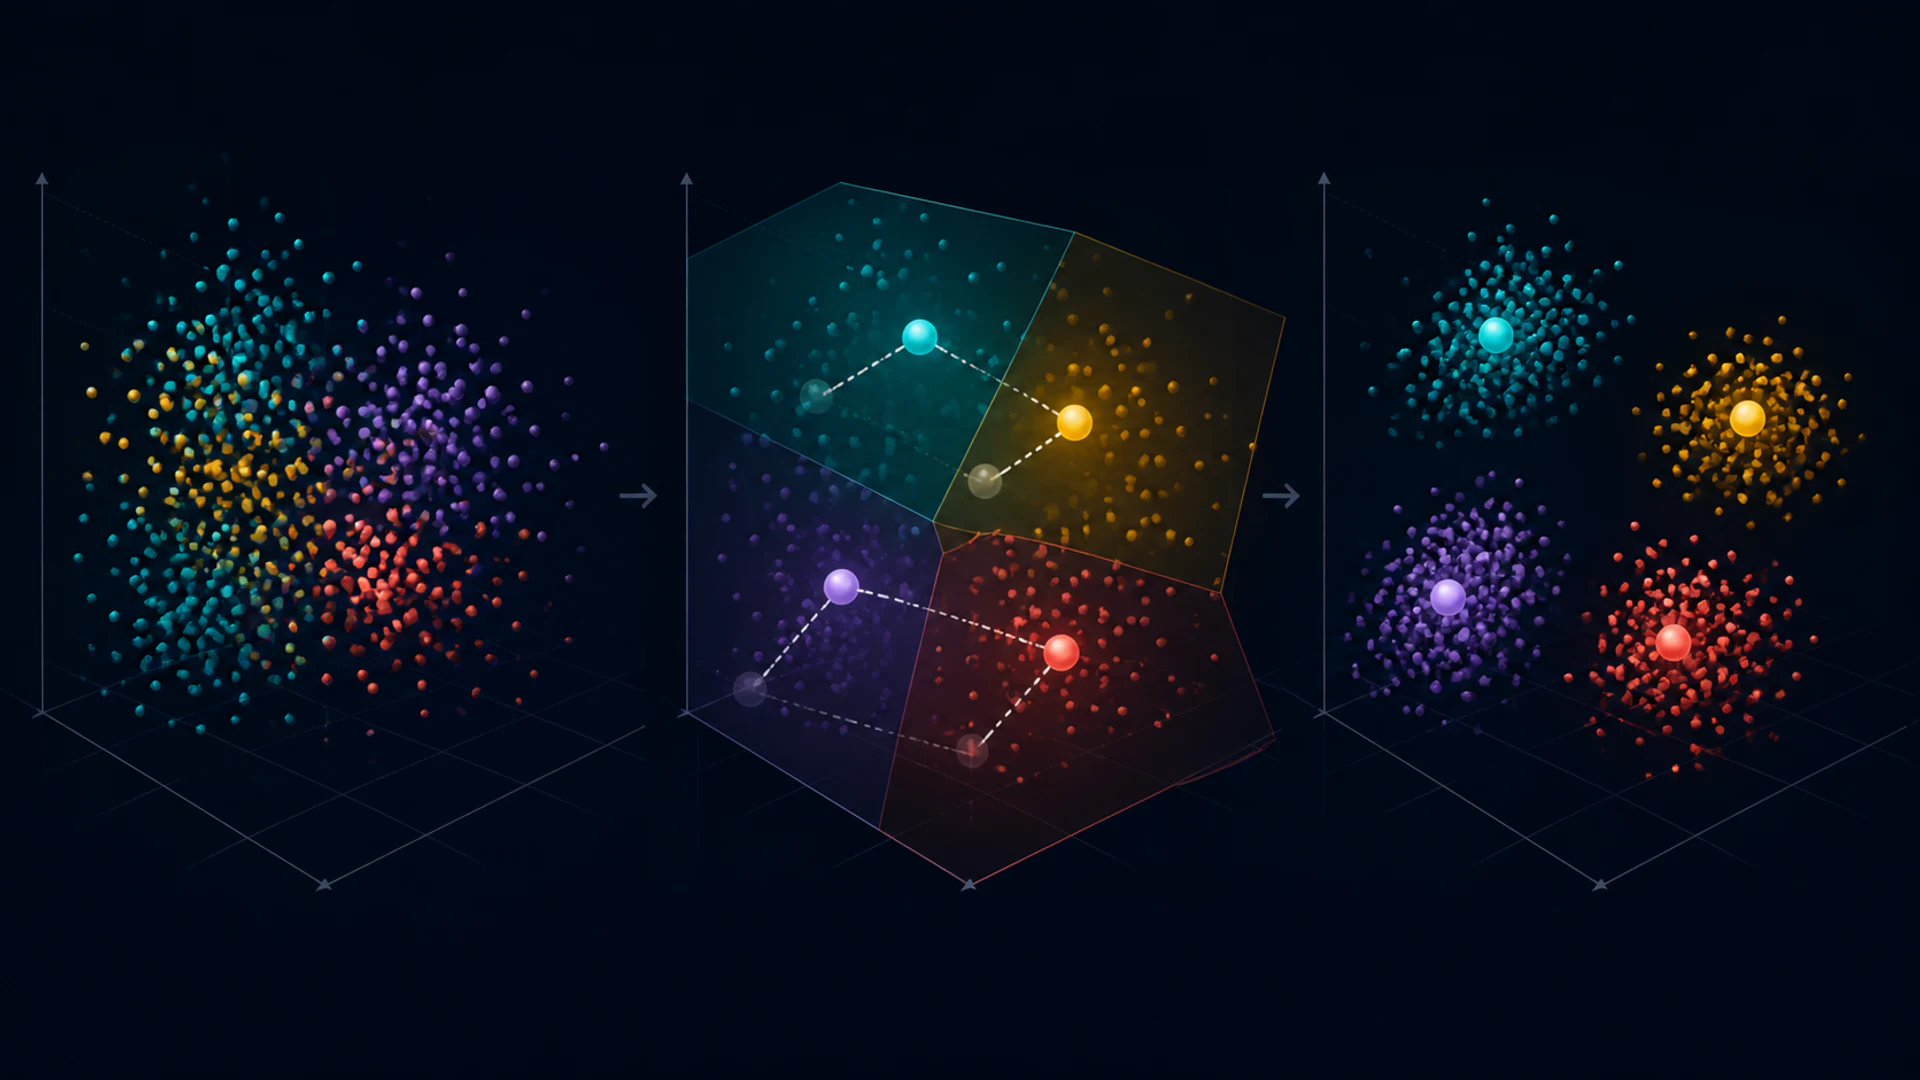
K-means là một thuật toán không giám sát, phân chia các quan sát số thành k cụm. Nó luân phiên giữa việc gán mỗi điểm cho trung tâm gần nhất và tính lại mỗi trung tâm dưới dạng trung bình của các điểm được gán cho nó.
Thuật toán này nhanh và hữu ích, nhưng kết quả của nó bị ảnh hưởng bởi việc chuẩn hoá, khoảng cách, khởi tạo và giá trị k được chọn. Một cụm là một phân hoạch toán học, không nhất thiết là một loại thực tế.
Những điểm chính
- K-means tối thiểu hoá khoảng cách Euclid bình phương trong mỗi cụm tới các trung tâm.
- Khởi tạo quan trọng; k-means++ phân bố các trung tâm khởi đầu và thường cải thiện kết quả.
- Chuẩn hoá các đặc trưng khi đơn vị hoặc thang đo của chúng cần đóng góp tương đương.
- K-means gặp khó khăn với các ngoại lệ, cụm không hình cầu, mật độ không đồng đều và dữ liệu phân loại.
Mục tiêu và vòng lặp cập nhật
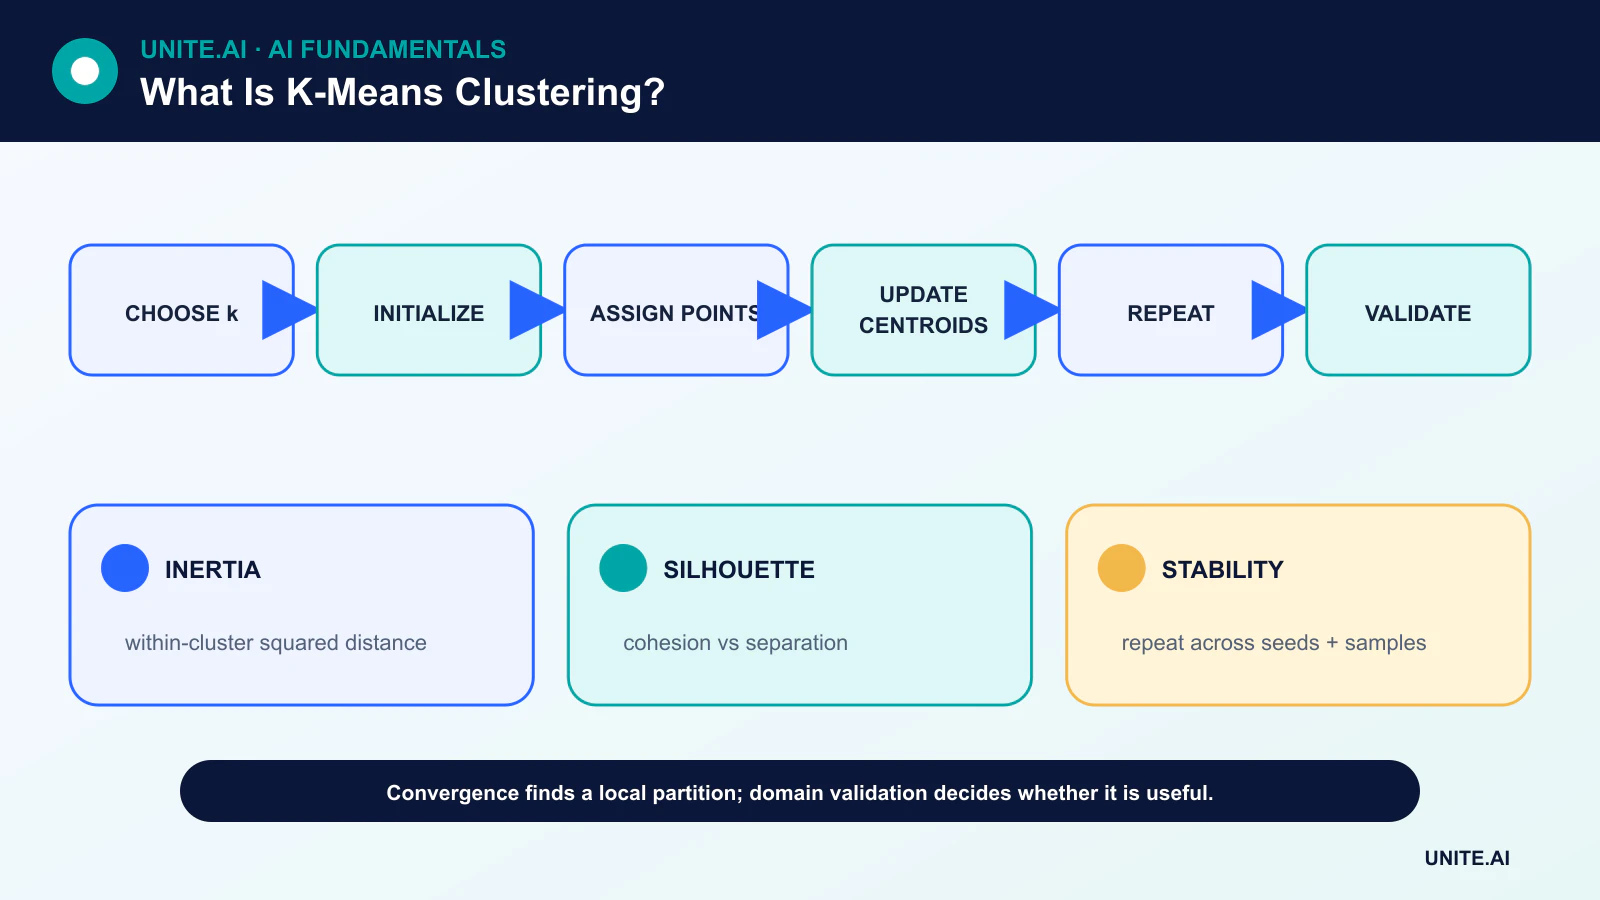
Với k trung tâm, bước gán sẽ gửi mỗi quan sát tới trung tâm gần nhất. Bước cập nhật thay thế mỗi trung tâm bằng trung bình của các quan sát được gán cho nó. Tổng bình phương trong mỗi cụm không thể tăng lên trong các bước này, do đó quá trình hội tụ tới một cực tiểu cục bộ.
Sự hội tụ không đảm bảo đạt được cực tiểu toàn cục. Các trung tâm khởi tạo khác nhau có thể dẫn đến các phân hoạch khác nhau, vì vậy các triển khai thường thực hiện nhiều khởi tạo và giữ lại giải pháp có độ lệch (inertia) thấp nhất.
Khởi tạo và k-means++
Việc chọn ngẫu nhiên tất cả các trung tâm khởi đầu từ một vùng dày đặc có thể tạo ra giải pháp kém hoặc làm chậm quá trình hội tụ. K-means++ chọn các hạt giống với xác suất liên quan đến khoảng cách từ các hạt giống đã có, khuyến khích phủ toàn bộ tập dữ liệu.
Việc chạy nhiều lần vẫn hữu ích. Ghi lại hạt giống ngẫu nhiên và số lần khởi tạo để có thể tái tạo kết quả.
Chuẩn hoá và khoảng cách
Khoảng cách Euclid bình phương khiến K-means nhạy cảm với đơn vị đo. Một đặc trưng đo bằng hàng nghìn có thể chi phối một đặc trưng đo trong khoảng từ 0 đến 1. Việc chuẩn hoá là phổ biến, nhưng kiến thức miền nên quyết định liệu độ lệch chuẩn bằng nhau có phản ánh tầm quan trọng bằng nhau hay không.
Các ngoại lệ có thể kéo trung bình ra xa các điểm điển hình. Việc chuẩn hoá mạnh mẽ, cắt bỏ hoặc các phương pháp dựa trên medoid có thể tốt hơn. Các đặc trưng phân loại one‑hot tạo ra một không gian khoảng cách có thể không phản ánh sự tương đồng của các danh mục.
Chọn k và xác thực các cụm
Độ lệch (inertia) giảm mỗi khi k tăng, vì vậy không thể dùng nó để chọn k một cách độc lập. Phương pháp “elbow” tìm kiếm sự cải thiện giảm dần. Phân tích silhouette so sánh mức độ gắn kết và tách rời. Độ ổn định qua các mẫu và hạt giống cung cấp một kiểm tra bổ sung.
Cách xác thực mạnh nhất là tính hữu ích trong miền mục tiêu. So sánh các cụm với kết quả đã biết, đánh giá của chuyên gia hoặc một nhiệm vụ downstream mà không giả vờ rằng các nhãn hậu kỳ được phát hiện một cách khách quan.
Giới hạn và các lựa chọn thay thế
K-means ưu tiên các nhóm gọn gàng, gần như hình cầu và có thang đo tương đồng. Các mô hình Gaussian mixture mô tả các thành phần hình elip xác suất; các phương pháp kiểu DBSCAN xác định các vùng dày đặc và nhiễu; phân cụm phân cấp tạo ra một cây các phép hợp nhất.
Giảm chiều dữ liệu có thể cải thiện tốc độ hoặc lọc nhiễu đầu vào, nhưng việc áp dụng nó trên toàn bộ tập dữ liệu có thể thay đổi câu hỏi xác thực. Mini-batch K-means giảm tính toán cho các tập dữ liệu lớn với chi phí là một cập nhật xấp xỉ.
Mục tiêu, khởi tạo và hội tụ
K-means phân chia các quan sát số thành k cụm bằng cách tối thiểu hoá khoảng cách Euclid bình phương trong mỗi cụm tới các trung tâm. Thuật toán Lloyd luân phiên gán mỗi điểm cho trung tâm gần nhất và tính lại các trung tâm cho đến khi các gán hoặc mục tiêu ổn định. Nó hội tụ tới một cực tiểu cục bộ, không nhất thiết là tốt nhất toàn cục. Khởi tạo k-means++ phân tán các trung tâm ban đầu và thường cải thiện kết quả, nhưng việc sử dụng nhiều hạt giống vẫn quan trọng. Chuẩn hoá các đặc trưng khi đơn vị cần đóng góp tương đương vì khoảng cách bình phương làm tăng ảnh hưởng của các biến có thang đo lớn và các ngoại lệ.
Phương pháp này giả định các cụm gần như gọn gàng, hình cầu và có thang đo tương đồng dưới không gian Euclid. Nó gặp khó khăn với các manifold dài, mật độ không đồng đều, dữ liệu phân loại, ngoại lệ nặng và cấu trúc lồng nhau. Các cụm rỗng và các điểm trùng lặp cần được xử lý rõ ràng. Mini-batch k-means mở rộng cho dữ liệu lớn với một sự đánh đổi xấp xỉ. Đối với văn bản thưa, k-means hình cầu dựa trên cosine có thể phù hợp hơn với hướng, trong khi các mô hình hỗn hợp, phương pháp mật độ, phân cụm phân cấp hoặc k-medoids mã hoá các giả định khác.
Chọn k và xác thực ý nghĩa
Đồ thị elbow, điểm silhouette, tiêu chí thông tin trong các mô hình liên quan và độ ổn định có thể gợi ý k, nhưng không có phương pháp nào phát hiện một số k duy nhất đúng. Tính hữu ích trong kinh doanh và cách diễn giải miền là quan trọng. Tái huấn luyện qua các mẫu và hạt giống, so sánh sự di chuyển của trung tâm và tính nhất quán của việc gán, và xác thực các cụm trên các kết quả độc lập không được dùng để tạo chúng. Việc chiếu hai chiều có thể làm méo mó sự tách rời, vì vậy cần xem xét khoảng cách và ví dụ trong không gian biểu diễn gốc hoặc đã được xác thực.
Các cụm là các nhóm mô tả được tạo ra bởi các đặc trưng và metric đã chọn; chúng không phải là các loại tự nhiên hay các phân đoạn nguyên nhân. Các hồ sơ dựa trên cùng các biến được dùng để phân cụm có thể vòng lặp. Hãy sử dụng các thuộc tính giữ lại và đánh giá định tính, và kiểm tra xem các cụm có chủ yếu tái tạo địa lý, nguồn dữ liệu, hay các đặc tính nhạy cảm hay không. Các cụm nhỏ có thể là ngoại lệ hoặc hiện tượng phụ. Đặt tên cho một cụm không đồng nghĩa với việc mọi thành viên đều phù hợp với nhãn.
Triển khai và bảo trì
Lưu trữ thông tin chuẩn hoá, thứ tự đặc trưng, các trung tâm, định nghĩa khoảng cách và nhãn cụm cùng nhau. Đối với các điểm mới, giám sát khoảng cách tới trung tâm được gán và tỷ lệ các điểm vượt quá phạm vi huấn luyện; cung cấp trạng thái không xác định thay vì ép buộc mọi trường hợp vào một cụm. Theo dõi kích thước cụm, trung tâm và mức độ liên quan đến kết quả theo thời gian. Việc tái huấn luyện thay đổi danh tính cụm, vì vậy hãy ánh xạ hoặc phiên bản các quy tắc downstream thay vì lặng lẽ sử dụng lại các tên cũ. K-means là một nền tảng nén và phân đoạn hữu ích khi hình học của nó phù hợp với câu hỏi, không phải là công cụ khám phá toàn diện.
Ví dụ thực tế: phân đoạn khách hàng bằng k-means
Một công ty dịch vụ đăng ký chuẩn hoá các đặc trưng sử dụng trong một khoảng thời gian cố định, loại bỏ các định danh tài khoản, và thử nghiệm các giá trị k với nhiều hạt giống. Độ ổn định, silhouette và các kết quả kinh doanh giữ lại được xem xét, nhưng các nhóm sản phẩm cũng kiểm tra các tài khoản đại diện và biên. Họ phát hiện một cụm chỉ là khách hàng mới với thời gian quan sát ngắn hơn, vì vậy thời gian sử dụng được xử lý một cách rõ ràng. K-means được so sánh với các lựa chọn thay thế phân cấp và dựa trên mật độ thay vì giả định phù hợp. Bài tập này được coi là học không giám sát, không phải khám phá nhãn.
Các phân đoạn hướng dẫn nghiên cứu và các thí nghiệm truyền thông, không phải tiêu chuẩn đủ điều kiện hoặc giá cả. Các tài khoản mới nằm xa mọi trung tâm nhận được một gán không xác định. Các chuẩn hoá, đặc trưng, trung tâm và tên được phiên bản hoá, và việc tái huấn luyện chỉ ánh xạ các cụm mới sang cũ khi có bằng chứng. Giám sát theo dõi kích thước cụm, khoảng cách và mức độ liên quan đến kết quả. Các thuộc tính nhạy cảm và các đại diện được kiểm toán, và nhóm tránh mô tả các cụm như các loại tính cách tự nhiên khi chúng chỉ là các phân hoạch toán học của hành vi đã chọn.
Bằng chứng triển khai và sẵn sàng vận hành
Một quyết định triển khai cần hơn một buổi trình diễn thành công. Xác định người dùng mục tiêu, môi trường vận hành, đầu vào, đầu ra, các phụ thuộc, người chịu trách nhiệm và hậu quả của mỗi lỗi quan trọng. Thiết lập một nền tảng có thể tái tạo và một bộ đánh giá có phiên bản trước khi tinh chỉnh. Kiểm tra các trường hợp thường, điều kiện biên, đầu vào sai định dạng hoặc thiếu, sự dịch chuyển phân phối, mất kết nối phụ thuộc, lạm dụng, và các nhóm hoặc môi trường có khả năng bị thiếu dịch vụ. Đo lường chất lượng nhiệm vụ cùng với hiệu chuẩn hoặc độ không chắc, độ trễ, thông lượng, chi phí tài nguyên, khả năng tiếp cận, quyền riêng tư và bảo mật. Ghi lại mọi chuyển đổi và ngưỡng để một người đánh giá độc lập có thể tái tạo kết quả và phân biệt bằng chứng với một nguyên mẫu hấp dẫn.
Trước khi ra mắt, chỉ định quyền chịu trách nhiệm cho việc phát hành, ngoại lệ, thay đổi, quay lại và ngừng sử dụng. Sử dụng triển khai theo giai đoạn, duy trì một dự phòng an toàn, và xác minh giám sát bằng các lỗi được chèn có chủ đích. Dữ liệu đo lường vận hành nên tiết lộ chất lượng đầu vào, hành vi đầu ra, phiên bản mô hình hoặc quy tắc, tình trạng phụ thuộc, can thiệp của con người và các kết quả đã xác nhận mà không thu thập dữ liệu nhạy cảm không cần thiết. Xác định ngưỡng cảnh báo và người chịu trách nhiệm phản hồi, sau đó xem xét bằng chứng thực tế sau khi triển khai thay vì giả định hiệu suất ngoại tuyến sẽ kéo dài. Đánh giá lại bất cứ khi nào nguồn dữ liệu, người dùng, mô hình, nhà cung cấp, chính sách, phần cứng hoặc mục tiêu thay đổi. Một hệ thống được duy trì cũng cần có quy trình khôi phục, học từ sự cố, xóa và lưu trữ tài liệu, và một điểm rõ ràng khi nó nên bị vô hiệu hoá hoặc thay thế.
Câu hỏi thường gặp
K-means là thuật toán giám sát hay không giám sát?
Nó là không giám sát vì chỉ nhận các đặc trưng và số lượng cụm đã chọn, không có nhãn mục tiêu.
K-means có phân loại dữ liệu mới không?
Sau khi huấn luyện, một điểm mới có thể được gán cho trung tâm gần nhất. Đó là việc gán cụm, không nhất thiết là dự đoán lớp có giám sát.
Tài liệu tham khảo chính












