Nền tảng AI
Học có giám sát vs Học không giám sát

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
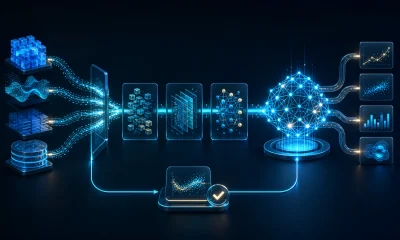
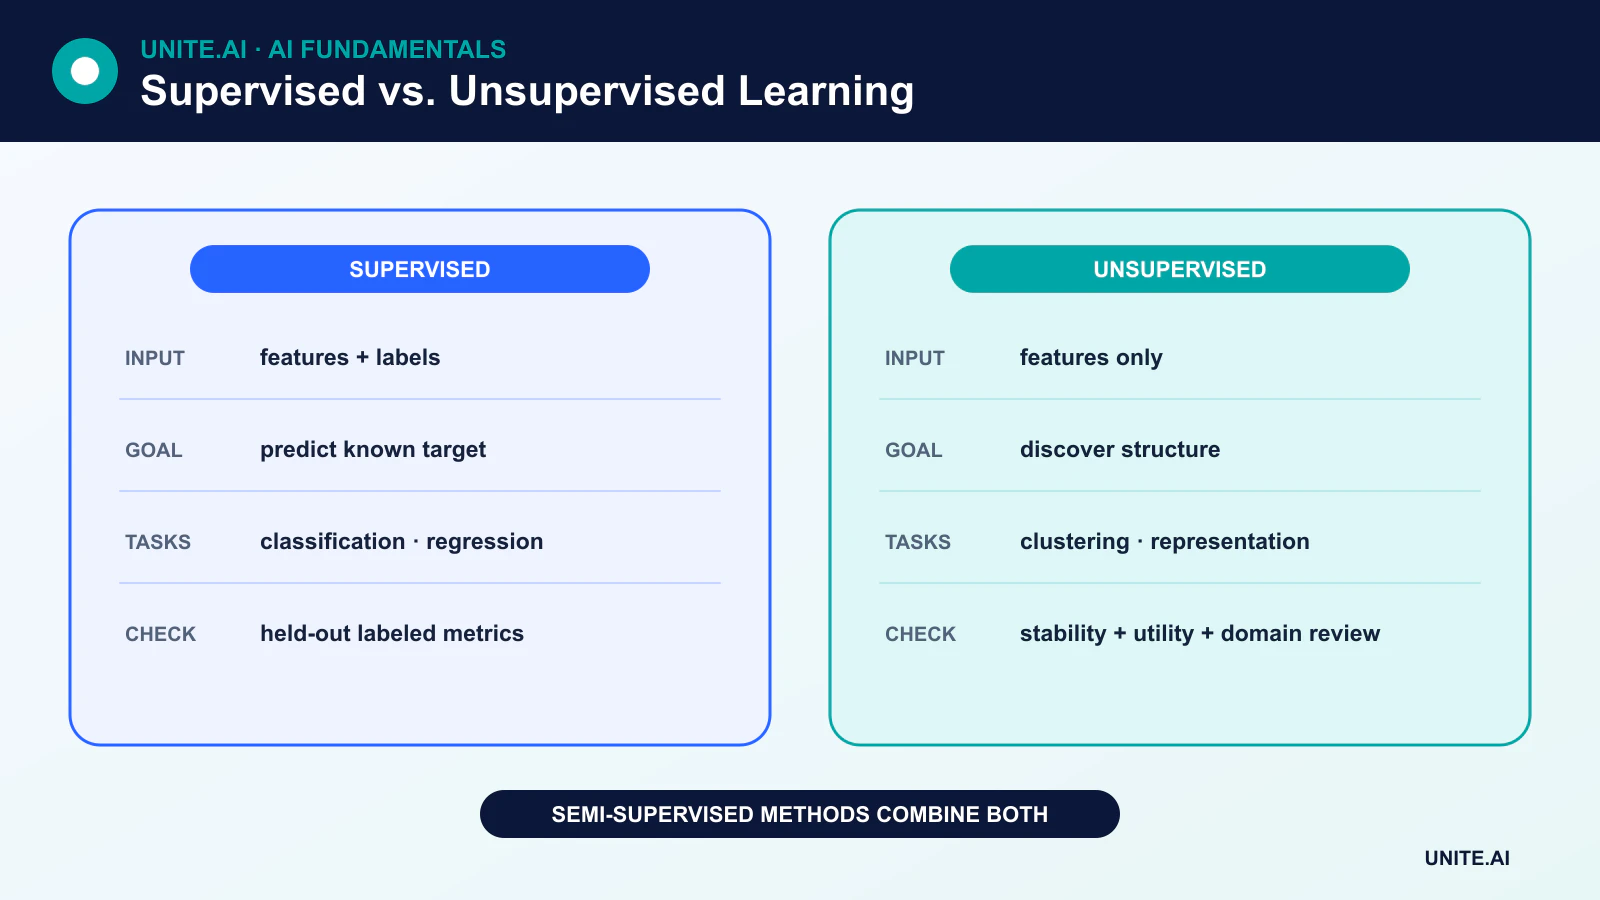
Học có giám sát học từ các ví dụ đi kèm với câu trả lời mục tiêu. Học không giám sát tìm kiếm cấu trúc trong dữ liệu mà không có nhãn mục tiêu. Sự khác biệt không phải là phương pháp nào thông minh hoặc chính xác hơn; mà là loại tín hiệu học có sẵn và câu hỏi mà hệ thống được thiết kế để trả lời.
Đây là hai mô hình chính trong học máy, nhưng các hệ thống hiện đại cũng sử dụng học bán giám sát, học tự giám sát và học tăng cường.
Những điểm chính
- Học có giám sát dự đoán một mục tiêu đã biết; học không giám sát khám phá các mẫu hoặc biểu diễn.
- Phân loại và hồi quy là các nhiệm vụ có giám sát; phân cụm, ước lượng mật độ và nhiều phương pháp giảm chiều là không giám sát.
- Kết quả của học không giám sát không tự động là các lớp thực tế và có thể khó đánh giá hơn.
- Chi phí tính toán và độ chính xác phụ thuộc vào thuật toán, dữ liệu, nhiệm vụ và cách đánh giá — không chỉ dựa trên mô hình.
Cách hoạt động của học có giám sát
Một bộ dữ liệu có giám sát chứa các đặc trưng X và một mục tiêu y. Quá trình huấn luyện điều chỉnh mô hình sao cho dự đoán của nó gần với các mục tiêu. Đánh giá sử dụng các ví dụ có nhãn được giữ lại để ước tính khả năng tổng quát của mô hình.
Phân loại
Phân loại dự đoán một danh mục: thư rác hay không, một chủ đề tài liệu trong số nhiều, hoặc một hoặc nhiều đối tượng trong hình ảnh. Các chỉ số liên quan bao gồm độ chính xác (precision), độ thu hồi (recall), F1, hiệu chuẩn và các biện pháp nhạy cảm với chi phí. Độ chính xác có thể gây hiểu lầm khi một lớp hiếm; ma trận nhầm lẫn cho thấy các lớp nào bị nhầm lẫn.
Hồi quy
Hồi quy dự đoán một giá trị liên tục, chẳng hạn nhu cầu, thời gian hoặc nhiệt độ. Hồi quy tuyến tính có thể sử dụng một hoặc nhiều đặc trưng; nó không chỉ giới hạn ở việc vẽ mối quan hệ giữa hai biến. Các chỉ số hồi quy bao gồm sai số tuyệt đối trung bình, căn bậc hai của sai số bình phương trung bình và chi phí đặc thù cho nhiệm vụ.
Các thuật toán có giám sát phổ biến
Các phương pháp có giám sát bao gồm mô hình tuyến tính và logistic, cây quyết định, rừng ngẫu nhiên, tăng cường gradient, máy vector hỗ trợ, K-nearest neighbors và mạng nơ-ron.
Hồi quy logistic tạo ra một điểm số hoặc xác suất có thể chuyển thành lớp bằng ngưỡng đã chọn. Một nút lá của cây quyết định chứa dự đoán dựa trên một vùng của không gian đặc trưng, không nhất thiết là một quan sát huấn luyện duy nhất. KNN dự đoán dựa trên các ví dụ huấn luyện có nhãn gần nhất và vẫn yêu cầu một thiết kế huấn luyện/đánh giá/kiểm tra hợp lý.
Cách hoạt động của học không giám sát
Học không giám sát nhận các đặc trưng mà không có cột mục tiêu. Mục tiêu của nó được định nghĩa một cách gián tiếp — ví dụ, giảm thiểu khoảng cách trong các cụm, tái tạo đầu vào, ước lượng mật độ dữ liệu, hoặc giữ lại càng nhiều phương sai càng tốt trong ít chiều hơn.
Phân cụm
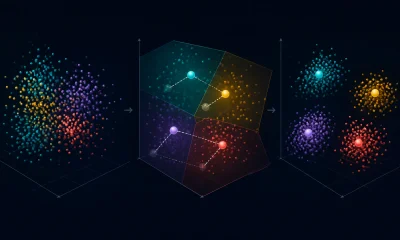
K-means gán các điểm vào một số cụm đã chọn và cập nhật trung tâm cụm để giảm khoảng cách bình phương trong cùng một cụm. Thuật toán khám phá các nhóm hình học dựa trên một khoảng cách và biểu diễn đặc trưng nhất định. Các nhóm này không tự động tương ứng với các loại khách hàng, chẩn đoán hoặc nhãn miền có ý nghĩa.
Giảm chiều
Giảm chiều biểu diễn dữ liệu bằng ít biến hơn. Phân tích thành phần chính (PCA) tìm các hướng trực giao giữ lại càng nhiều phương sai càng tốt dưới một phép chiếu tuyến tính. Các phương pháp khác bảo tồn các khái niệm cấu trúc khác nhau và có thể tạo ra những hình ảnh trực quan rất khác nhau.
Phát hiện bất thường và ước lượng mật độ
Các phương pháp không giám sát có thể ước lượng nơi dữ liệu dày đặc và đánh dấu các quan sát bất thường. Điểm bất thường không chứng minh gian lận, lỗi hay hành vi độc hại; nó chỉ xác định một sự lệch lạc dựa trên biểu diễn và mô hình đã chọn.
Cách đánh giá học không giám sát
Không có khái niệm “độ chính xác” chung cho học không giám sát. Người thực hành có thể sử dụng các chỉ số nội bộ như silhouette score, so sánh độ ổn định giữa các mẫu, kiểm tra tính hữu ích trong một nhiệm vụ hạ lưu, hoặc hỏi các chuyên gia miền liệu cấu trúc được khám phá có ý nghĩa hay không. Nếu có nhãn thực tế để đánh giá, các chỉ số phân cụm bên ngoài có thể được dùng mà không biến quá trình huấn luyện thành học có giám sát.
Vượt ra ngoài so sánh hai chiều
Học bán giám sát
Học bán giám sát kết hợp một tập dữ liệu có nhãn nhỏ hơn với một tập dữ liệu không nhãn lớn hơn. Gán nhãn giả, chuẩn hoá nhất quán và các phương pháp dựa trên đồ thị là những ví dụ. Dữ liệu không nhãn vẫn phải giống với phân phối mục tiêu đủ gần để hỗ trợ.
Học tự giám sát
Học tự giám sát tạo ra các mục tiêu từ chính đầu vào, như dự đoán các token bị ẩn hoặc ghép các góc nhìn đã biến đổi. Đây là nền tảng cho các mô hình ngôn ngữ, thị giác và đa phương tiện hiện đại, bao gồm cả transformers.
Học tăng cường
Học tăng cường tối ưu hoá quyết định thông qua phần thưởng được tạo ra từ tương tác. Nó khác biệt so với cả dự đoán có nhãn và khám phá mẫu tĩnh.
Lựa chọn cách tiếp cận phù hợp
Bắt đầu với quyết định hoặc hiểu biết mà hệ thống phải tạo ra. Nếu có các mục tiêu đáng tin cậy và mục tiêu là dự đoán, học có giám sát là lựa chọn tự nhiên. Nếu mục tiêu là khám phá, biểu diễn hoặc nhóm, một phương pháp không giám sát có thể phù hợp. Khi nhãn khan hiếm, tiền huấn luyện tự giám sát hoặc bán giám sát sau đó đánh giá có giám sát có thể hiệu quả hơn.
Trong mọi trường hợp, rò rỉ dữ liệu, mẫu lệch, proxy yếu và sự thay đổi phân phối có thể quyết định lựa chọn thuật toán. Một mô hình kỹ thuật đúng nhưng được huấn luyện với mục tiêu sai vẫn có thể thất bại.
Tín hiệu học, mục tiêu và các phương pháp tiêu biểu
Học có giám sát sử dụng các ví dụ đi kèm với nhãn hoặc giá trị mục tiêu và tối ưu hoá lỗi dự đoán. Phân loại, hồi quy, xếp hạng và dự đoán có cấu trúc khác nhau về đầu ra và hàm mất mát. Học không giám sát tìm kiếm cấu trúc mà không có nhãn mục tiêu thông qua phân cụm, ước lượng mật độ, giảm chiều, học biểu diễn hoặc mô hình sinh. Học tự giám sát tạo ra các mục tiêu dự đoán từ chính dữ liệu, trong khi học bán giám sát kết hợp một tập có nhãn nhỏ với dữ liệu không nhãn lớn hơn. Những danh mục này mô tả tín hiệu học; cùng một kiến trúc nơ-ron có thể được huấn luyện dưới nhiều mô hình khác nhau.
Nhãn làm cho mục tiêu trở nên rõ ràng nhưng đồng thời mang lại chi phí chú thích, nhiễu, giả định chính sách và độ trễ thời gian. Dữ liệu không nhãn dễ thu thập hơn nhưng không cho thuật toán biết cấu trúc nào được khám phá là hữu ích. Một cụm có thể phản ánh ánh sáng, độ dài tài liệu hoặc nguồn thu thập thay vì một danh mục có ý nghĩa. Định nghĩa đánh giá một cách độc lập: các mô hình có giám sát sử dụng kết quả có nhãn được giữ lại, trong khi các mô hình không giám sát cần độ ổn định, tái tạo, khả năng xảy ra, truy xuất, tính hữu dụng hạ lưu hoặc xác nhận của chuyên gia. Phân tách trực quan một mình không chứng minh cấu trúc hợp lệ.
Lựa chọn mô hình và ngăn ngừa các lỗi thường gặp
Sử dụng học có giám sát khi có mục tiêu ổn định và nhãn đại diện. Sử dụng khám phá không giám sát để tóm tắt, phát hiện mới lạ, nén hoặc tạo giả thuyết, nhưng coi kết quả là tạm thời. Tiền huấn luyện tự giám sát có giá trị khi dữ liệu thô phong phú và các nhiệm vụ hạ lưu chia sẻ biểu diễn. Các phương pháp bán giám sát chỉ hữu ích khi các giả định về dữ liệu không nhãn và cấu trúc lớp đúng. So sánh với các baseline đơn giản và tính đến tổng chi phí thu thập, gán nhãn, rà soát, tính toán và lỗi thay vì cho rằng dữ liệu không nhãn luôn rẻ.
Ngăn ngừa rò rỉ bằng cách tách các thực thể liên quan trước khi tạo nhãn, tăng cường hoặc gán nhãn giả. Giám sát cân bằng lớp, sự đồng thuận chú thích, độ ổn định cụm, sự sụp đổ và trôi dạt. Nhãn giả có thể củng cố các sai lầm ban đầu; phân cụm có thể mã hoá các thuộc tính nhạy cảm; biểu diễn đã tiền huấn luyện có thể truyền tải thiên vị nguồn. Đánh giá của con người nên tập trung vào các trường hợp biên và hậu quả. Trong môi trường sản xuất, ghi lại cách tín hiệu học được tạo ra và thời điểm nó trở nên lỗi thời. Mô hình quyết định nơi giám sát được đưa vào hệ thống, không phải việc các lựa chọn và giá trị của con người có tồn tại hay không.
Ví dụ thực tế: khám phá và gán nhãn các chủ đề hỗ trợ
Một công ty đầu tiên sử dụng các embedding và phân cụm không giám sát để khám phá các chủ đề trong các tin nhắn hỗ trợ đã được ẩn danh. Các nhà phân tích kiểm tra các ví dụ đại diện và biên và nhận thấy một số cụm phản ánh độ dài tin nhắn và kênh truyền thay vì các vấn đề. Họ xây dựng một phân loại có giám sát với một lớp không xác định, hướng dẫn chú thích và đo lường mức độ đồng thuận. Một bộ phân loại sau đó được đánh giá trên các khoảng thời gian, ngôn ngữ và sản phẩm sau này so với các baseline dựa trên từ khóa và k-nearest neighbor.
Các tin nhắn mới không nhãn hỗ trợ việc phát hiện drift nhưng không tự động huấn luyện lại bộ phân loại. Các người đánh giá gán nhãn cho các trường hợp không chắc chắn và mới nổi được chọn thông qua học chủ động, kèm kiểm tra chất lượng và một bộ đánh giá đóng. Việc giám sát theo dõi mức độ phổ biến của chủ đề, độ tin cậy, bất đồng và kết quả định tuyến. Khi một sản phẩm mới ra mắt, phân loại và năng lực của các đội hạ lưu được cập nhật đồng thời. Quy trình làm việc sử dụng các phương pháp không giám sát để tạo giả thuyết và bằng chứng có giám sát cho việc định tuyến vận hành.
Bằng chứng triển khai và sẵn sàng vận hành
Một quyết định triển khai cần hơn một buổi trình diễn thành công. Xác định người dùng mục tiêu, môi trường hoạt động, đầu vào, đầu ra, các phụ thuộc, người chịu trách nhiệm và hậu quả của mỗi lỗi quan trọng. Thiết lập một baseline có thể tái tạo và một bộ đánh giá có phiên bản trước khi tinh chỉnh. Kiểm tra các trường hợp thường, điều kiện biên, đầu vào sai dạng hoặc thiếu, sự thay đổi phân phối, mất kết nối phụ thuộc, lạm dụng, và các nhóm hoặc môi trường có khả năng bị thiếu phục vụ. Đo lường chất lượng nhiệm vụ cùng với hiệu chuẩn hoặc độ không chắc, độ trễ, thông lượng, chi phí tài nguyên, khả năng tiếp cận, quyền riêng tư và bảo mật. Ghi lại mọi biến đổi và ngưỡng để một người đánh giá độc lập có thể tái tạo kết quả và phân biệt bằng chứng với một nguyên mẫu hấp dẫn.
Trước khi ra mắt, chỉ định quyền chịu trách nhiệm cho việc phát hành, ngoại lệ, thay đổi, quay lại và ngừng sử dụng. Sử dụng triển khai theo giai đoạn, duy trì một dự phòng an toàn và xác minh việc giám sát bằng các lỗi được đưa vào cố ý. Dữ liệu đo lường vận hành nên tiết lộ chất lượng đầu vào, hành vi đầu ra, phiên bản mô hình hoặc quy tắc, tình trạng phụ thuộc, can thiệp của con người và kết quả đã xác nhận mà không thu thập dữ liệu nhạy cảm không cần thiết. Định nghĩa ngưỡng cảnh báo và người chịu trách nhiệm phản hồi, sau đó xem xét bằng chứng thực tế sau khi triển khai thay vì cho rằng hiệu suất ngoại tuyến sẽ kéo dài. Đánh giá lại mỗi khi nguồn dữ liệu, người dùng, mô hình, nhà cung cấp, chính sách, phần cứng hoặc mục tiêu thay đổi. Một hệ thống được duy trì cũng cần có tài liệu phục hồi, học từ sự cố, quy trình xóa và lưu trữ, và một điểm rõ ràng khi nó nên bị tắt hoặc thay thế.
Tài liệu tham khảo chính