
Nền tảng AI
Nhận dạng Giọng nói Đối thoại (CSR) là gì?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Nhận dạng giọng nói đối thoại (CSR) mở rộng khả năng nhận dạng giọng nói tự động (ASR) vượt ra ngoài việc sao chép riêng lẻ bằng cách sử dụng ngữ cảnh hội thoại, tín hiệu luân phiên lượt nói, thông tin người nói và xử lý độ trễ thấp. Mục tiêu là hỗ trợ một tương tác trực tiếp trong đó từ ngữ, thời gian, các gián đoạn và các lượt nói trước đều quan trọng.
CSR là một nhãn hiệu sản phẩm và nghiên cứu đang nổi lên, không phải là một lớp mô hình tiêu chuẩn duy nhất. Một hệ thống mạnh mẽ kết hợp ASR phát luồng với việc xác định điểm kết thúc, xử lý người nói, mô hình ngôn ngữ ngữ cảnh, trạng thái hội thoại và chính sách phản hồi, sau đó đánh giá trải nghiệm từ đầu đến cuối.
Những điểm chính
- Nhận dạng phát luồng phát ra các giả thuyết tạm thời và sửa đổi chúng khi có thêm âm thanh.
- Việc xác định điểm kết thúc và dự đoán lượt nói là các yếu tố riêng biệt so với độ chính xác của bản sao.
- Lịch sử hội thoại và các từ khóa nóng có thể cải thiện nhận dạng nhưng cũng có thể lan truyền các lỗi trước đó.
- Đánh giá độ trễ, các gián đoạn, người nói, giọng địa phương, tiếng ồn, quyền riêng tư và việc hoàn thành nhiệm vụ — không chỉ dựa vào tỷ lệ lỗi từ.
Từ ASR tới hội thoại trực tiếp
ASR truyền thống chuyển âm thanh thành văn bản. Một hệ thống đối thoại phải quyết định khi nào lắng nghe, khi nào một lượt nói kết thúc, liệu giọng nói có hướng tới hệ thống hay không, và cách phục hồi khi bản sao hoặc phản hồi của nó sai.
Các mô hình phát luồng xử lý các khung một cách tăng dần và tạo ra các bản sao một phần. Độ trễ thấp cải thiện khả năng phản hồi, nhưng việc cam kết quá sớm có thể làm tăng số lần sửa đổi hoặc lỗi. Ứng dụng cần một chính sách để phân biệt giữa văn bản ổn định và tạm thời.
Luân phiên lượt nói, chồng chéo và người nói
Thời lượng im lặng một mình là một tín hiệu kết thúc yếu. Hoàn thành từ vựng, ngữ điệu, thời gian, ánh mắt và trạng thái hội thoại có thể giúp dự đoán liệu một người đang giữ hay nhường quyền nói. Tính năng can thiệp (barge-in) cho phép người dùng ngắt lời giọng tổng hợp mà không mất ngữ cảnh.
Các giọng nói chồng chéo và việc phân đoạn người nói vẫn còn khó khăn. Hệ thống nên duy trì sự không chắc chắn về người nói, tránh gán một câu phát biểu cho người sai, và cung cấp một con đường sửa lỗi — đặc biệt đối với các hồ sơ được sử dụng trong y tế, tài chính hoặc công việc pháp lý.
Nhận dạng ngữ cảnh
Các lượt nói trước có thể làm rõ ràng các tên và tham chiếu; danh sách từ khóa nóng có thể làm lệch nhận dạng về phía các thuật ngữ chuyên ngành. Các mô hình ngôn ngữ giọng nói có thể mã hoá ngữ cảnh âm thanh và văn bản trong một khung đề xuất hoặc cơ chế chú ý chung.
Ngữ cảnh cũng có thể củng cố một bản sao sai trước đó hoặc rò rỉ thông tin giữa các phiên. Hạn chế lịch sử chỉ cho mục đích hiện tại, tách biệt siêu dữ liệu đáng tin cậy khỏi giọng nói của người dùng, và sử dụng ngữ cảnh transformer với các quy tắc lưu trữ và truy cập rõ ràng.
Đánh giá và triển khai có trách nhiệm
Báo cáo tỷ lệ lỗi từ trong phát luồng, độ trễ token đầu tiên và thời gian hoàn thiện, tỷ lệ sửa đổi, lỗi điểm kết thúc, thành công của can thiệp (barge-in), việc gán người nói, và hoàn thành nhiệm vụ. Kiểm tra các micro thực tế, tiếng ồn, giọng địa phương, chuyển đổi ngôn ngữ, khuyết tật và giọng nói chứa cảm xúc.
Dữ liệu giọng nói có thể xác định hoặc tiết lộ thông tin nhạy cảm. Áp dụng sự đồng ý, giảm thiểu, mã hoá, giới hạn thời gian lưu trữ và kiểm duyệt con người. Kết nối các phản hồi được tạo ra với các biện pháp kiểm soát an toàn của chatbot, vì bản sao chính xác không đồng nghĩa với việc phản hồi đúng hoặc được ủy quyền.
Từ đầu vào âm học tới trạng thái hội thoại
Một hệ thống giọng nói đối thoại ghi lại âm thanh, áp dụng xử lý tín hiệu, phát hiện giọng nói, nhận dạng từ hoặc đơn vị ngữ nghĩa, xác định người nói khi cần và cập nhật trạng thái hội thoại. Các hệ thống phát luồng tạo ra các giả thuyết một phần trước khi câu nói kết thúc. Các giả thuyết này có thể thay đổi, vì vậy các thành phần hạ nguồn phải phân biệt giữa kết quả tạm thời và cuối cùng.
Phát hiện hoạt động giọng nói và xác định điểm kết thúc quyết định khi nào giọng nói bắt đầu và khi người dùng đã hoàn thành. Ngưỡng im lặng cố định không hiệu quả với người nói chậm, tiếng ồn nền và các khoảng dừng suy nghĩ. Các mô hình luân phiên lượt nói có thể sử dụng từ ngữ, ngữ điệu, ánh mắt và ngữ cảnh hội thoại, nhưng chúng phải cân bằng phản hồi nhanh với việc không cắt ngang người nói.
Phân đoạn người nói trả lời câu hỏi ai đã nói khi nào; nhận dạng người nói ước tính danh tính; tách nguồn tách riêng các giọng nói chồng chéo. Đây là các nhiệm vụ khác nhau với các rủi ro khác nhau. Trong các cuộc họp, y tế và dịch vụ khách hàng, việc gán đúng từ cho đúng người có thể quan trọng ngang mức độ lỗi từ của bản sao.
Ngữ cảnh, chồng chéo, cảm xúc và phục hồi tương tác
Ngữ cảnh đối thoại giải quyết các đại từ, dấu chấm lửng, sửa chữa, thuật ngữ chuyên ngành và các tham chiếu tới các lượt nói trước. Một hệ thống có thể kết hợp bằng chứng âm thanh với lịch sử hội thoại và kiến thức truy xuất, nhưng ngữ cảnh trước cũng có thể làm lệch nhận dạng về phía một kỳ vọng sai. Bảo tồn bằng chứng âm thanh và độ tin cậy để ngữ cảnh không âm thầm ghi đè lên sự không chắc chắn.
Đối thoại tự nhiên bao gồm các phản hồi ngắn, gián đoạn, khởi đầu sai, tiếng cười, chuyển đổi ngôn ngữ và nói đồng thời. Một tác nhân phản hồi cần xử lý can thiệp (barge-in): dừng hoặc giảm âm lượng đầu ra, ghi lại lời nói mới của người dùng, quyết định liệu gián đoạn có thay đổi ý định hay không, và phục hồi mà không sao chép hoặc mất một hành động.
Ngữ điệu và các tín hiệu phụ ngôn ngữ có thể chỉ ra nhấn mạnh hoặc không chắc chắn, nhưng suy đoán cảm xúc, sức khỏe hoặc ý định từ giọng nói dễ gây lỗi và phụ thuộc vào văn hoá. Sử dụng các ước lượng này một cách thận trọng, công khai chúng khi thích hợp, và không đưa ra quyết định quan trọng dựa trên nhãn cảm xúc chưa được xác thực.
Đánh giá, quyền riêng tư và thiết kế sản xuất
Tỷ lệ lỗi từ vẫn hữu ích, nhưng đánh giá đối thoại cũng nên đo lường việc gán người nói, độ chính xác thực thể, thành công nhiệm vụ ngữ nghĩa, ổn định giả thuyết một phần, độ trễ điểm kết thúc, thành công gián đoạn, phục hồi và tỷ lệ sửa lỗi của người dùng. Phân đoạn theo giọng địa phương, ngôn ngữ, thiết bị, tiếng ồn, chồng chéo, phong cách nói và điều kiện mạng.
Kiến trúc phát luồng cần các bộ đệm có giới hạn, áp lực ngược, kết nối lại, số thứ tự, và việc hoàn thiện rõ ràng. Giữ ngân sách độ trễ cho mô hình và hội thoại riêng biệt, theo dõi mọi giai đoạn và kiểm tra mạng kém. Khi một hệ thống kích hoạt hành động, xác nhận ý định có tác động lớn và làm cho các lần thử lại không gây trùng lặp để âm thanh lặp lại hoặc kết nối lại không sao chép giao dịch.
Giọng nói chứa thông tin về danh tính, nội dung, môi trường và người xung quanh. Giảm thiểu thời gian lưu trữ, mã hoá truyền tải và lưu trữ, kiểm soát truy cập, định nghĩa việc xóa, và phân biệt âm thanh với bản sao và nhúng được suy ra. Cung cấp chỉ báo ghi âm rõ ràng và các lựa chọn thay thế khi không có sự đồng ý. Một mô hình cục bộ có thể giảm việc truyền tải nhưng vẫn cần sự cho phép và kiểm soát vòng đời.
Ví dụ thực tế: một trợ lý giọng nói xử lý gián đoạn và sửa lỗi
Một người gọi nói, ‘Đặt lịch vào thứ Ba—không, chiều thứ Tư,’ trong khi trợ lý bắt đầu phản hồi sau từ ‘thứ Ba.’ Nhận dạng phát luồng phát ra các bản sao một phần thay đổi, việc xác định điểm kết thúc phát hiện giọng nói tiếp tục, và tính năng can thiệp (barge-in) dừng đầu ra. Trạng thái hội thoại đánh dấu ngày trước đó đã bị thay thế thay vì tạo hai yêu cầu. Xác nhận thực thể tập trung vào ngày và giờ đã sửa, trong khi hệ thống giữ lại độ tin cậy và bằng chứng cho diễn giải cuối cùng.
Kiến trúc tách riêng việc ghi âm, phát hiện giọng nói, nhận dạng phát luồng, xử lý người nói, chính sách hội thoại, thực thi công cụ và tổng hợp. Số thứ tự và việc hoàn thiện ngăn các kết quả một phần đến muộn ghi đè lên bản sao cuối cùng. Công cụ đặt lịch chấp nhận yêu cầu có cấu trúc, kiểm tra quyền và khả dụng, và sử dụng khóa idempotency. Một đặt lịch quan trọng được đọc lại và xác nhận trước khi thực hiện; việc kết nối lại không thể lặp lại một cách âm thầm.
Kiểm tra kết hợp độ chính xác từ và thực thể với độ trễ điểm kết thúc, thành công gián đoạn, xử lý sửa lỗi, gán người nói, hoàn thành nhiệm vụ và tỷ lệ hành động trùng lặp. Các kịch bản bao gồm tiếng ồn, chồng chéo, giọng địa phương, chuyển đổi ngôn ngữ, giọng nói chậm, thiết bị hỗ trợ, mạng yếu và các cuộc tấn công tổng hợp. Việc lưu trữ âm thanh được giảm thiểu và công khai, dữ liệu người xung quanh được xử lý rõ ràng, và người dùng có thể chuyển sang văn bản hoặc người thật. Trí tuệ đối thoại được đo bằng khả năng phục hồi an toàn và kết quả, không chỉ độ chính xác của bản sao.
Danh sách kiểm tra triển khai thực tế
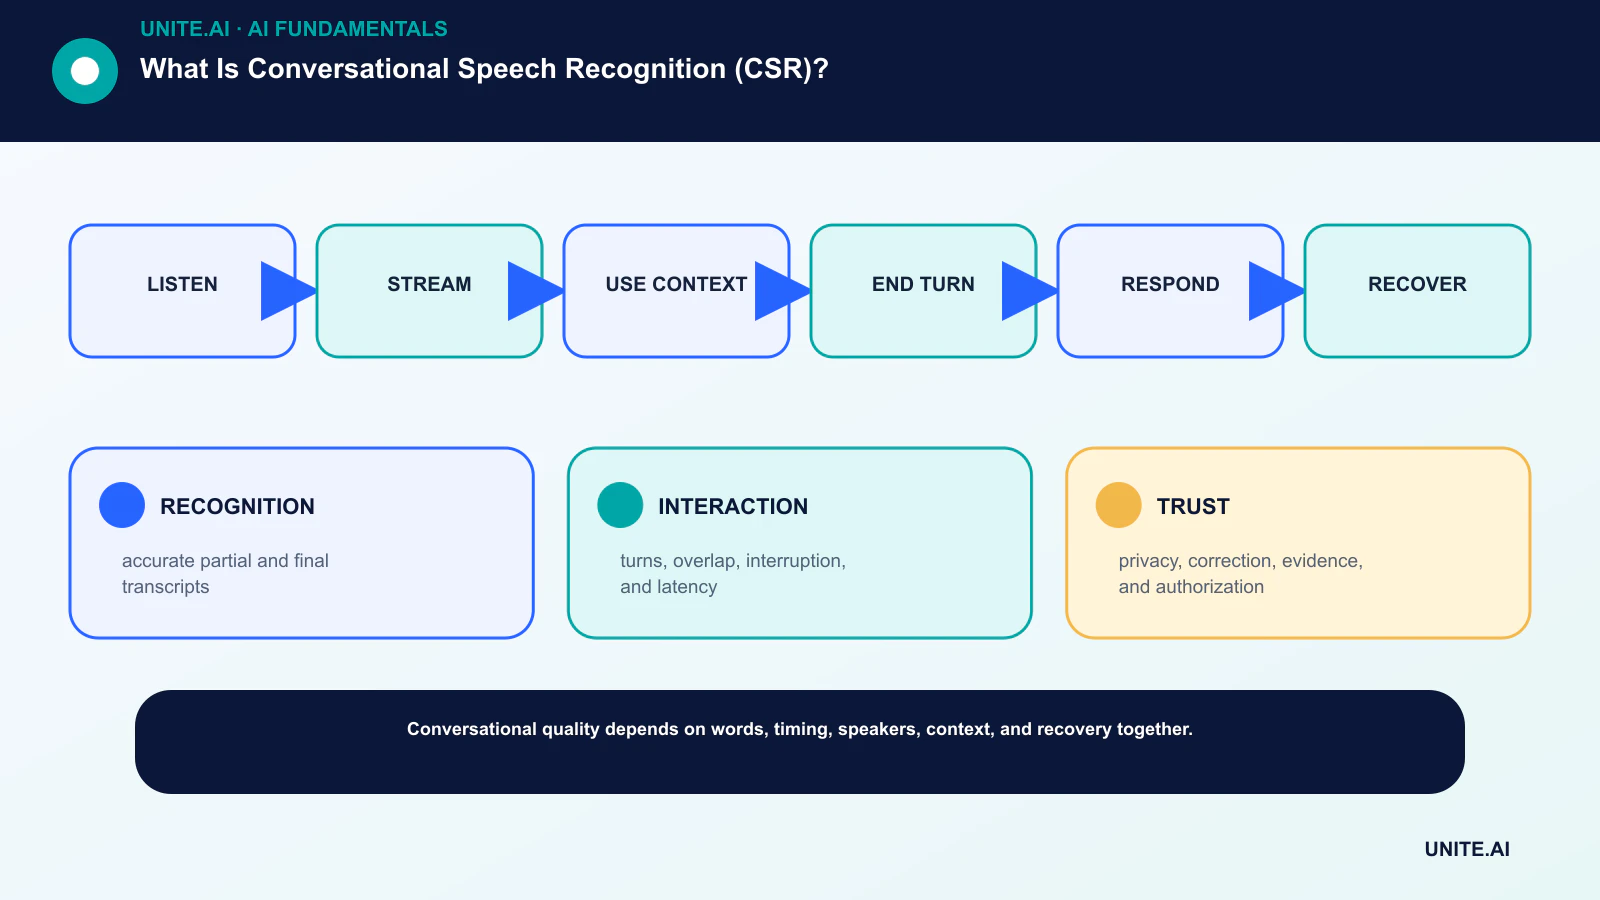
Biến ý tưởng thành quy trình có giới hạn, có thể kiểm thử: nghe → phát luồng → sử dụng ngữ cảnh → kết thúc lượt → phản hồi → phục hồi. Chỉ định một người chịu trách nhiệm, ghi chép dữ liệu và các phụ thuộc, thiết lập một tiêu chuẩn cơ bản đơn giản, đặt tiêu chí chấp nhận và dừng, kiểm thử các lỗi đại diện, và xác định giám sát, khôi phục và đánh giá trước khi mở rộng phạm vi. Ghi lại các phiên bản và giả định để đội khác có thể tái tạo kết quả và hiểu những gì đã thay đổi.
Trước khi ra mắt, thực hiện một đánh giá sẵn sàng được ghi chép với những người xây dựng, vận hành, bảo mật và chịu ảnh hưởng từ hệ thống. Kiểm thử các trường hợp bình thường, điều kiện biên, lỗi phụ thuộc và lạm dụng; bảo quản bằng chứng và các rủi ro chưa giải quyết. Xác định ai có thể phê duyệt phát hành, thay đổi ngưỡng, ghi đè đầu ra, hoặc dừng hoạt động. Xem lại quyết định sau khi dữ liệu thực tế đến, vì một dự án thí nghiệm kỹ thuật thành công không đảm bảo hiệu suất đáng tin cậy ở quy mô lớn hơn.
- RECOGNITION: bản sao một phần và cuối cùng chính xác.
- INTERACTION: lượt nói, chồng chéo, gián đoạn và độ trễ.
- TRUST: quyền riêng tư, sửa lỗi, bằng chứng và ủy quyền.
Câu hỏi thường gặp
CSR có khác với ASR không?
ASR là thành phần chuyển giọng nói thành văn bản. CSR sử dụng ASR cộng với ngữ cảnh hội thoại, thời gian, người nói và xử lý điểm kết thúc, cùng các chính sách tương tác cho cuộc trò chuyện trực tiếp.
Tỷ lệ lỗi từ thấp hơn có đảm bảo trợ lý giọng nói tốt hơn không?
Không. Một hệ thống có thể sao chép chính xác nhưng vẫn ngắt lời người dùng, phản hồi chậm, gán sai người nói, hoặc thực hiện hành động sai. Cần các chỉ số tương tác đầu cuối.
Tài liệu tham khảo chính












