
Nền tảng AI
Autoencoder là gì?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
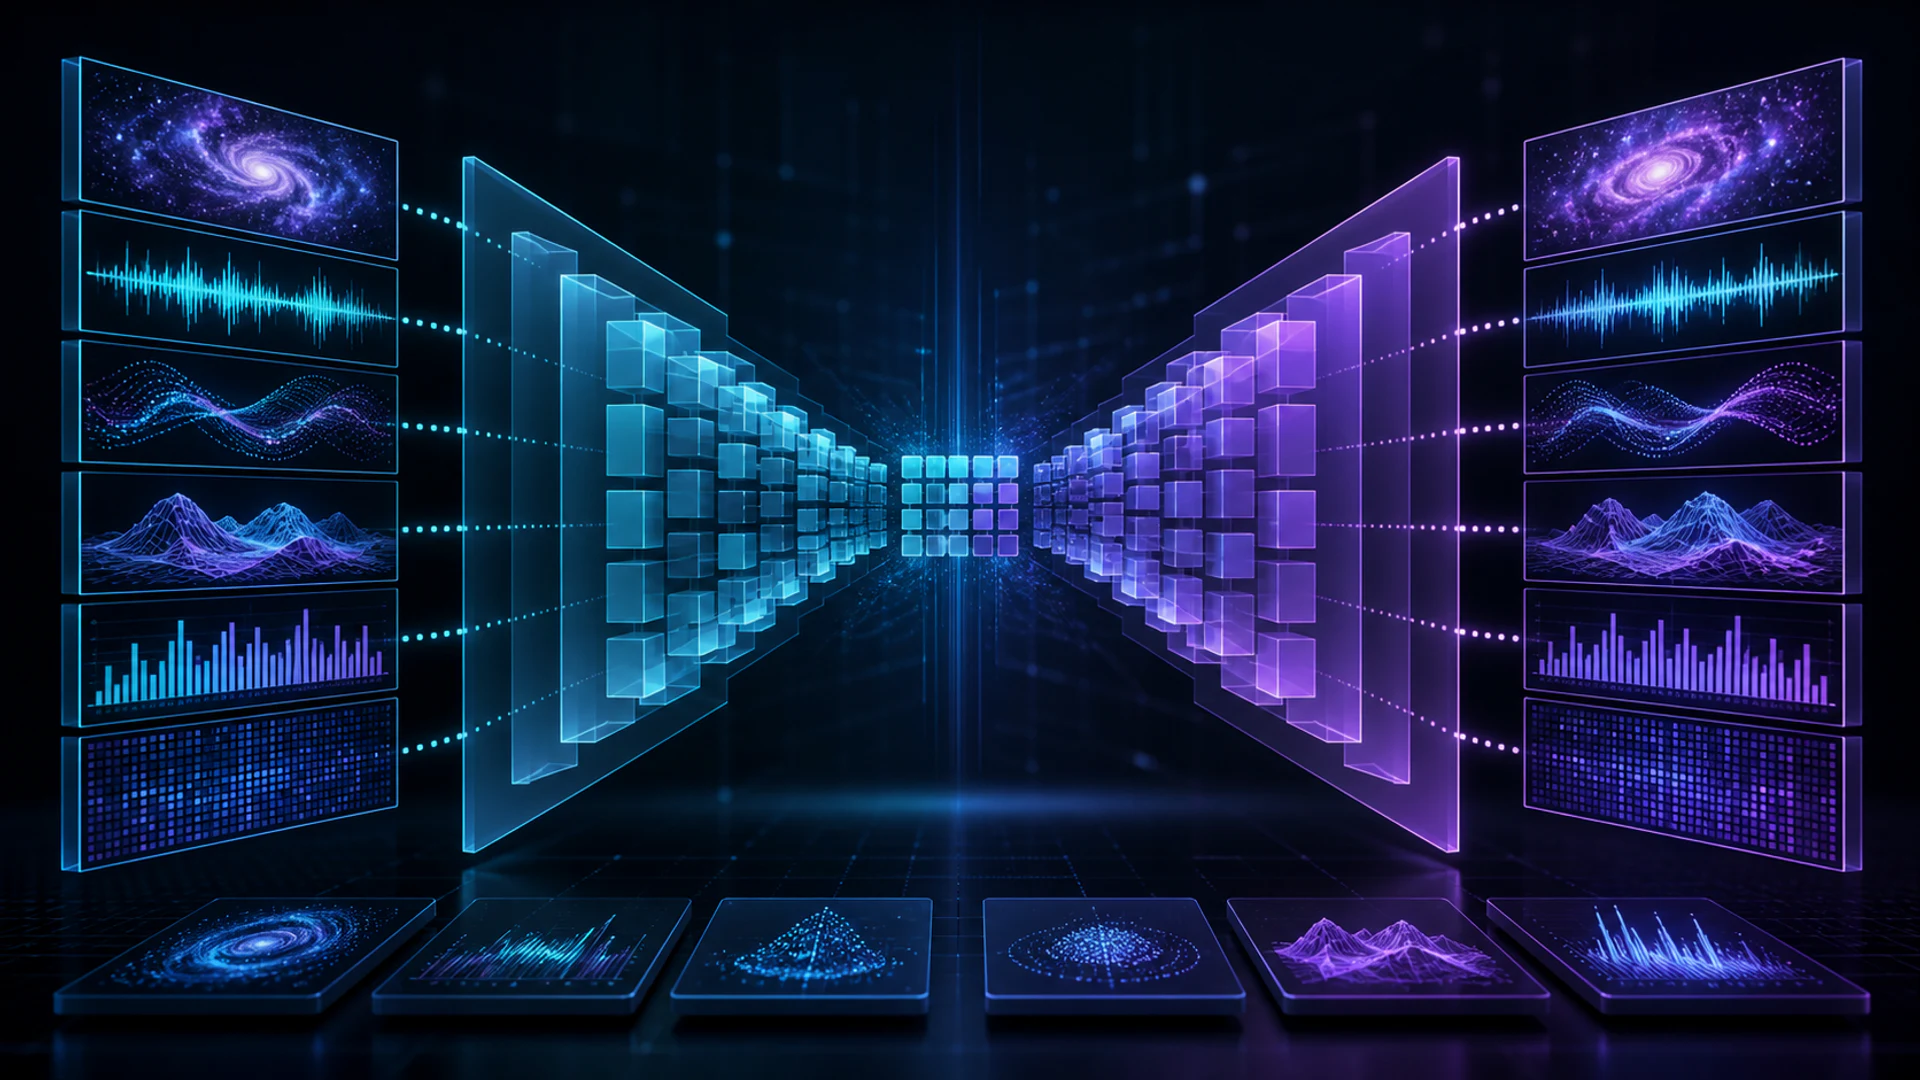
Một autoencoder là một mạng nơ-ron được đào tạo để tái tạo lại đầu vào của nó. Bộ mã hoá (encoder) ánh xạ đầu vào thành một biểu diễn tiềm ẩn; bộ giải mã (decoder) ánh xạ biểu diễn đó trở lại thành một bản tái tạo. Quá trình đào tạo giảm thiểu một hàm mất mát tái tạo, đôi khi kèm theo các ràng buộc bổ sung.
Việc sao chép đầu vào một cách hoàn hảo không tự động có ích. Kiến trúc hoặc mục tiêu phải tạo ra một nút thắt, thêm nhiễu, áp đặt tính thưa thớt hoặc theo cách khác ngăn chặn một ánh xạ đồng nhất đơn giản để mã tiềm ẩn nắm bắt được cấu trúc hữu ích.
Điểm chính
- Bộ mã hoá nén hoặc biến đổi một đầu vào; bộ giải mã tái tạo nó từ một mã tiềm ẩn.
- Một nút thắt dưới mức, nhiễu hoặc chuẩn hoá khuyến khích mô hình học cấu trúc thay vì sao chép.
- Lỗi tái tạo có thể hỗ trợ phát hiện bất thường, nhưng các bất thường không nhất thiết sẽ có lỗi cao.
- Các autoencoder biến đổi học một mô hình tiềm ẩn xác suất và khác với các autoencoder quyết định.
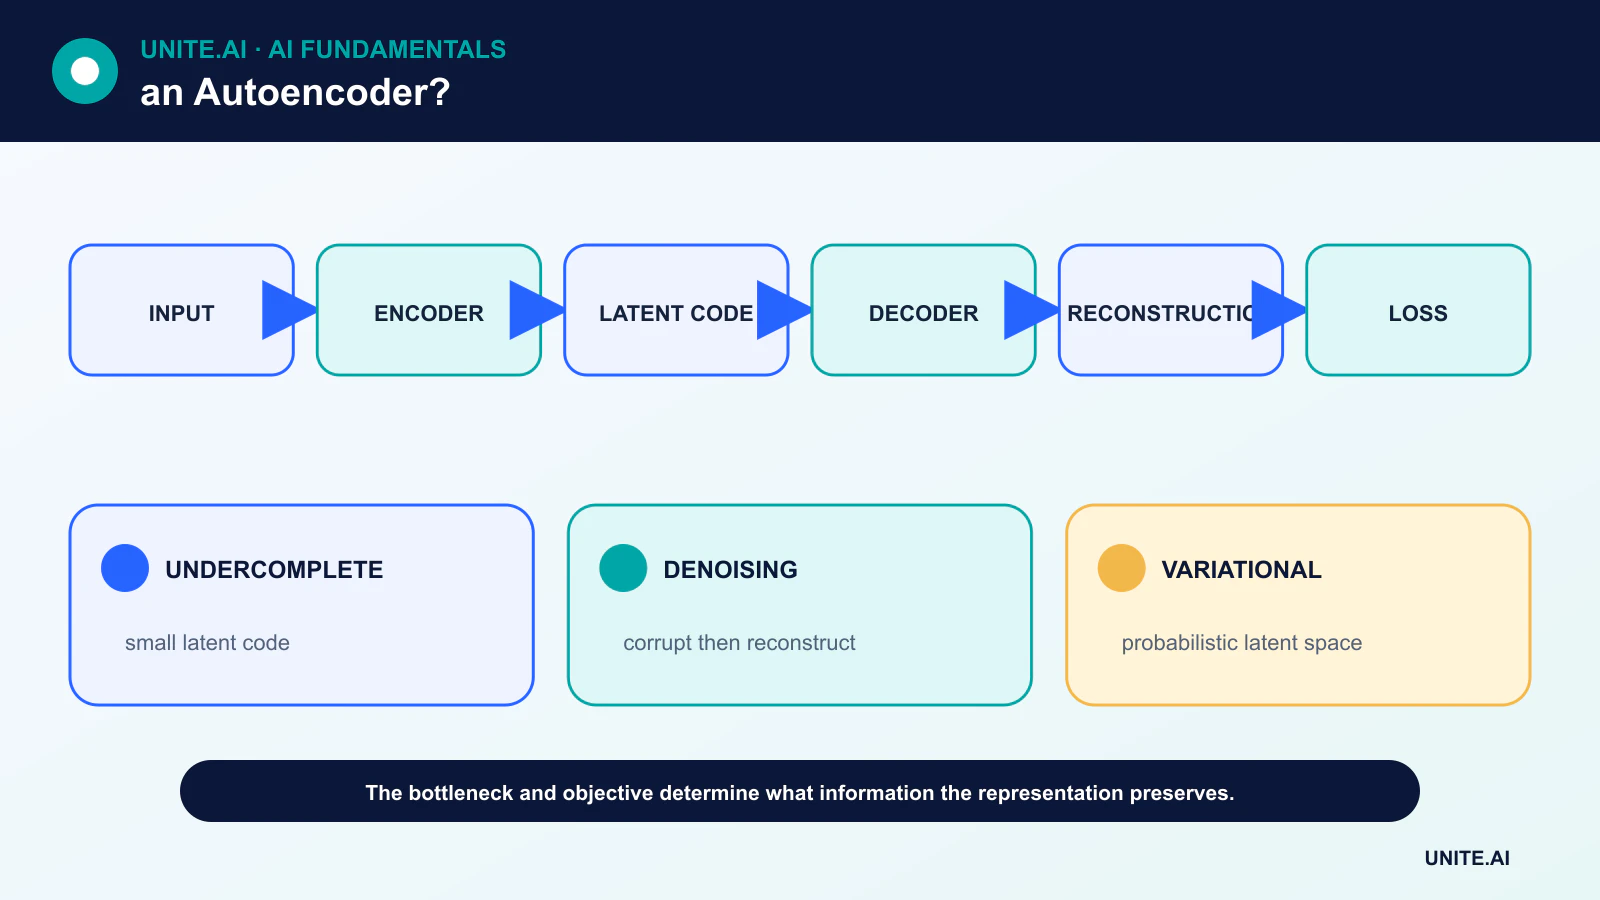
Bộ mã hoá, không gian tiềm ẩn và bộ giải mã
Với đầu vào x, bộ mã hoá tạo ra mã tiềm ẩn z = f(x) và bộ giải mã tạo ra bản tái tạo x̂ = g(z). Hàm mất mát so sánh x và x̂, ví dụ bằng lỗi bình phương trung bình cho các giá trị liên tục hoặc một hàm khả năng phù hợp với dữ liệu.
Kích thước không gian tiềm ẩn có thể nhỏ hơn đầu vào, tạo ra một autoencoder dưới mức. Một mạng sâu cũng có thể học các biểu diễn phi tuyến, mở rộng ý tưởng phía sau giảm chiều dữ liệu.
Các biến thể autoencoder phổ biến
Một autoencoder thưa thớt (sparse) phạt việc kích hoạt lan rộng. Một autoencoder khử nhiễu (denoising) nhận đầu vào bị hỏng và tái tạo lại phiên bản sạch. Một autoencoder co lại (contractive) phạt độ nhạy của mã đối với các thay đổi nhỏ của đầu vào.
Một autoencoder biến đổi (variational autoencoder – VAE) mã hoá các tham số của một phân phối xác suất, lấy mẫu một giá trị tiềm ẩn và cân bằng giữa tái tạo và một thuật ngữ chuẩn hoá định hình không gian tiềm ẩn. Điều này hỗ trợ việc lấy mẫu nhưng thay đổi mục tiêu và cách giải thích.
Đào tạo và tránh các giải pháp tầm thường
Autoencoder sử dụng lan truyền ngược giống như các mạng nơ-ron khác. Một mạng có khả năng quá lớn có thể ghi nhớ các ví dụ huấn luyện hoặc học một hàm gần như đồng nhất. Kích thước nút thắt, nhiễu, các hình phạt và việc xác thực trên dữ liệu chưa thấy sẽ hạn chế nó.
Lựa chọn hàm mất mát quan trọng. Hàm mất mát theo từng pixel có thể tạo ra các bản tái tạo ảnh mờ, trong khi các hàm mất mát cảm nhận (perceptual) thừa hưởng các giả định từ một mạng khác. Thước đo tái tạo tốt nhất không nhất thiết là thước đo tốt nhất cho sự tương đồng ngữ nghĩa.
Ứng dụng và hạn chế
Autoencoder có thể học các đặc trưng, khử nhiễu tín hiệu, nén dữ liệu, khởi tạo mô hình và tạo ra các biến tiềm ẩn để trực quan hoá. Đối với phát hiện bất thường, một mô hình được huấn luyện trên dữ liệu bình thường có thể gán lỗi tái tạo cao hơn cho các đầu vào bất thường.
Cách tiếp cận này có thể thất bại khi autoencoder cũng tái tạo tốt các bất thường hoặc khi sự biến đổi vô hại khó tái tạo hơn so với bất thường mục tiêu. Ngưỡng cần dữ liệu xác thực được gắn nhãn hoặc được xem xét cẩn thận, và lỗi nên được giám sát theo nhóm phụ và điều kiện vận hành.
Autoencoder so với các mô hình sinh khác
Một autoencoder quyết định không tự động là một mô hình sinh xác suất. VAE định nghĩa một phân phối tiềm ẩn có cấu trúc; GAN đào tạo một bộ sinh (generator) đối kháng với một bộ phân biệt (discriminator); các mô hình khuếch tán (diffusion) học một quá trình khử nhiễu.
Lựa chọn phụ thuộc vào mục tiêu là tái tạo, biểu diễn, khả năng, độ trung thực của mẫu, khả năng kiểm soát hay đánh giá bất thường. Một mô hình nhỏ hơn, chuyên cho nhiệm vụ thường thực tế hơn so với một bộ sinh ảnh lớn.
Mục tiêu bộ mã hoá–bộ giải mã và biểu diễn tiềm ẩn
Một autoencoder học một bộ mã hoá ánh xạ đầu vào x thành mã tiềm ẩn z và một bộ giải mã tái tạo x từ z. Nếu khả năng không bị hạn chế, nó có thể học một ánh xạ đồng nhất với ít cấu trúc hữu ích. Các nút thắt, chuẩn hoá, nhiễu, tính thưa thớt, hoặc các ràng buộc kiến trúc buộc một biểu diễn bảo tồn thông tin được chọn. Hàm mất mát tái tạo định nghĩa gì là tương đồng: lỗi bình phương trung bình ưu tiên độ trung thực pixel trung bình, trong khi các hàm mất mát cảm nhận hoặc đặc thù cho từng mô hình nhấn mạnh các đặc trưng khác nhau. Một mất mát thấp không đảm bảo ý nghĩa ngữ nghĩa.
Autoencoder dưới mức hạn chế kích thước không gian tiềm ẩn. Autoencoder khử nhiễu tái tạo dữ liệu sạch từ đầu vào bị hỏng. Các biến thể thưa thớt phạt kích hoạt; các biến thể co lại phạt độ nhạy. Autoencoder biến đổi học một phân phối tiềm ẩn xác suất bằng cách kết hợp tái tạo với một thuật ngữ độ lệch, cho phép lấy mẫu nhưng thay đổi mục tiêu. Các autoencoder dạng convolution, chuỗi, đồ thị và transformer mã hoá cấu trúc mô hình. Chọn kích thước tiềm ẩn và chuẩn hoá thông qua xác thực downstream, không chỉ dựa vào các biểu đồ hai chiều hấp dẫn.
Phát hiện bất thường, nén và đánh giá
Đối với phát hiện bất thường, huấn luyện trên dữ liệu bình thường đại diện và đánh giá lỗi tái tạo hoặc khả năng tiềm ẩn, nhưng các bất thường đôi khi có thể tái tạo tốt và các trường hợp bình thường hiếm gặp lại tái tạo kém. Chọn ngưỡng dựa trên các trường hợp xác thực được gắn nhãn hoặc đã xem xét, báo cáo mức độ thu hồi (recall) cấp sự kiện và cảnh báo sai, và kiểm tra các thay đổi trong trạng thái vận hành. So sánh với các chuẩn thống kê đơn giản và các mô hình một lớp (one-class). Đối với nén, tính toàn bộ codec—bao gồm kích thước mô hình, lượng tử hoá, siêu dữ liệu và tính toán giải mã—và so sánh chất lượng ở bitrate tương đương với các codec đã được thiết lập.
Chất lượng biểu diễn có thể được đánh giá qua các phép thử tuyến tính, độ ổn định của cụm, truy xuất, tái tạo và các nhiệm vụ downstream, mỗi cái trả lời một câu hỏi khác nhau. Tránh rò rỉ khi học bộ mã hoá và chọn ngưỡng. Kiểm tra các đặc trưng mà hàm mất mát bỏ qua và liệu các thuộc tính nhạy cảm có vẫn được mã hoá hay không. Một mã tiềm ẩn đã nén không tự động được ẩn danh; việc đảo ngược và suy luận thuộc tính có thể khôi phục thông tin riêng tư. Các bản tái tạo được tạo ra cũng có thể trông hợp lý trong khi thay đổi các chi tiết quan trọng.
Triển khai và giám sát
Phiên bản bộ mã hoá và bộ giải mã cùng nhau, xác thực các thay đổi số sau khi xuất, và bảo tồn tỷ lệ đầu vào. Giám sát phân phối tái tạo, sự trôi dạt tiềm ẩn, cảnh báo ngưỡng và kết quả đã xác nhận. Trong giám sát công nghiệp, điều kiện mô hình dựa trên chế độ vận hành để các chuyển đổi bình thường không bị xem là lỗi. Đối với tái tạo y tế hoặc khoa học, không bao giờ trình bày chi tiết được tạo ra như bằng chứng đo lường mà không có xác thực và nguồn gốc. Autoencoder là những người học biểu diễn linh hoạt, nhưng các ràng buộc và hàm mất mát—không phải tên kiến trúc—quy định thông tin nào được giữ lại, loại bỏ hoặc tạo ra.
Ví dụ thực tế: một autoencoder cho bất thường bơm
Một autoencoder dưới mức học các cửa sổ rung động từ hoạt động bơm khỏe mạnh đã được xác minh trên các mức tải và nhiệt độ khác nhau. Nó được so sánh với các ngưỡng thống kê và các phương pháp một lớp, và ngưỡng tái tạo của nó được chọn dựa trên các chuyển đổi bình thường đã được xem xét và các lỗi đã biết. Đánh giá sử dụng mức thu hồi (recall) sự kiện, thời gian cảnh báo trước, cảnh báo sai mỗi giờ vận hành, và kết quả theo từng bơm, không phải các cửa sổ ngẫu nhiên đặt các mẫu liền kề vào tập huấn luyện và kiểm tra.
Mô hình sản xuất điều kiện dựa trên trạng thái vận hành và hiển thị các mẫu dư cho kỹ sư. Một lỗi cao yêu cầu kiểm tra; nó không chẩn đoán bộ phận hay tự động dừng bơm. Sự ngắt kết nối cảm biến, cắt ngắn và tải chưa thấy tạo ra các trạng thái không hợp lệ rõ ràng. Giám sát theo dõi phân phối tái tạo, xác nhận cảnh báo và sức khỏe cảm biến. Khi bảo trì hoặc phần cứng thay đổi nền tảng, mô hình cũ vẫn khả dụng trong khi một ứng cử viên được đào tạo trên dữ liệu đã xem xét và chạy lại với các sự cố lịch sử.
Bằng chứng triển khai và sẵn sàng vận hành
Một quyết định sản xuất cần nhiều hơn một buổi trình diễn thành công. Xác định người dùng dự kiến, môi trường vận hành, đầu vào, đầu ra, các phụ thuộc, chủ sở hữu và hậu quả của mỗi lỗi quan trọng. Thiết lập một nền tảng có thể tái tạo và một tập đánh giá có phiên bản trước khi tinh chỉnh. Kiểm tra các trường hợp thường, các điều kiện biên, đầu vào sai dạng hoặc thiếu, sự dịch chuyển phân phối, mất kết nối phụ thuộc, lạm dụng, và các nhóm hoặc môi trường có khả năng bị thiếu phục vụ. Đo lường chất lượng nhiệm vụ cùng với hiệu chuẩn hoặc độ không chắc, độ trễ, thông lượng, chi phí tài nguyên, khả năng tiếp cận, quyền riêng tư và bảo mật. Ghi lại mọi chuyển đổi và ngưỡng để một người đánh giá độc lập có thể tái tạo kết quả và phân biệt bằng chứng với một nguyên mẫu hấp dẫn.
Trước khi ra mắt, chỉ định quyền trách nhiệm cho việc phát hành, ngoại lệ, thay đổi, quay lại và ngừng sử dụng. Sử dụng triển khai theo giai đoạn, bảo tồn một phương án dự phòng an toàn, và xác thực giám sát với các lỗi được chèn cố ý. Dữ liệu đo lường vận hành nên tiết lộ chất lượng đầu vào, hành vi đầu ra, phiên bản mô hình hoặc quy tắc, sức khỏe phụ thuộc, can thiệp của con người và kết quả đã xác nhận mà không thu thập dữ liệu nhạy cảm không cần thiết. Xác định ngưỡng cảnh báo và người chịu trách nhiệm phản hồi, sau đó xem xét bằng chứng thực tế sau khi triển khai thay vì giả định hiệu suất ngoại tuyến sẽ kéo dài. Đánh giá lại bất cứ khi nào nguồn dữ liệu, người dùng, mô hình, nhà cung cấp, chính sách, phần cứng hoặc mục tiêu thay đổi. Một hệ thống được duy trì cũng cần có quy trình khôi phục, học từ sự cố, xóa và lưu trữ được ghi chép, và một điểm rõ ràng khi nó nên bị vô hiệu hoá hoặc thay thế.
Câu hỏi thường gặp
Autoencoder có phải là nén không mất dữ liệu không?
Không nói chung. Chúng thường học các biểu diễn mất dữ liệu đặc thù cho nhiệm vụ và phân phối và yêu cầu bộ giải mã đã được đào tạo để tái tạo dữ liệu.
Mỗi nút thắt đều có thể giải thích được không?
Không. Một mã ngắn gọn có thể hữu ích mà không cần mỗi chiều ánh xạ tới một khái niệm có thể đọc được bởi con người.
Tài liệu tham khảo chính












