Nền tảng AI
Mạng Nơ-ron Tích chập (CNN) là gì?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
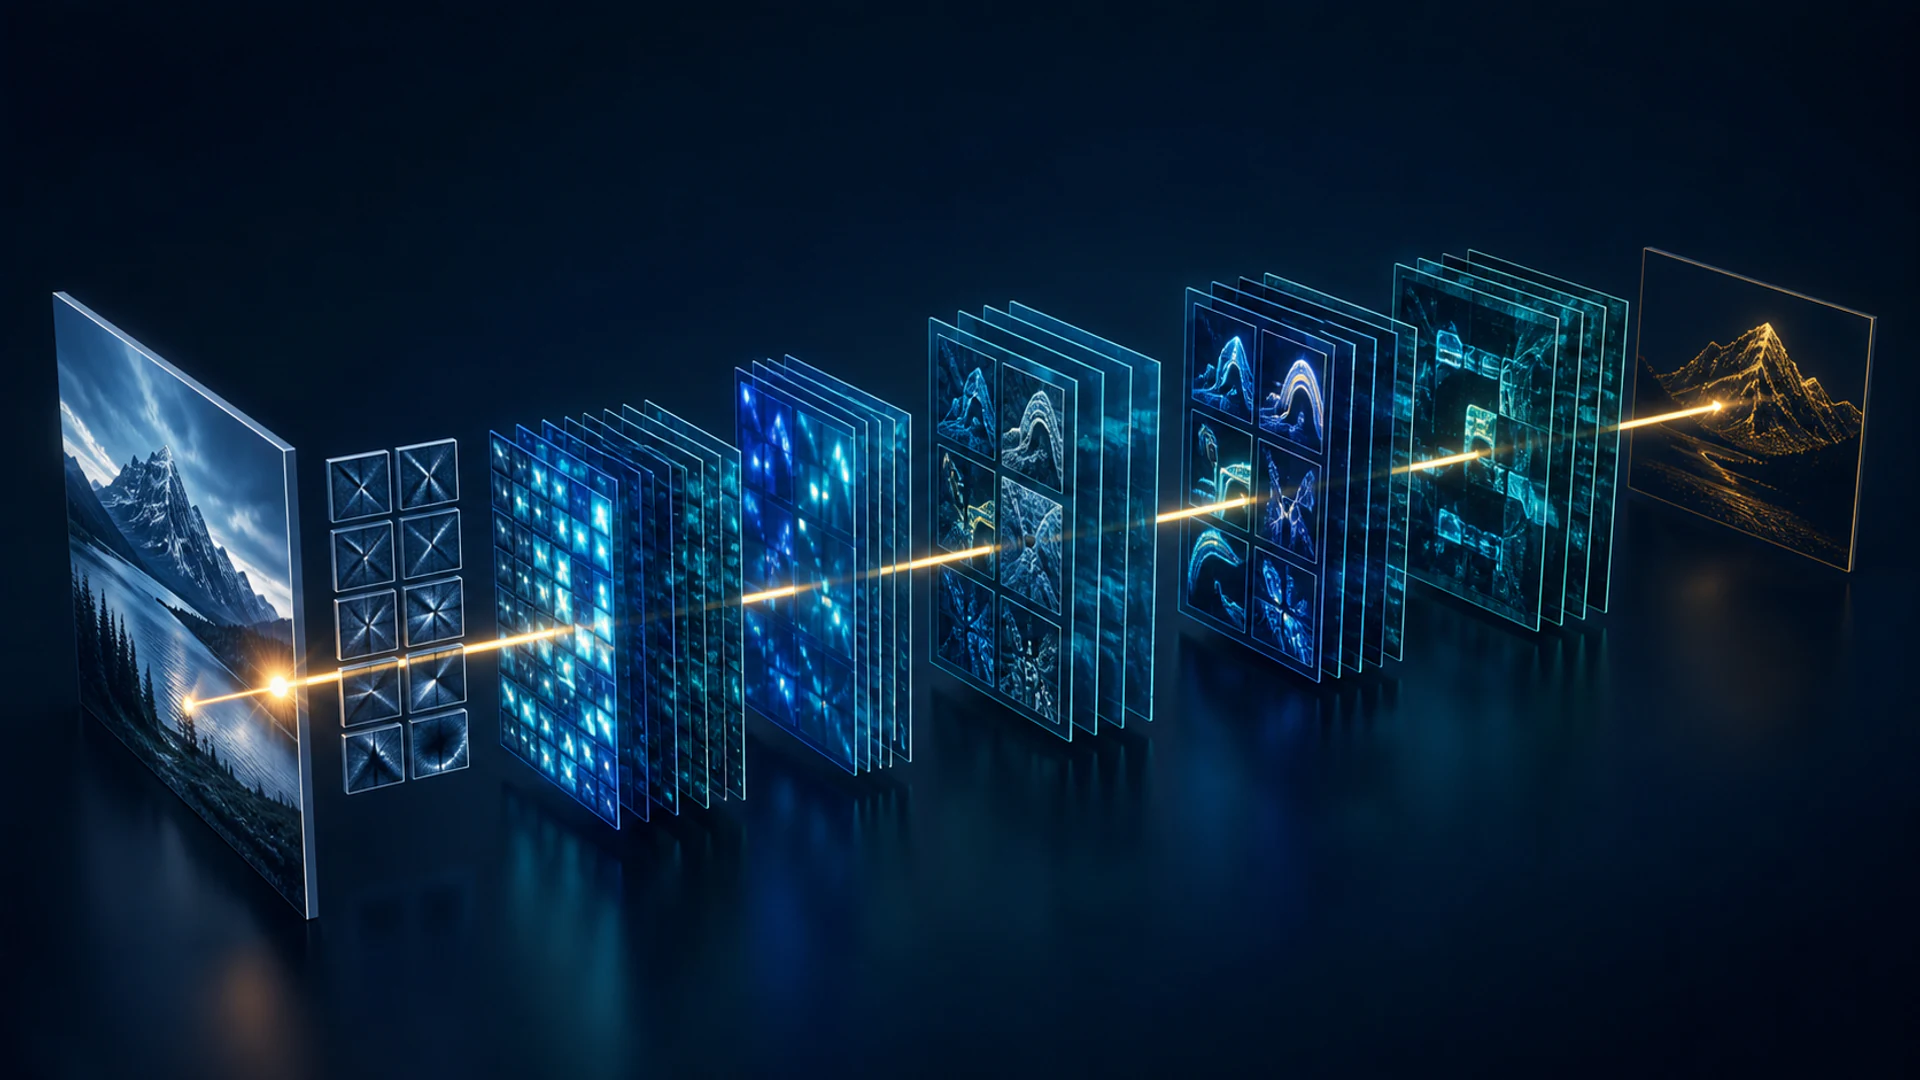
A Mạng nơ-ron tích chập (CNN) là một kiến trúc mạng nơ-ron sử dụng các bộ lọc được học trên các vùng cục bộ của đầu vào. CNN đã trở thành nền tảng cho thị giác máy tính hiện đại vì chúng có thể phát hiện các mẫu bất kể vị trí xuất hiện và tái sử dụng cùng một bộ tham số trên toàn bộ hình ảnh.
Một CNN không chuyển đổi hình ảnh từ dạng phi số sang dạng số — hình ảnh đã xuất hiện dưới dạng tensor các giá trị pixel. Mục đích của nó là biến đổi tensor đó thành các bản đồ đặc trưng hữu ích cho việc phân loại, phát hiện, phân đoạn hoặc các nhiệm vụ khác.
Những điểm chính
- Một phép tích chập kết hợp các giá trị đầu vào cục bộ với một kernel được học để tạo ra bản đồ đặc trưng.
- Stride, padding, dilation và pooling kiểm soát độ phân giải không gian và trường tiếp nhận.
- Chia sẻ trọng số giúp CNN hiệu quả hơn về số lượng tham số so với mạng kết nối đầy đủ trên các pixel thô.
- Vision transformers cung cấp một lựa chọn thay thế, nhưng CNN vẫn mạnh mẽ cho các hệ thống hiệu quả và hạn chế dữ liệu.
Cách hoạt động của phép tích chập
Kernel là một lưới nhỏ gồm các trọng số có thể học. Tại mỗi vị trí, CNN nhân các giá trị của kernel với các giá trị đầu vào tương ứng, cộng lại và thường thêm một bias. Lặp lại quá trình này trên toàn bộ đầu vào sẽ tạo ra một bản đồ đặc trưng.
Đối với hình ảnh màu, kernel bao phủ tất cả các kênh đầu vào. Một lớp sử dụng nhiều kernel để tạo ra nhiều kênh đầu ra. Trong quá trình đào tạo, backpropagation tính gradient cho các trọng số kernel này; phép tích chập không tạo ra một bộ trọng số cố định mới từ mỗi hình ảnh.
Stride, padding và dilation
- Stride kiểm soát khoảng cách kernel di chuyển. Stride lớn hơn một sẽ giảm độ phân giải không gian.
- Padding thêm các giá trị quanh đầu vào để thông tin biên có thể được xử lý và kích thước đầu ra có thể được kiểm soát.
- Dilation làm các phần tử kernel cách nhau, mở rộng trường tiếp nhận mà không tăng tỷ lệ các tham số.
Trường tiếp nhận là vùng của đầu vào gốc có thể ảnh hưởng đến một đơn vị. Việc xếp chồng các phép tích chập sẽ mở rộng nó, cho phép các đặc trưng sau này kết hợp thông tin từ các khu vực rộng hơn.
Kích hoạt, chuẩn hoá và pooling
Các lớp tích chập thường được theo sau bởi các hàm kích hoạt phi tuyến và chuẩn hoá. Pooling tóm tắt các vùng cục bộ bằng một phép toán như max hoặc trung bình. Các phép tích chập có stride được học cũng có thể giảm mẫu.
Pooling không bắt buộc. Nhiều mạng hiện đại sử dụng global average pooling gần đầu ra thay vì làm phẳng một bản đồ đặc trưng lớn thành một chuỗi các lớp kết nối đầy đủ. Điều này giảm số lượng tham số và cho phép mạng tổng hợp bằng chứng không gian.
Kiến trúc CNN hiện đại
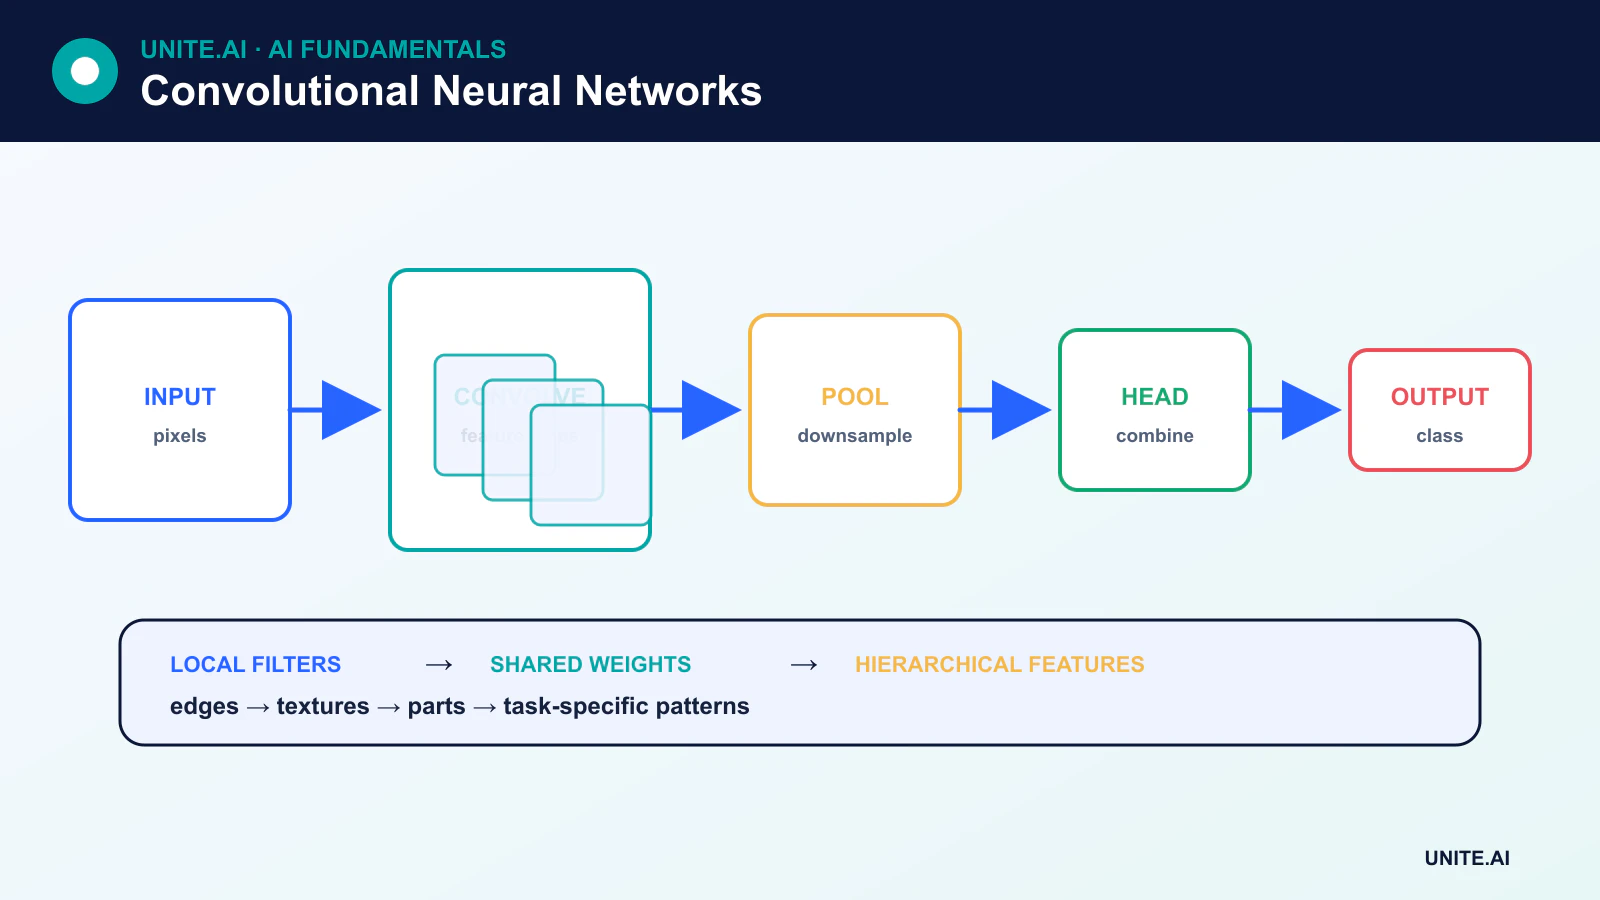
Một mô hình thị giác điển hình bao gồm phần đầu (stem), một chuỗi các khối đặc trưng, các giai đoạn giảm mẫu và một đầu nhiệm vụ. Các kết nối residual cho phép một khối học một phép biến đổi đối với đầu vào và cung cấp một đường truyền trực tiếp cho thông tin và gradient. Thành công của các mạng residual đã làm cho việc đào tạo các CNN sâu hơn trở nên khả thi.
Các đầu phân loại tạo ra điểm số cho các lớp. Các đầu phát hiện dự đoán các danh mục và hộp giới hạn. Kiến trúc phân đoạn thêm các đường giải mã để khôi phục chi tiết không gian. Cùng một backbone CNN có thể được tái sử dụng thông qua transfer learning.
Các lớp CNN học gì
Thường người ta trực quan hoá các bộ lọc đầu tiên phản hồi với các cạnh hoặc kết cấu và các biểu diễn sau này tương quan với các bộ phận hoặc đối tượng. Đây là một trực giác hữu ích, nhưng không phải là quy tắc cố định. Các đặc trưng phụ thuộc vào nhiệm vụ, kiến trúc, dữ liệu, mục tiêu và quá trình đào tạo, và một số đơn vị kết hợp thông tin mà không thể ánh xạ rõ ràng thành khái niệm của con người.
CNN so với vision transformers
Vision transformers chia hình ảnh thành các mảnh và sử dụng attention để mô hình hóa mối quan hệ giữa chúng. Chúng có thể mở rộng hiệu quả với các bộ dữ liệu tiền huấn luyện lớn. CNN xây dựng các giả định về tính cục bộ và dịch chuyển trực tiếp vào kiến trúc, điều này có thể làm cho chúng hiệu quả hơn và tiết kiệm dữ liệu trong các môi trường nhỏ hơn.
Nhiều hệ thống thực tế kết hợp tích chập và attention. Kiến trúc phù hợp phụ thuộc vào độ chính xác, độ trễ, bộ nhớ, dữ liệu đào tạo, phần cứng và triển khai — không phải dựa trên việc nào là họ mới nhất.
Hạn chế và cân nhắc thực tiễn
CNN có thể nhạy cảm với sự thay đổi phân phối, nhiễu gây nhiễu (adversarial), các đường tắt nền và dữ liệu đào tạo có thiên lệch. Chúng không hoàn toàn bất biến với vị trí, xoay, tỉ lệ hoặc góc nhìn. Việc tăng cường dữ liệu và lựa chọn kiến trúc có thể cải thiện độ bền, nhưng không đảm bảo.
Đối với triển khai, đo lường độ trễ đầu cuối, bộ nhớ, thông lượng và hành vi của các nhóm phụ. Quantization và pruning có thể giảm chi phí, đặc biệt đối với edge AI, nhưng các mô hình nén cần được xác thực lại.
Tích chập, trường tiếp nhận và các khối CNN hiện đại
Một lớp tích chập trượt các kernel được học trên một lưới và chia sẻ trọng số giữa các vị trí. Kích thước kernel, stride, dilation và padding quyết định hình dạng đầu ra và trường tiếp nhận. Các lớp đầu thường phản hồi với các cạnh hoặc kết cấu cục bộ; các lớp sâu hơn kết hợp thông tin trên các vùng lớn hơn, mặc dù các biểu diễn được học không nhất thiết phải ánh xạ rõ ràng thành khái niệm của con người. Pooling hoặc tích chập có stride giảm độ phân giải không gian. Các kênh mang các bản đồ đặc trưng, trong khi các phép tích chập nhóm và depthwise separable trao đổi việc trộn kênh để giảm tính toán. Các kết nối residual giúp các mạng rất sâu dễ tối ưu hơn.
Đối với chiều cao và chiều rộng của đầu vào, padding kiểm soát cách xử lý biên và stride kiểm soát việc lấy mẫu. Việc giảm mẫu quá mức có thể xóa bỏ các đối tượng nhỏ; padding zero có thể tạo ra hiện tượng méo biên; dilation mở rộng ngữ cảnh mà không tăng tham số tương đương nhưng có thể gây hiện tượng lưới. Batch normalization phụ thuộc vào thống kê đào tạo, trong khi các phương pháp thay thế có thể hoạt động tốt hơn ở kích thước batch nhỏ. Các kiến trúc hiện đại kết hợp các bottleneck, đặc trưng đa tỉ lệ, attention hoặc residual ngược. Lựa chọn kiến trúc dựa trên độ phân giải nhiệm vụ, băng thông bộ nhớ, độ trễ và phần cứng mục tiêu thay vì chỉ độ chính xác phân loại hình ảnh.
Đào tạo, giải thích và triển khai
Sử dụng các phép tăng cường dữ liệu giữ nguyên nhãn và phản ánh biến đổi thực tế, và chia dữ liệu theo đối tượng hoặc cảnh trước khi tăng cường. Transfer learning phổ biến: thay thế đầu nhiệm vụ, đào tạo nó, sau đó cẩn thận mở khóa backbone. Đánh giá hiệu năng riêng lớp, hiệu chuẩn, độ bền với mờ, nén, ánh sáng, tỉ lệ, cắt và nhiễu gây nhiễu. Các phương pháp trực quan hoá như bản đồ đặc trưng và saliency có thể tiết lộ các đường tắt, nhưng chúng nhạy cảm với phương pháp và baseline. Xác nhận sự phụ thuộc nghi ngờ bằng các hình ảnh phản chứng, kiểm tra che khuất, hoặc thay đổi bộ dữ liệu.
Các CNN đã xuất ra có thể được hợp nhất, quantize hoặc biên dịch cho GPU, NPU, trình duyệt hoặc vi điều khiển. Xác thực đồ thị đã triển khai, bao gồm tiền xử lý và hậu xử lý, trên các thiết bị chính xác. Đo lường độ trễ đầu cuối, bộ nhớ, năng lượng và hành vi nhiệt; việc giải mã đầu vào có thể chiếm ưu thế trong mô hình nhỏ. Giám sát thống kê camera và hình ảnh, phân phối đầu ra và các lỗi đã xác nhận. Các artefact mô hình có chữ ký, kênh cập nhật bảo vệ và việc thất bại cảm biến một cách mềm mại là một phần của thiết kế sản xuất. CNN mã hoá một bias cục bộ hữu ích, nhưng chúng không tự động hiểu các đối tượng hay cảnh quan hệ nhân quả.
Ví dụ thực tế: triển khai CNN trên camera kiểm tra
Một CNN phân loại các khuyết điểm bề mặt từ các ảnh line-scan độ phân giải cao. Các kỹ sư chia ảnh thành các ô có chồng lấp để các khuyết điểm nhỏ vẫn tồn tại sau khi giảm mẫu, giữ lại tọa độ để xem xét, và xác thực các phép tăng cường dựa trên biến đổi quang học thực tế. Một CNN residual và một mô hình depthwise nhẹ hơn được so sánh với độ thu hồi bằng nhau. Các thử nghiệm bao gồm khuyết điểm cạnh, chói sáng, nén, chuyển động, lô vật liệu và thay thế camera, với các lô sản xuất độc lập được dành cho đánh giá cuối cùng.
Quá trình biên dịch hợp nhất và quantize mô hình cho bộ tăng tốc edge, nhưng đồ thị đã triển khai được so sánh với tham chiếu trên các trường hợp khuyết điểm nhạy cảm. Việc giải mã, chia ô, suy luận và hợp nhất độ trễ được đo lường đầu cuối. Hệ thống đánh dấu các pixel chết và độ trễ phơi sáng riêng biệt so với khuyết điểm sản phẩm. Người vận hành có thể kiểm tra các ô nguồn và ghi đè kết quả. Các thay đổi mô hình và camera được triển khai dần dần, và dây chuyền vẫn duy trì quy trình kiểm tra thủ công an toàn khi pipeline thị giác không khả dụng.
Bằng chứng triển khai và sẵn sàng vận hành
Quyết định sản xuất cần nhiều hơn một buổi trình diễn thành công. Xác định người dùng mục tiêu, môi trường vận hành, đầu vào, đầu ra, các phụ thuộc, người sở hữu và hậu quả của mỗi lỗi quan trọng. Thiết lập một baseline có thể tái tạo và một bộ đánh giá có phiên bản trước khi tinh chỉnh. Kiểm tra các trường hợp thường, điều kiện biên, đầu vào sai dạng hoặc thiếu, sự thay đổi phân phối, mất kết nối phụ thuộc, lạm dụng, và các nhóm hoặc môi trường có khả năng bị thiếu hỗ trợ. Đo lường chất lượng nhiệm vụ cùng với hiệu chuẩn hoặc độ không chắc, độ trễ, thông lượng, chi phí tài nguyên, khả năng tiếp cận, quyền riêng tư và bảo mật. Ghi lại mọi biến đổi và ngưỡng để một người đánh giá độc lập có thể tái tạo kết quả và phân biệt bằng chứng với một nguyên mẫu hấp dẫn.
Trước khi ra mắt, chỉ định quyền chịu trách nhiệm cho việc phát hành, ngoại lệ, thay đổi, rollback và ngừng sử dụng. Sử dụng rollout theo giai đoạn, duy trì một dự phòng an toàn và xác minh giám sát bằng các lỗi được chèn cố ý. Telemetry vận hành nên tiết lộ chất lượng đầu vào, hành vi đầu ra, phiên bản mô hình hoặc quy tắc, tình trạng phụ thuộc, can thiệp của con người và kết quả đã xác nhận mà không thu thập dữ liệu nhạy cảm không cần thiết. Xác định ngưỡng cảnh báo và người chịu trách nhiệm phản hồi, sau đó xem xét bằng chứng thực tế sau khi triển khai thay vì giả định hiệu suất offline sẽ duy trì. Đánh giá lại mỗi khi nguồn dữ liệu, người dùng, mô hình, nhà cung cấp, chính sách, phần cứng hoặc mục tiêu thay đổi. Một hệ thống được duy trì cũng cần có tài liệu phục hồi, học hỏi từ sự cố, quy trình xóa và lưu trữ, và một điểm rõ ràng khi nó nên bị vô hiệu hoá hoặc thay thế.
Câu hỏi thường gặp
CNN luôn cần pooling không?
Không. CNN có thể giảm mẫu bằng tích chập có stride và có thể giữ nguyên độ phân giải cho dự đoán dày đặc. Pooling chỉ là một công cụ thiết kế chứ không phải yêu cầu bắt buộc.
Các bộ lọc CNN được thiết kế thủ công không?
Trong một CNN đã được đào tạo, các giá trị kernel thường được học từ dữ liệu. Điều này khác với các bộ lọc thị giác cổ điển, nơi các hệ số được chọn trước cho các phép toán như phát hiện cạnh.
Tài liệu tham khảo chính