
Nền tảng AI
Học chuyển giao là gì?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Transfer learning tái sử dụng kiến thức đã học cho một vấn đề để cải thiện việc học trên một vấn đề liên quan. Thay vì khởi tạo mọi tham số một cách ngẫu nhiên, người thực hành bắt đầu từ một mô hình hoặc biểu diễn đã được huấn luyện trước và điều chỉnh nó cho nhiệm vụ mục tiêu.
Cách tiếp cận này đặc biệt hữu ích khi tập dữ liệu mục tiêu nhỏ, việc gán nhãn tốn kém, hoặc việc huấn luyện trước đòi hỏi nhiều tính toán hơn so với khả năng chi trả của nhóm mục tiêu. Huấn luyện một mô hình từ đầu là lựa chọn thay thế cho học chuyển giao — không phải là một dạng của học chuyển giao.
Những điểm chính
- Trích xuất đặc trưng giữ nguyên mô hình cơ sở đã được huấn luyện trước và huấn luyện một đầu mới chuyên dụng cho nhiệm vụ.
- Fine-tuning cập nhật một phần hoặc toàn bộ các tham số đã được huấn luyện trước bằng dữ liệu miền mục tiêu.
- Phương pháp tiết kiệm tham số như adapters và LoRA cập nhật một phần nhỏ của mô hình.
- Việc chuyển giao có thể thất bại khi miền nguồn và miền mục tiêu khác nhau, giấy phép xung đột, hoặc mô hình nguồn mang độ lệch không phù hợp.
Tại sao học chuyển giao hiệu quả
Các mô hình thường học các biểu diễn có ích vượt ra ngoài dữ liệu chính xác mà chúng được huấn luyện. Các lớp đầu của mô hình hình ảnh có thể nắm bắt các mẫu cục bộ có thể tái sử dụng; một mô hình ngôn ngữ có thể học cú pháp, ngữ nghĩa và các liên kết rộng từ dự đoán tự giám sát. Một nhiệm vụ mục tiêu có thể xây dựng dựa trên các biểu diễn đó thay vì phải học lại mọi thứ từ các ví dụ hạn chế.
Lợi ích phụ thuộc vào mức độ tương đồng giữa nhiệm vụ nguồn và nhiệm vụ mục tiêu, quy mô và chất lượng của việc huấn luyện trước, và cách mô hình được điều chỉnh. Việc tái sử dụng không được đảm bảo: các đặc trưng được chuyển giao có thể không liên quan hoặc thậm chí gây hại.
Trích xuất đặc trưng
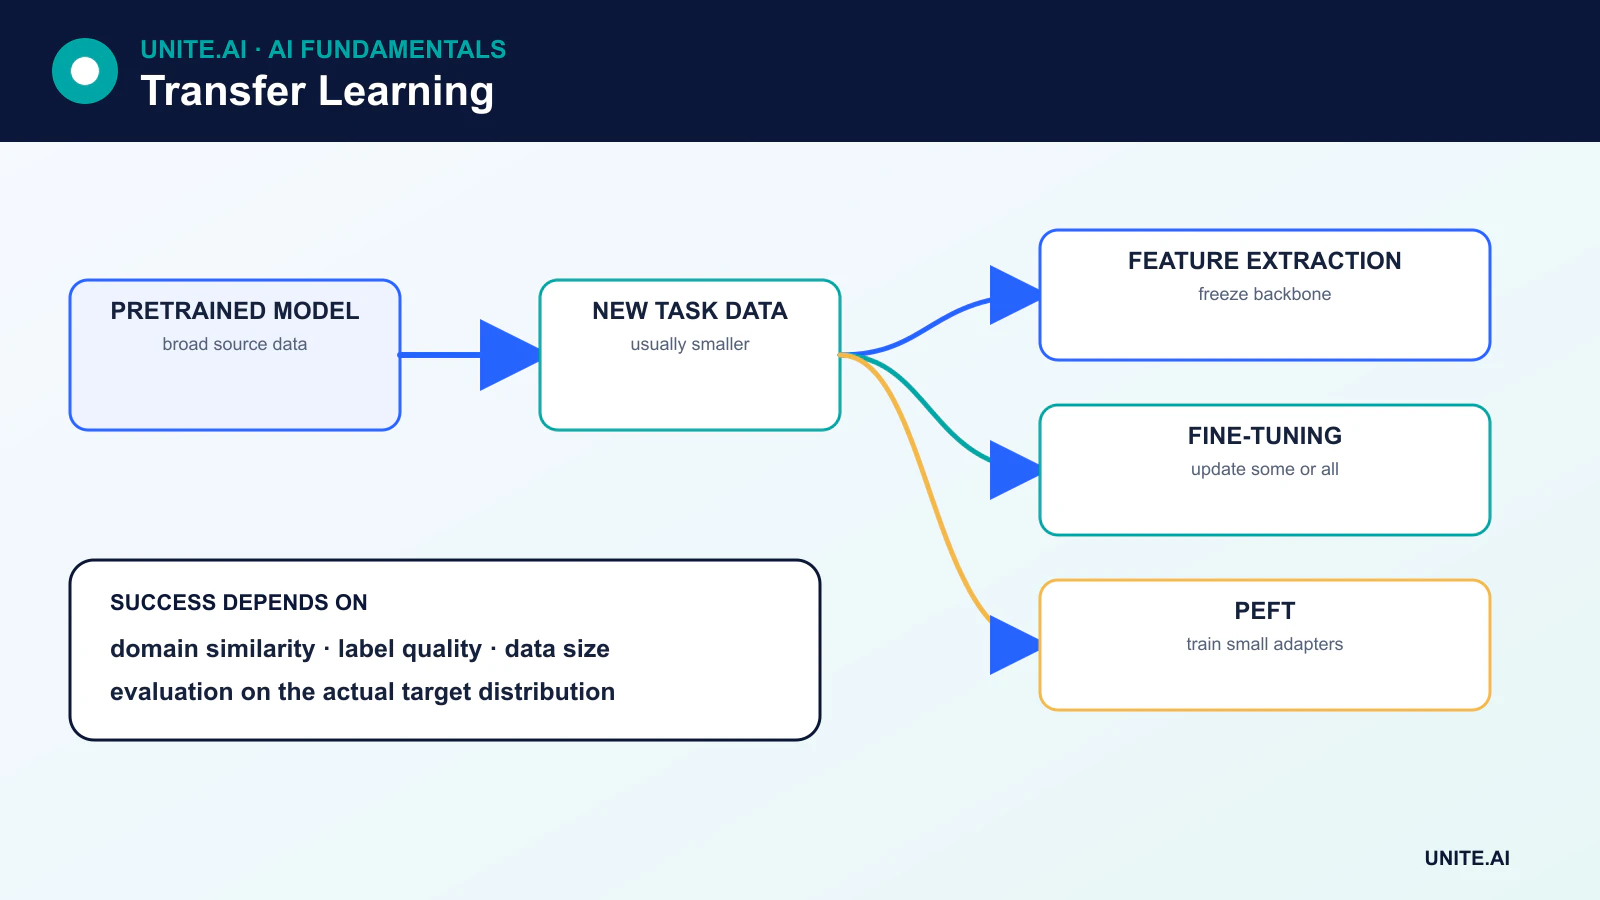
Trong trích xuất đặc trưng, mô hình cơ sở đã được huấn luyện trước được đóng băng nên các tham số của nó không thay đổi. Đầu ra của nó trở thành đầu vào cho một bộ phân loại, hồi quy hoặc đầu mới chuyên dụng cho nhiệm vụ khác. Chỉ đầu mới được huấn luyện.
Cách này nhanh và tiết kiệm dữ liệu, đồng thời giảm nguy cơ phá hủy các biểu diễn đã được huấn luyện có ích. Nó cũng có thể gây underfit khi miền mục tiêu khác biệt đáng kể so với việc huấn luyện trước. Các lớp như batch normalization đòi hỏi chú ý đặc biệt vì thống kê lưu trữ và hành vi đào tạo của chúng có thể ảnh hưởng đến việc thích nghi ngay cả khi hầu hết trọng số đã được đóng băng.
Tinh chỉnh (Fine-tuning)
Fine-tuning cập nhật các tham số đã được huấn luyện trước trên dữ liệu mục tiêu. Một quy trình phổ biến là:
- Load the pretrained model and replace or add the output head.
- Freeze the base and train the new head.
- Unfreeze selected layers—or the full model—and continue with a smaller learning rate.
- Validate for overfitting, forgetting, and target-domain performance.
Không có quy tắc chung nào cho rằng chỉ các lớp cuối cùng mới nên được tinh chỉnh. Lựa chọn tốt nhất phụ thuộc vào kiến trúc, kích thước dữ liệu mục tiêu, độ tương đồng miền, các lớp chuẩn hoá, bộ nhớ và tính toán. Tinh chỉnh toàn bộ có thể cung cấp nhiều khả năng hơn nhưng đòi hỏi nhiều tài nguyên hơn và có thể gây quên kiến thức thảm khốc.
Tinh chỉnh tiết kiệm tham số
Các mô hình transformers lớn làm cho việc tinh chỉnh toàn bộ trở nên tốn kém. Tinh chỉnh tiết kiệm tham số (PEFT) sửa đổi hoặc thêm một tập hợp nhỏ các tham số trong khi để phần lớn mô hình cơ sở vẫn đóng băng.
- Adapters chèn các mô-đun có thể huấn luyện nhỏ vào mạng.
- LoRA biểu diễn các cập nhật trọng số bằng ma trận hạng thấp, giảm số tham số có thể huấn luyện và bộ nhớ bộ tối ưu.
- Prompt và prefix tuning học các đầu vào liên tục chuyên dụng cho nhiệm vụ hoặc các tiền tố nội bộ.
PEFT có thể lưu trữ nhiều sự thích nghi nhiệm vụ quanh một mô hình cơ sở, mặc dù việc phục vụ suy luận, tính tương thích của adapters và quản lý trọng số hợp nhất vẫn đòi hỏi kỹ thuật cẩn thận.
Học chuyển giao qua các loại dữ liệu
Các bộ phân loại hình ảnh thường bắt đầu từ các mô hình đã được huấn luyện trên các tập dữ liệu hình ảnh lớn. Các hệ thống ngôn ngữ bắt đầu từ một mô hình nền tảng và điều chỉnh nó thông qua tinh chỉnh có giám sát, tối ưu hoá sở thích, truy xuất, hoặc sử dụng công cụ. Các mô hình âm thanh, âm nhạc, protein và đa phương tiện cũng tuân theo các mẫu tương tự.
Việc chuyển giao cũng có thể xảy ra mà không thay đổi mô hình gốc. Một mô hình đóng băng có thể tạo ra các embedding cho bộ phân loại hạ nguồn, một hệ thống vector similarity search, hoặc một quy trình truy xuất.
Sự dịch chuyển miền và chuyển giao tiêu cực
Domain shift xảy ra khi đầu vào mục tiêu khác với dữ liệu nguồn. Ví dụ, một mô hình hình ảnh y tế có thể gặp thiết bị, dân số, hoặc giao thức thu thập không có trong quá trình huấn luyện trước. Negative transfer nghĩa là việc tái sử dụng làm hiệu suất mục tiêu tệ hơn so với một mô hình từ đầu phù hợp.
Các nhóm nên so sánh các chiến lược thích nghi, đánh giá các nhóm phụ có ý nghĩa, và giữ một bộ test miền mục tiêu. Nếu nhiệm vụ nguồn không phù hợp, một mô hình chuyên biệt cho miền nhỏ hơn có thể vượt trội hơn mô hình chung lớn hơn.
Giấy phép, nguồn gốc và bảo mật
Một mô hình có thể tải xuống không tự động an toàn để triển khai. Kiểm tra giấy phép, các mục đích sử dụng được phép, tiết lộ dữ liệu huấn luyện, giới hạn trong model-card và chuỗi phụ thuộc. Các mô hình có thể tái tạo thiên kiến, ghi nhớ dữ liệu nhạy cảm, hoặc chứa mã độc được tuần tự hoá. Sử dụng các định dạng tin cậy, quét các artefact, và tải trọng số không tin cậy trong môi trường cách ly.
Khi nào nên sử dụng học chuyển giao
Học chuyển giao là lựa chọn mặc định mạnh mẽ khi có một mô hình đã được huấn luyện trước phù hợp và dữ liệu mục tiêu hạn chế. Huấn luyện từ đầu có thể ưu tiên khi miền rất chuyên biệt, giấy phép không tương thích, kích thước mô hình vượt quá giới hạn triển khai, hoặc một nhiệm vụ đơn giản không hưởng lợi từ biểu diễn lớn đã được huấn luyện trước. Quyết định nên được xác nhận thực nghiệm thay vì giả định dựa trên quy mô mô hình.
Những gì có thể chuyển giao và cách thích nghi chúng
Transfer learning tái sử dụng các biểu diễn đã học trên một nhiệm vụ hoặc tập dữ liệu nguồn cho một nhiệm vụ mục tiêu. Trong thị giác, các đặc trưng đầu tiên thường nắm bắt các cạnh và kết cấu; trong ngôn ngữ, các mô hình đã được huấn luyện trước mã hoá các mẫu thống kê trên các token và ngữ cảnh. Việc chuyển giao hoạt động khi các biểu diễn nguồn chứa thông tin liên quan đến mục tiêu, nhưng sự khác biệt về miền, nhãn, mô thức và cách thu thập có thể gây chuyển giao tiêu cực. Bắt đầu với một mô hình nền tảng đã được huấn luyện trước, kiểm tra giấy phép và tài liệu huấn luyện, và so sánh với việc huấn luyện một mô hình nhỏ chuyên dụng cho mục tiêu từ đầu.
Trích xuất đặc trưng đóng băng phần lõi và huấn luyện một đầu mới; tinh chỉnh một phần mở khóa các lớp được chọn; tinh chỉnh toàn bộ cập nhật toàn bộ mô hình. Các phương pháp tiết kiệm tham số thêm adapters hoặc cập nhật hạng thấp, giảm số tham số có thể huấn luyện nhưng không nhất thiết giảm bộ nhớ suy luận. Sử dụng tốc độ học thấp hơn cho trọng số đã được huấn luyện trước, duy trì hành vi chuẩn hoá, và tránh quên kiến thức thảm khốc bằng các lịch trình, regularization, rehearsal, hoặc cập nhật có hạn chế khi cần. Chọn các checkpoint dựa trên dữ liệu xác thực mục tiêu và thử nhiều seed vì các tập dữ liệu mục tiêu nhỏ tạo ra độ biến thiên cao.
Dữ liệu, đánh giá và các đánh đổi khi triển khai
Dữ liệu mục tiêu nên đại diện cho các điều kiện triển khai và các nhóm phụ quan trọng, không chỉ là một mẫu được gán nhãn thuận tiện. Phân chia theo đối tượng, nguồn, thời gian hoặc vị trí để ngăn các ví dụ liên quan vượt qua các phân vùng. Kiểm tra cả trong miền và trong các điều kiện dịch chuyển. So sánh các biến thể đóng băng, tinh chỉnh một phần và tinh chỉnh toàn bộ về chất lượng, hiệu chuẩn, chi phí huấn luyện, độ trễ và độ bền. Một cải thiện trong điểm trung bình có thể che giấu sự giảm hiệu suất trên các lớp hiếm do thiên lệch nguồn. Xem lại các ví dụ thất bại để phát hiện các lối tắt đặc thù nguồn, khoảng trống từ vựng, hoặc sự khác biệt cảm biến.
Theo dõi mô hình cơ sở, trọng số, tokenizer hoặc tiền xử lý, adapter, dữ liệu và giấy phép như một đồ thị phụ thuộc duy nhất. Các mô hình cơ sở được lưu trữ có thể thay đổi hành vi; trọng số mở có thể mang lại trách nhiệm về chuỗi cung ứng và vá lỗi. Xác thực artefact đã hợp nhất hoặc xuất ra và quét các tệp mô hình từ nguồn không tin cậy. Trong môi trường sản xuất, giám sát sự dịch chuyển và hiệu suất mục tiêu, và duy trì khả năng quay lại cả phiên bản thích nghi và phiên bản cơ sở. Học chuyển giao giảm nhu cầu dữ liệu mục tiêu; nó không loại bỏ việc gán nhãn, đánh giá, quyền riêng tư, hoặc chuyên môn miền.
Ví dụ thực tế: điều chỉnh mô hình thị giác cho một phòng khám mới
Một phòng khám điều chỉnh bộ mã hoá hình ảnh đã được huấn luyện trước để phân loại chất lượng hình ảnh trước khi đánh giá chẩn đoán. Nó xác minh giấy phép của mô hình nguồn và mô hình sử dụng, thu thập các thiết bị địa phương và điều kiện thu thập, và phân chia theo bệnh nhân. Các biến thể đóng băng đặc trưng, adapter, tinh chỉnh một phần và tinh chỉnh toàn bộ được so sánh với một mô hình nền tảng địa phương nhỏ. Các chỉ số bao gồm độ thu hồi lớp, hiệu chuẩn, hành vi nhóm phụ, tính toán, và độ nhạy đối với thiết bị, địa điểm và các artefact hiếm.
Mô hình đã điều chỉnh không thể đưa ra chẩn đoán và chuyển các hình ảnh có độ tin cậy thấp hoặc không được hỗ trợ cho các kỹ thuật viên. Xác thực xuất ra xác nhận tiền xử lý địa phương và tính tương đương số. Các phiên bản mô hình, adapter, thiết bị và tập dữ liệu được liên kết trong hồ sơ. Giám sát phát hiện các máy quét mới, thay đổi giao thức và dịch chuyển đầu ra, trong khi các mẫu được xem xét định kỳ ước tính hiệu suất thực tế. Nâng cấp mô hình nguồn được coi là một phụ thuộc mới cần xác thực; học chuyển giao không tự động biện minh cho việc tái sử dụng bằng chứng cũ.
Bằng chứng triển khai và sẵn sàng vận hành
Một quyết định sản xuất cần nhiều hơn một buổi trình diễn thành công. Xác định người dùng dự kiến, môi trường hoạt động, đầu vào, đầu ra, phụ thuộc, người sở hữu và hậu quả của mỗi lỗi quan trọng. Thiết lập một nền tảng có thể tái tạo và một bộ đánh giá có phiên bản trước khi tinh chỉnh. Kiểm tra các trường hợp thông thường, điều kiện biên, đầu vào sai định dạng hoặc thiếu, dịch chuyển phân phối, mất kết nối phụ thuộc, lạm dụng, và các nhóm hoặc môi trường có khả năng bị thiếu thốn. Đo lường chất lượng nhiệm vụ cùng với hiệu chuẩn hoặc độ không chắc, độ trễ, thông lượng, chi phí tài nguyên, khả năng tiếp cận, quyền riêng tư và bảo mật. Ghi lại mọi chuyển đổi và ngưỡng để một người đánh giá độc lập có thể tái tạo kết quả và phân biệt bằng chứng với một nguyên mẫu hấp dẫn.
Trước khi ra mắt, chỉ định quyền chịu trách nhiệm cho việc phát hành, ngoại lệ, thay đổi, quay lại và ngừng sử dụng. Sử dụng triển khai theo giai đoạn, duy trì một phương án dự phòng an toàn, và xác minh giám sát bằng cách chèn lỗi có chủ đích. Dữ liệu telemetry vận hành nên tiết lộ chất lượng đầu vào, hành vi đầu ra, phiên bản mô hình hoặc quy tắc, tình trạng phụ thuộc, can thiệp của con người, và kết quả đã xác nhận mà không thu thập dữ liệu nhạy cảm không cần thiết. Xác định ngưỡng cảnh báo và người chịu trách nhiệm phản hồi, sau đó xem xét bằng chứng thực tế sau khi triển khai thay vì giả định hiệu suất ngoại tuyến sẽ kéo dài. Đánh giá lại bất cứ khi nào nguồn dữ liệu, người dùng, mô hình, nhà cung cấp, chính sách, phần cứng, hoặc mục tiêu thay đổi. Một hệ thống được duy trì cũng cần có quy trình khôi phục, học hỏi từ sự cố, xóa và lưu trữ, và một điểm rõ ràng khi nó nên bị tắt hoặc thay thế.
Tài liệu tham khảo chính











