Nền tảng AI
Mô hình Ngôn ngữ Lớn (LLMs) là gì?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Mô hình ngôn ngữ lớn (LLM) là một mạng nơ-ron được huấn luyện trên các bộ sưu tập lớn các chuỗi để dự đoán token hoặc các mục tiêu ngôn ngữ liên quan. Hầu hết các LLM hiện nay sử dụng kiến trúc transformer và có thể tạo ra, phân loại, tóm tắt, dịch, truy xuất và chuyển đổi ngôn ngữ thông qua một giao diện chung.
LLM không phải là cơ sở dữ liệu hay một bộ suy luận được đảm bảo. Đầu ra của nó là một dự đoán có điều kiện được hình thành bởi dữ liệu huấn luyện, giai đoạn sau huấn luyện, ngữ cảnh, công cụ và quá trình giải mã. Độ trôi chảy có thể đồng thời tồn tại cùng với lỗi thực tế, sự không chắc chắn, thiên kiến hoặc hành vi không an toàn.
Những điểm chính
- Phân đoạn token chuyển đổi văn bản thành các đơn vị rời rạc; embedding và attention xây dựng các biểu diễn ngữ cảnh.
- Huấn luyện trước học các mẫu chung, trong khi tinh chỉnh và các phương pháp ưu tiên định hình hành vi cho nhiệm vụ.
- Truy xuất và công cụ có thể bổ sung bằng chứng hoặc hành động hiện tại, nhưng cần các quyền riêng và xác thực.
- Đánh giá hệ thống đã triển khai về chất lượng, tính nền tảng, an toàn, độ trễ, chi phí và sự trôi dạt.
Token, transformer và huấn luyện trước
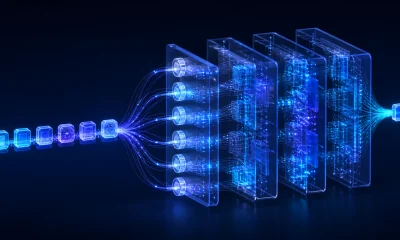
Văn bản được chia thành các token. Một transformer ánh xạ chúng thành các vector, trộn thông tin qua các lớp attention và feed-forward, và tạo ra một phân phối xác suất cho token tiếp theo hoặc token bị thiếu.
Mục tiêu tự giám sát tạo ra tín hiệu huấn luyện từ các chuỗi thô. Quy mô về tham số, dữ liệu và tính toán có thể cải thiện loss một cách dự đoán được trên các khoảng, nhưng chất lượng bộ dữ liệu, kiến trúc, tối ưu hoá và đánh giá quyết định những khả năng nào xuất hiện trong thực tế.
Sau huấn luyện và suy luận
Tinh chỉnh hướng dẫn sử dụng các ví dụ; tối ưu hoá ưu tiên có thể làm cho đầu ra phù hợp hơn với đánh giá của con người hoặc một chính sách. Khi suy luận, một prompt và lịch sử hội thoại xác định ngữ cảnh, trong khi nhiệt độ và cài đặt mẫu ảnh hưởng đến tính biến đổi.
RLHF và các phương pháp tương tự định hình hành vi thay vì cài đặt một bộ kiểm tra thực tế hoàn chỉnh. Mô hình vẫn có thể tạo ra câu trả lời có vẻ hợp lý nhưng không được hỗ trợ.
Truy xuất, công cụ và tác nhân
Việc tạo sinh tăng cường bằng truy xuất cung cấp các đoạn văn được chọn từ một bộ sưu tập bên ngoài. Gọi công cụ cho phép mã ứng dụng truy vấn cơ sở dữ liệu, tính toán, tìm kiếm hoặc thực hiện hành động. Các mẫu này tách một phần kiến thức và thực thi ra khỏi trọng số mô hình.
Ứng dụng phải xác thực các đối số công cụ, thực thi quyền hạn, bảo tồn trích dẫn và xem nội dung truy xuất như đầu vào không đáng tin cậy. Tìm kiếm tương đồng vector hỗ trợ truy xuất nhưng không chứng minh rằng một đoạn văn hỗ trợ câu trả lời.
Hạn chế và đánh giá
LLM có thể tạo ra thông tin ảo, tiết lộ nội dung đã ghi nhớ, tuân theo chỉ thị độc hại, tái tạo thiên kiến và thất bại trong các nhiệm vụ trông giống với ví dụ huấn luyện. Ngữ cảnh dài không đảm bảo mọi thực tế đều được sử dụng hoặc hòa giải đúng cách.
Đánh giá trên các nhiệm vụ riêng đại diện với các prompt và phiên bản được ghi chép. Đo lường sự hỗ trợ từ nguồn, việc từ chối, hiệu chuẩn, bảo mật, kết quả của các nhóm phụ, khối lượng công việc của con người, độ trễ và chi phí. Giám sát sau khi phát hành vì mô hình, dữ liệu và hành vi người dùng thay đổi.
Dữ liệu huấn luyện và phát triển mô hình
Các tập dữ liệu huấn luyện trước kết hợp các trang web, sách, mã nguồn, tài liệu học thuật, hội thoại và các nguồn có giấy phép hoặc được tuyển chọn. Quy trình phát hiện ngôn ngữ, loại bỏ trùng lặp, lọc chất lượng và nội dung không an toàn, xử lý dữ liệu cá nhân và chọn trọng số hỗn hợp. Những lựa chọn này định hình kiến thức, phạm vi ngôn ngữ, phong cách, thiên kiến và khả năng ghi nhớ.
Quá trình tối ưu hoá xử lý các lô chuỗi token và giảm thiểu loss dự đoán bằng gradient descent. Huấn luyện phân tán chia dữ liệu, tensor mô hình, các giai đoạn pipeline hoặc các chuyên gia qua các bộ tăng tốc. Việc lưu checkpoint, ổn định số học, giao tiếp mạng và phục hồi lỗi trở thành những mối quan tâm kỹ thuật lớn khi mở rộng.
Đánh giá trong quá trình huấn luyện theo dõi loss và các bộ khả năng, nhưng việc ô nhiễm benchmark có thể làm tăng kết quả. Giữ lại các khoảng thời gian và nhiệm vụ độc quyền, tìm kiếm sự trùng lặp, và báo cáo các prompt, quá trình giải mã, công cụ và cách chấm điểm chính xác. Một mô hình có thể cải thiện loss trung bình trong khi các hồi quy xuất hiện trong an toàn hoặc trong ngôn ngữ tài nguyên thấp.
Cửa sổ ngữ cảnh, giải mã và suy luận
Khi suy luận, bộ nhớ cache key–value lưu trữ các phép chiếu attention cho các token trước đó để chúng không cần được tính lại ở mỗi bước. Bộ nhớ cache tăng lên cùng với số lớp, độ dài chuỗi, batch và biểu diễn. Phân giải và paging giảm áp lực nhưng có thể thay đổi chất lượng hoặc độ trễ.
Giải mã tham lam chọn token có xác suất cao nhất; nhiệt độ điều chỉnh lại xác suất; top-k và top-p giới hạn tập hợp các ứng cử viên; beam search theo dõi nhiều chuỗi. Chiến lược tốt nhất phụ thuộc vào việc nhiệm vụ có ưu tiên tính quyết đoán, đa dạng, đầu ra có cấu trúc hay khả năng xuất hiện của chuỗi. Luôn xác thực schema sau khi sinh.
Ngữ cảnh dài tăng lượng thông tin có sẵn, không đảm bảo khả năng nhớ lại hoặc suy luận. Vị trí, yếu tố gây nhiễu, mâu thuẫn và cấu trúc prompt ảnh hưởng đến việc sử dụng. Truy xuất có thể chọn một tập bằng chứng nhỏ hơn, trong khi tóm tắt nén lịch sử với nguy cơ mất chi tiết. Đo lường hiệu năng trên các độ dài và vị trí ngữ cảnh khác nhau.
Thích nghi, triển khai và kinh tế
Tinh chỉnh toàn bộ cập nhật tất cả các tham số; các phương pháp hiệu quả về tham số cập nhật adapters hoặc ma trận hạng thấp; huấn luyện tiếp tục thích nghi với phân phối miền; hướng dẫn và tinh chỉnh ưu tiên định hình phản hồi. Truy xuất thường tốt hơn cho các thực tế thay đổi thường xuyên, trong khi tinh chỉnh tốt hơn cho hành vi và định dạng nhiệm vụ. Các phương pháp có thể kết hợp với nhau.
Các lựa chọn triển khai bao gồm API được lưu trữ, điểm cuối được quản lý, trọng số mở tự lưu trữ, mô hình trên thiết bị và các dạng lai. So sánh việc xử lý dữ liệu, kiểm soát phiên bản, độ trễ, thông lượng, khu vực, khả dụng, khả năng di chuyển mô hình, hỗ trợ và tổng chi phí. Tự lưu trữ chuyển giao trách nhiệm về bảo mật, mở rộng, cập nhật và giám sát lạm dụng.
Chi phí trên mỗi token là không đầy đủ. Một mô hình yếu có thể yêu cầu thử lại, prompt dài hơn, nhiều kiểm tra hơn hoặc lỗi tốn kém. Đo lường chi phí trên mỗi nhiệm vụ hoàn thành thành công với chất lượng và mức rủi ro yêu cầu. Sử dụng caching, batching, các mô hình định tuyến nhỏ hơn và mã quyết đoán khi chúng cải thiện toàn bộ quy trình làm việc.
Ví dụ thực tế: gắn LLM vào tài liệu doanh nghiệp
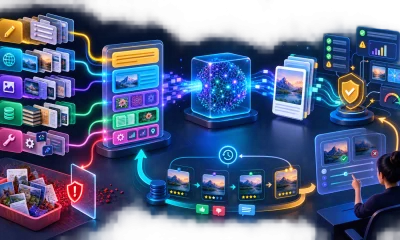
Trợ lý tài liệu nên bắt đầu với một tập hợp văn bản có quyền truy cập rõ ràng, các định danh tài liệu ổn định, phiên bản và ngày hiệu lực, cấu trúc có thể phân tích, và một bộ đánh giá gồm các câu hỏi có thể trả lời, không thể trả lời, mơ hồ và mâu thuẫn. Chỉ mục truy xuất chia thành các đoạn và siêu dữ liệu, nhưng kích thước và độ chồng chéo của đoạn phải phù hợp với cấu trúc tài liệu. Chất lượng tìm kiếm được đo độc lập trước khi sinh để một mô hình trôi chảy không thể che giấu bằng chứng thiếu sót.
Khi chạy, xác thực người dùng, lọc truy xuất theo quyền truy cập, truy xuất và sắp xếp lại bằng chứng, xây dựng một prompt có giới hạn, tạo câu trả lời có trích dẫn và xác thực đầu ra yêu cầu. Mô hình nên nêu rõ khi các nguồn mâu thuẫn hoặc không hỗ trợ câu trả lời. Việc sử dụng công cụ và các hành động bên ngoài yêu cầu ủy quyền riêng. Bảo vệ khỏi các chỉ thị nhúng trong tài liệu đã truy xuất bằng cách xem nội dung như dữ liệu chứ không phải chính sách hệ thống có ưu tiên cao hơn.
Đánh giá độ nhớ lại của truy xuất, độ chính xác của trích dẫn, tính đúng đắn của câu trả lời, tính nền tảng, việc từ chối, độ trễ và chi phí trên các vai trò và loại tài liệu. Theo dõi các phiên bản mô hình, prompt, chỉ mục, trình phân tích và tập hợp dữ liệu cho mỗi thử nghiệm. Trong môi trường sản xuất, ghi lại ID bằng chứng và phản hồi mà không tiết lộ văn bản riêng tư, giám sát các câu hỏi mới không thể trả lời sau khi nội dung thay đổi, và duy trì một phương án dự phòng an toàn. Giao diện LLM không thay thế việc quản lý hồ sơ, kiểm soát truy cập, hay đánh giá chịu trách nhiệm của chuyên gia.
Kế hoạch năng lực nên mô hình hoá phân phối độ dài prompt và đầu ra, số người dùng đồng thời, hành vi cache, độ trễ công cụ và tỷ lệ thử lại. Streaming cải thiện độ trễ cảm nhận nhưng làm phức tạp việc kiểm duyệt và hủy bỏ vì nội dung không an toàn hoặc không chính xác có thể tới người dùng trước khi toàn bộ phản hồi được kiểm tra. Đặt ngân sách token và công cụ, cô lập các tenant, bảo vệ thông tin đăng nhập của nhà cung cấp, và diễn tập chuyển đổi dự phòng giữa các phiên bản mô hình mà không thay đổi âm thầm hành vi mà người dùng phụ thuộc.
Danh sách kiểm tra triển khai thực tế
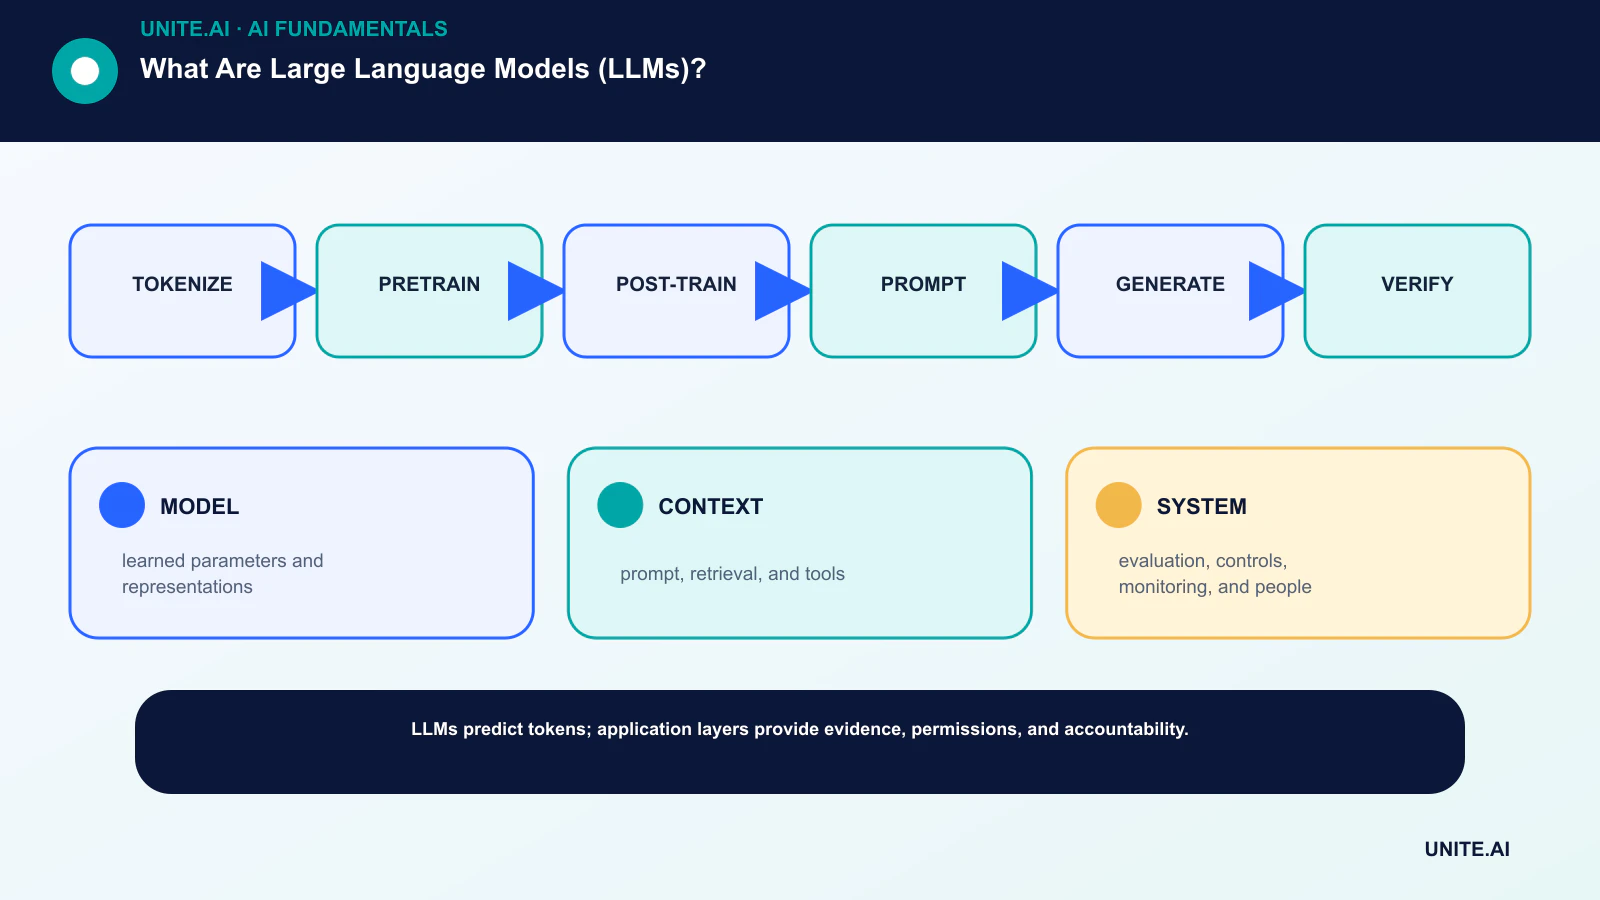
Biến ý tưởng thành một quy trình làm việc có giới hạn, có thể kiểm thử: token hoá → huấn luyện trước → huấn luyện sau → prompt → sinh → xác thực. Chỉ định một người chịu trách nhiệm, ghi chép dữ liệu và các phụ thuộc, thiết lập một baseline đơn giản, đặt tiêu chí chấp nhận và dừng, kiểm thử các lỗi đại diện, và định nghĩa việc giám sát, quay lại và đánh giá trước khi mở rộng phạm vi. Ghi lại các phiên bản và giả định để đội khác có thể tái tạo kết quả và hiểu những gì đã thay đổi.
Trước khi ra mắt, thực hiện một cuộc đánh giá sẵn sàng được ghi chép với những người xây dựng, vận hành, bảo mật và bị ảnh hưởng bởi hệ thống. Kiểm thử các trường hợp bình thường, điều kiện biên, lỗi phụ thuộc và lạm dụng; bảo quản bằng chứng và rủi ro chưa giải quyết. Xác định ai có thể phê duyệt phát hành, thay đổi ngưỡng, ghi đè đầu ra hoặc dừng hoạt động. Xem lại quyết định sau khi dữ liệu thực tế đến, vì một dự án thí điểm kỹ thuật thành công không đảm bảo hiệu suất đáng tin cậy ở quy mô rộng hơn.
- MÔ HÌNH: các tham số và biểu diễn đã học.
- NGỮ CẢNH: prompt, truy xuất và công cụ.
- HỆ THỐNG: đánh giá, kiểm soát, giám sát và con người.
Câu hỏi thường gặp
Tại sao LLM được gọi là lớn?
Không có ngưỡng tham số chung. ‘Lớn’ đề cập đến quy mô so với các mô hình ngôn ngữ trước đây, bao gồm số tham số, dữ liệu huấn luyện, tính toán và phạm vi sử dụng.
LLM có hiểu ngôn ngữ không?
Chúng xây dựng các biểu diễn nội bộ hữu ích và thể hiện hành vi phức tạp, nhưng từ ‘hiểu’ có nhiều nghĩa. Hiệu suất nên được chứng minh từng nhiệm vụ thay vì suy ra từ độ trôi chảy.
Tài liệu tham khảo chính