Nền tảng AI
Mạng Đối Kháng Sinh Tạo (GAN) là gì?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
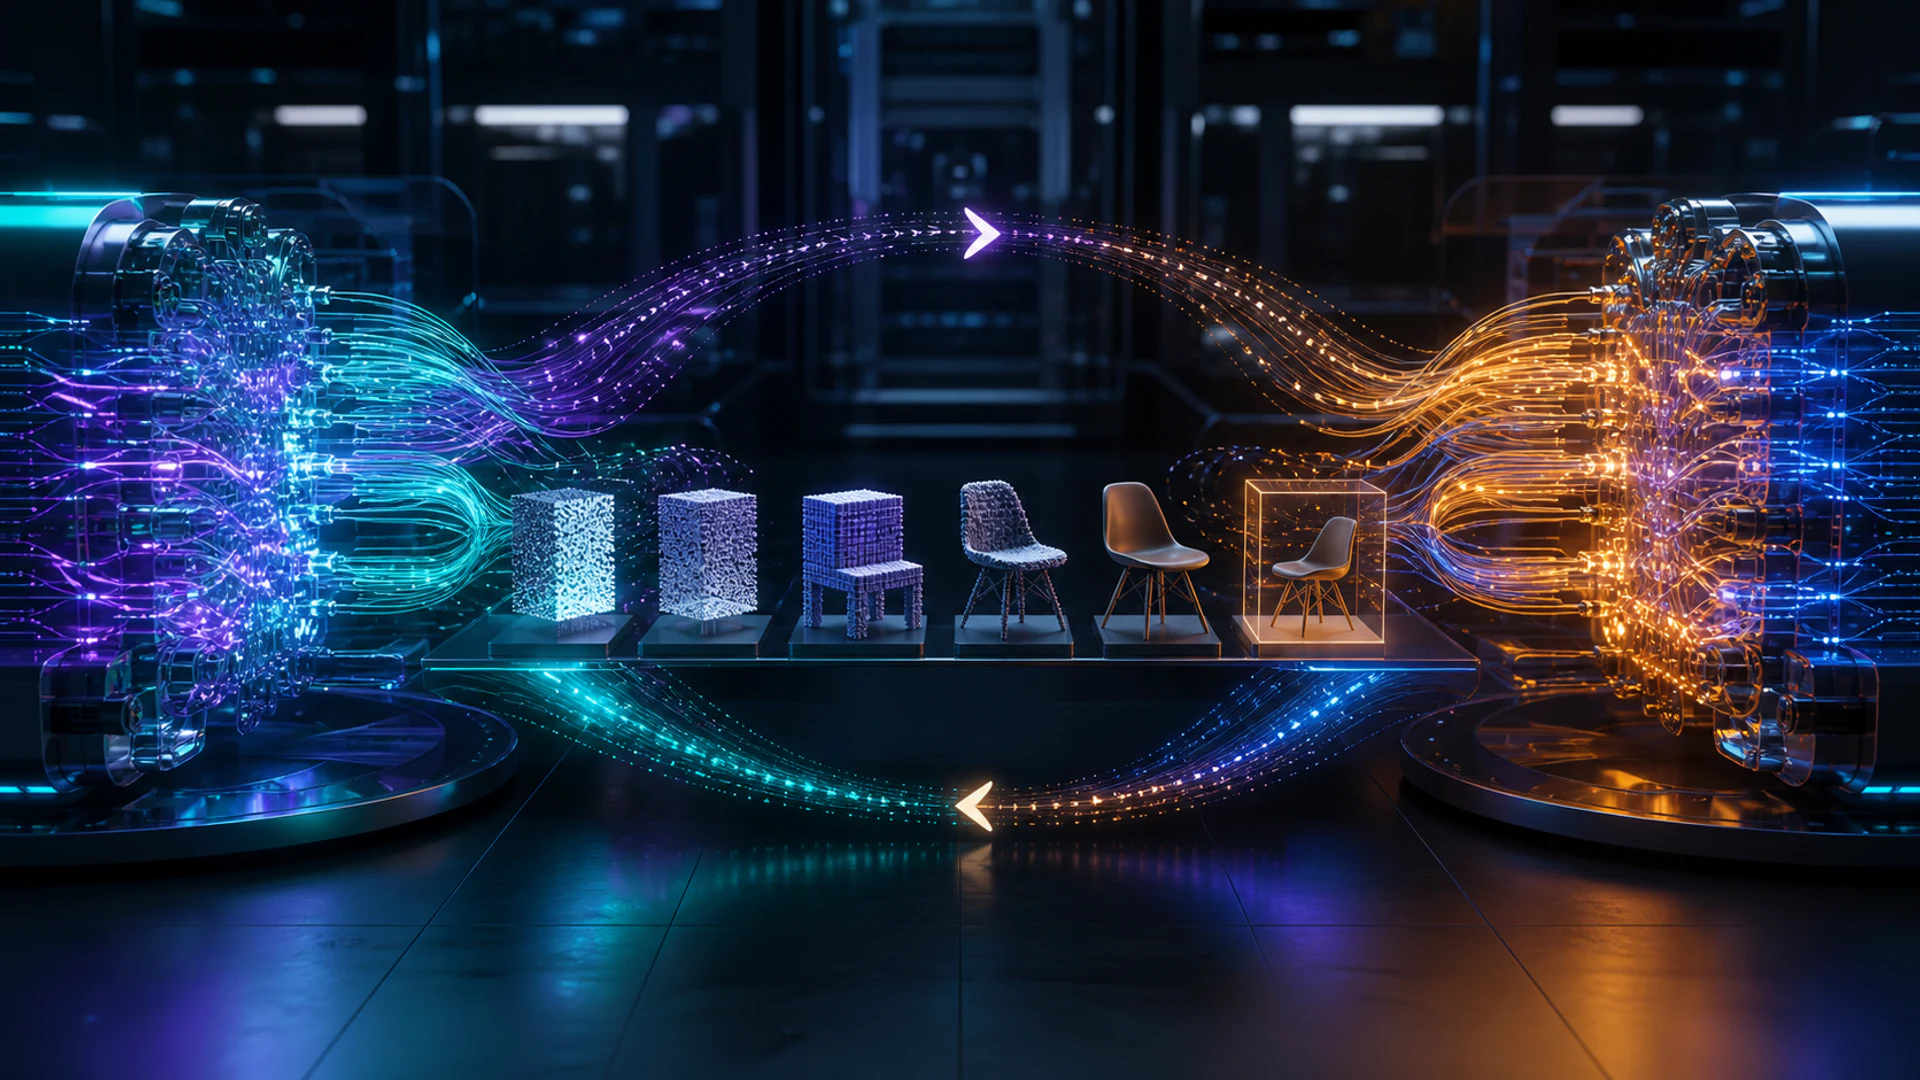
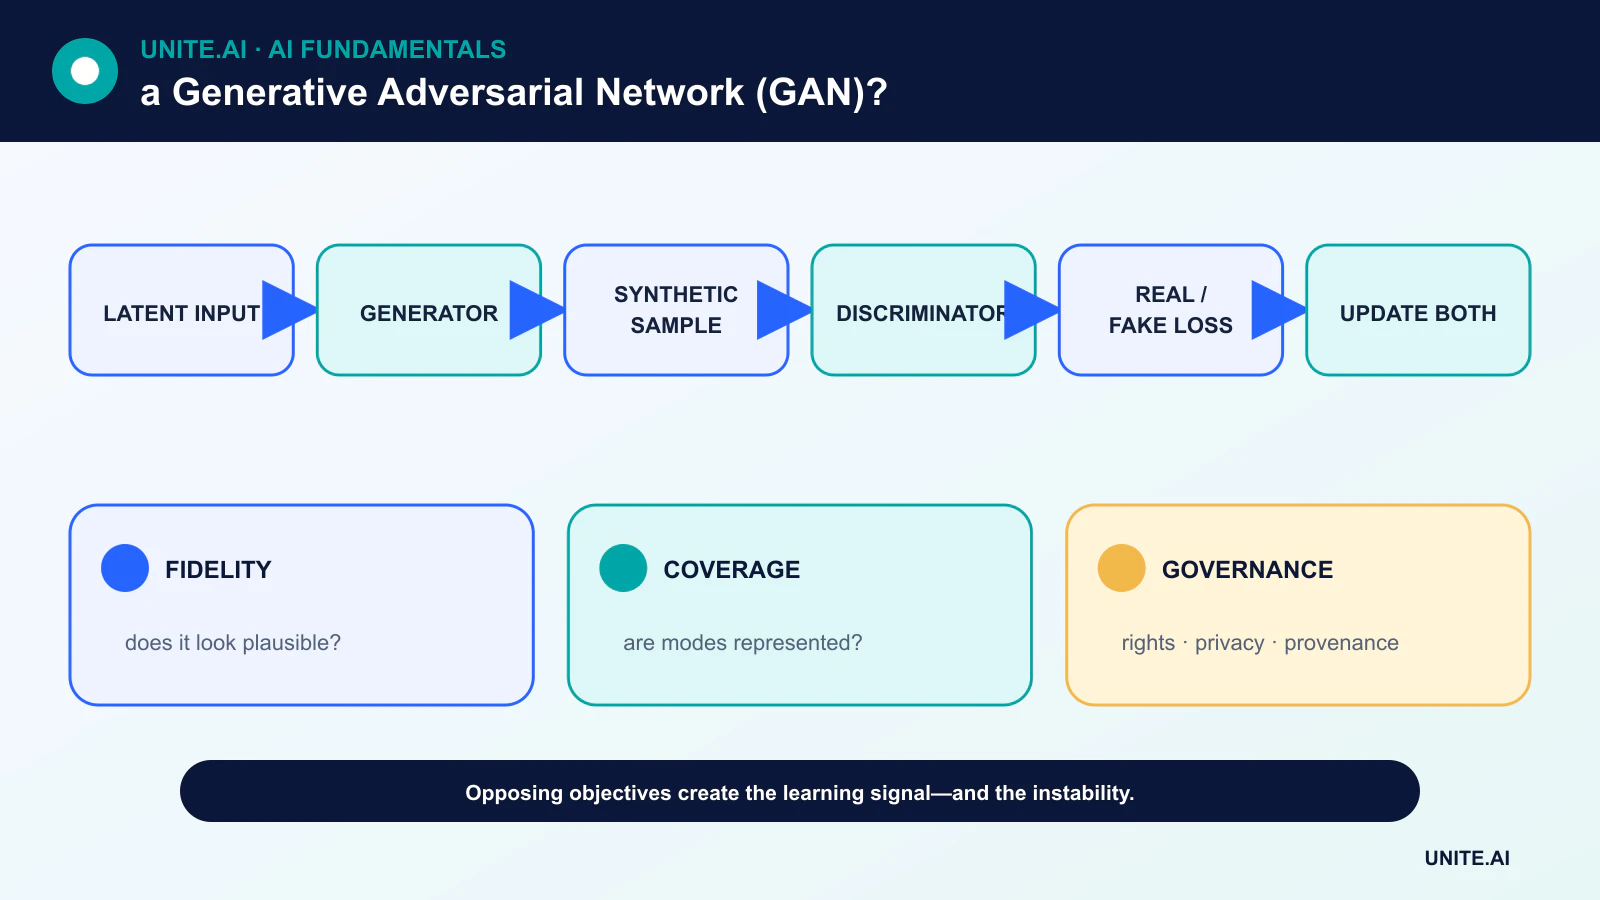
Một mạng đối kháng sinh tạo (GAN) đào tạo hai mạng nơ-ron trong cạnh tranh. Bộ tạo chuyển đổi đầu vào ngẫu nhiên hoặc có điều kiện thành các mẫu tổng hợp. Bộ phân biệt cố gắng phân biệt các mẫu được tạo ra với các ví dụ huấn luyện thực. Phản hồi của mỗi mạng thay đổi vấn đề học của mạng còn lại.
GAN có thể tạo ra hình ảnh sắc nét và dữ liệu tổng hợp có thể kiểm soát, nhưng việc đào tạo đối kháng khó ổn định. Độ thực tế về hình ảnh không chứng minh tính đa dạng, tính đúng thực hay quyền sử dụng dữ liệu huấn luyện.
Những điểm chính
- Bộ tạo tạo ra các mẫu; bộ phân biệt học một tín hiệu quyết định thực so với tạo ra.
- Việc đào tạo tìm kiếm một trạng thái cân bằng, nhưng việc thay đổi đối thủ có thể gây ra sự không ổn định, dao động hoặc sụp chế độ.
- GAN có điều kiện kiểm soát việc tạo ra bằng nhãn, văn bản hoặc ngữ cảnh khác.
- Đánh giá nên kiểm tra độ trung thực, độ bao phủ, việc ghi nhớ và rủi ro downstream — không chỉ chất lượng hình ảnh.
Trò chơi đối kháng
Công thức gốc là một trò chơi hai người chơi dạng minimax. Bộ phân biệt cải thiện khả năng tách dữ liệu thực khỏi dữ liệu tạo ra, trong khi bộ tạo cải thiện việc tạo các mẫu mà bộ phân biệt phân loại là thực. Cả hai đều được đào tạo bằng lan truyền ngược.
Nếu bộ phân biệt trở nên quá chính xác, phản hồi của nó cho bộ tạo có thể không hữu ích. Nếu nó quá yếu, bộ tạo có thể lợi dụng các lối tắt dễ dàng. Do đó, quá trình đào tạo luân phiên cập nhật và cân bằng cẩn thận khả năng, hàm mất mát và cài đặt tối ưu hoá.
Sụp chế độ và độ ổn định trong đào tạo
Sụp chế độ xảy ra khi nhiều đầu vào tiềm ẩn tạo ra các đầu ra tương tự nhau, vì vậy các mẫu trông hợp lý nhưng chỉ bao phủ một phần của phân phối dữ liệu. Các lỗi khác bao gồm dao động, gradient bùng nổ và độ nhạy với khởi tạo ngẫu nhiên.
Các mục tiêu Wasserstein, hình phạt gradient, chuẩn hoá phổ, thay đổi kiến trúc và tỷ lệ cập nhật được điều chỉnh có thể cải thiện độ ổn định. Tuy nhiên chúng không loại bỏ nhu cầu kiểm tra tính đa dạng và lặp lại thí nghiệm với nhiều seed.
Tạo dữ liệu có điều kiện và kiểm soát tiềm ẩn
GAN có điều kiện cung cấp cho bộ tạo và bộ phân biệt một nhãn hoặc ngữ cảnh khác, cho phép tạo ra các lớp hoặc thuộc tính mục tiêu. Kiến trúc dựa trên phong cách tách các khía cạnh của kiểm soát tiềm ẩn ở các độ phân giải khác nhau và đã tạo ra những hình ảnh cực kỳ thực tế.
Các hướng tiềm ẩn có thể tương quan với các khái niệm của con người, nhưng việc chỉnh sửa một thuộc tính có thể thay đổi các thuộc tính khác vì dữ liệu huấn luyện chứa các đặc trưng có liên quan. Các tuyên bố về khả năng kiểm soát nên được kiểm nghiệm trên nhiều danh tính và ngữ cảnh đa dạng.
Đánh giá, quyền riêng tư và nguồn gốc
Các chỉ số như Fréchet Inception Distance so sánh các phân phối đặc trưng, nhưng chúng kế thừa các giả định từ mô hình đặc trưng và có thể bỏ lỡ việc ghi nhớ hoặc các lỗi nhóm phụ. Phân tích lân cận nhất, các kiểm tra độ bao phủ kiểu precision/recall và đánh giá của con người cung cấp bằng chứng bổ sung.
GAN có thể ghi nhớ các ví dụ hiếm, tái tạo thiên lệch hoặc tạo ra phương tiện gây lừa dối. Các nhóm nên ghi chép dữ liệu, quyền, lọc, dấu nước hoặc cơ chế nguồn gốc và kiểm soát việc lạm dụng. Dữ liệu tổng hợp không tự động ẩn danh.
GAN, VAE và mô hình khuếch tán
Variational autoencoders tối ưu một mục tiêu tiềm ẩn dựa trên khả năng và thường đánh đổi độ sắc nét của mẫu để có không gian tiềm ẩn có cấu trúc. Các mô hình khuếch tán học cách đảo ngược quá trình nhiễu và đã trở thành nền tảng phổ biến cho việc tạo hình ảnh.
GAN vẫn hữu ích khi cần lấy mẫu nhanh một lần, các ánh xạ hình ảnh-đối-ảnh cụ thể hoặc triển khai gọn nhẹ. Phương pháp phù hợp phụ thuộc vào chất lượng, tính đa dạng, độ trễ, độ ổn định trong đào tạo và quản trị — không phải dựa trên kiến trúc mới nhất.
Mục tiêu đối kháng và động lực đào tạo
Mạng đối kháng sinh tạo đào tạo một bộ tạo để tạo ra các mẫu và một bộ phân biệt để phân biệt dữ liệu tạo ra với dữ liệu thực. Trong trò chơi minimax gốc, bộ phân biệt ước tính một tín hiệu liên quan tới tỉ lệ mật độ và bộ tạo cố gắng lừa nó. Đào tạo luân phiên cập nhật, vì vậy mỗi mạng học đối đầu với một đối thủ đang di chuyển thay vì một hàm mất mát cố định. Nếu bộ phân biệt trở nên quá mạnh, gradient của bộ tạo có thể trở nên không hữu ích; nếu quá yếu, chất lượng mẫu tạo ra sẽ trì trệ. Giá trị loss một mình không tương ứng trực tiếp với chất lượng mẫu.
Sụp chế độ xảy ra khi bộ tạo tạo ra các biến thể hạn chế mà vẫn lừa được bộ phân biệt. Dao động, độ nhạy với siêu tham số và chuẩn hoá không ổn định cũng thường gặp. Các mục tiêu Wasserstein, hình phạt gradient, chuẩn hoá phổ, khớp đặc trưng, thống kê minibatch và lịch cập nhật cân bằng cẩn thận giải quyết các cơ chế thất bại khác nhau. GAN có điều kiện sử dụng nhãn, văn bản hoặc hình ảnh để hướng đầu ra; kiến trúc dựa trên phong cách tách các ảnh hưởng tiềm ẩn. Chất lượng và độ bao phủ của bộ dữ liệu vẫn là nền tảng vì bộ tạo tái tạo và kết hợp lại phân phối mà nó nhìn thấy.
Đánh giá và sử dụng có trách nhiệm
Đánh giá độ trung thực và tính đa dạng riêng biệt. Fréchet Inception Distance so sánh các phân phối đặc trưng nhưng phụ thuộc vào kích thước mẫu, mô hình đặc trưng, tiền xử lý và miền; Inception Score bỏ qua so sánh với dữ liệu thực. Precision và recall cho các mô hình sinh, phân tích lân cận nhất, kiểm tra ghi nhớ và đánh giá nhiệm vụ của con người cung cấp bằng chứng bổ sung. Đối với tổng hợp khoa học hoặc y tế, sử dụng các chỉ số miền và xác thực downstream. Giữ một tập dữ liệu thực được tách ra và so sánh với các baseline khuếch tán hoặc tự hồi quy ở mức tính toán và độ phân giải tương đương.
GAN có thể tăng cường dữ liệu, chuyển đổi miền, siêu phân giải hình ảnh, tổng hợp phương tiện và hỗ trợ mô phỏng, nhưng dữ liệu tổng hợp có thể làm tăng thiên lệch hoặc rò rỉ các ví dụ huấn luyện. Xác minh giấy phép, sự đồng ý, danh tính và nguồn gốc. Bảo vệ khỏi việc mạo danh không có sự đồng ý và sử dụng lừa dối, gắn nhãn hoặc ký kết đầu ra khi cần, và giữ siêu dữ liệu sinh. Một hình ảnh photorealistic không phải là bằng chứng tài liệu; sự không chắc chắn và nguồn gốc tổng hợp phải được hiển thị khi đầu ra ảnh hưởng đến quyết định.
Triển khai và tái tạo
Ghi lại bộ tạo, bộ phân biệt, bộ tối ưu, bộ dữ liệu, seed ngẫu nhiên, mức cắt và cài đặt lấy mẫu. Việc lượng tử hoá hoặc xuất ra có thể thay đổi chuẩn hoá và đầu ra, vì vậy cần xác thực artefact phục vụ. Giám sát phân phối prompt hoặc điều kiện, bộ lọc an toàn, đa dạng đầu ra, độ trễ và báo cáo. Sử dụng giới hạn tốc độ và biện pháp bảo vệ danh tính trong các hệ thống công cộng. Đào tạo GAN là một thí nghiệm tối ưu hoá kết hợp: các hình ảnh minh họa được chọn không thể khẳng định độ bền, độ bao phủ hoặc không có ghi nhớ, và một mô hình nên được đánh giá trên toàn bộ phân phối của các nhiệm vụ sinh dự định.
Ví dụ thực tế: hình ảnh khuyết tật tổng hợp bằng GAN
Một nhà sản xuất đào tạo một GAN có điều kiện để tạo ra các hình ảnh khuyết tật bề mặt hiếm. Họ xác minh rằng các hình ảnh huấn luyện có quyền và tách các lô sản xuất trước khi đào tạo và đánh giá. Các mẫu được tạo ra được kiểm tra về ghi nhớ lân cận nhất, hình học khuyết tật, các hiện tượng nền, tính đa dạng và tính khả thi theo chuyên gia. Một bộ phân loại được đào tạo với dữ liệu tổng hợp được đánh giá chỉ trên các khuyết tật thực độc lập, so sánh với cùng bộ phân loại sử dụng tăng cường truyền thống.
Dữ liệu tổng hợp chỉ được chấp nhận nếu độ thu hồi trong thực tế cải thiện mà không tăng các trường hợp từ chối sai hoặc lỗi nhóm phụ. Cài đặt sinh và nguồn gốc vẫn được gắn vào mỗi hình ảnh, và các tệp tổng hợp không bao giờ vào tập kiểm tra hoặc kho lưu trữ bằng chứng như các kiểm tra thực. Các nhà vận hành không thể sử dụng bộ tạo để tạo hồ sơ kiểm toán giả. Nhóm so sánh các lựa chọn khuếch tán và chi phí thu thập thêm các ví dụ thực, nhận ra rằng vẻ ngoài thực tế không chứng minh rằng GAN đã nắm bắt được quá trình hỏng hóc vật lý.
Bằng chứng triển khai và sẵn sàng vận hành
Một quyết định sản xuất cần nhiều hơn một buổi trình diễn thành công. Xác định người dùng dự kiến, môi trường hoạt động, đầu vào, đầu ra, phụ thuộc, chủ sở hữu và hậu quả của mỗi lỗi quan trọng. Thiết lập một baseline có thể tái tạo và một tập đánh giá có phiên bản trước khi tinh chỉnh. Kiểm tra các trường hợp thường, điều kiện biên, đầu vào sai dạng hoặc thiếu, sự dịch chuyển phân phối, mất phụ thuộc, lạm dụng, và các nhóm hoặc môi trường có khả năng bị thiếu dịch vụ. Đo lường chất lượng nhiệm vụ cùng với hiệu chuẩn hoặc độ không chắc, độ trễ, thông lượng, chi phí tài nguyên, khả năng tiếp cận, quyền riêng tư và bảo mật. Ghi lại mọi biến đổi và ngưỡng để một người đánh giá độc lập có thể tái tạo kết quả và phân biệt bằng chứng với một nguyên mẫu hấp dẫn.
Trước khi ra mắt, chỉ định quyền cho việc phát hành, ngoại lệ, thay đổi, quay lại và ngừng hoạt động. Sử dụng triển khai theo giai đoạn, duy trì một phương án dự phòng an toàn, và xác thực giám sát bằng các lỗi được tiêm có chủ đích. Dữ liệu đo lường vận hành nên tiết lộ chất lượng đầu vào, hành vi đầu ra, phiên bản mô hình hoặc quy tắc, trạng thái phụ thuộc, can thiệp của con người và kết quả đã xác nhận mà không thu thập dữ liệu nhạy cảm không cần thiết. Xác định ngưỡng cảnh báo và người chịu trách nhiệm phản hồi, sau đó xem xét bằng chứng thực tế sau khi triển khai thay vì giả định hiệu năng offline sẽ kéo dài. Đánh giá lại mỗi khi nguồn dữ liệu, người dùng, mô hình, nhà cung cấp, chính sách, phần cứng hoặc mục tiêu thay đổi. Một hệ thống được duy trì cũng cần có tài liệu phục hồi, học hỏi từ sự cố, quy trình xóa và lưu trữ, và một điểm rõ ràng khi nó nên bị vô hiệu hoá hoặc thay thế.
Câu hỏi thường gặp
GAN có hiểu các hình ảnh nó tạo ra không?
GAN học cấu trúc thống kê hữu ích cho việc tạo ra. Điều đó không tự nó chứng minh khả năng hiểu ngữ nghĩa hoặc nguyên nhân giống như con người.
Các mẫu được tạo bởi GAN có an toàn để sử dụng làm dữ liệu huấn luyện không?
Chỉ sau khi kiểm tra độ bao phủ, tính hợp lệ của nhãn, việc ghi nhớ, thiên lệch và liệu phân phối tổng hợp có hỗ trợ trên một tập kiểm tra thực được tách ra hay không.
Tài liệu tham khảo chính