
Nền tảng AI
NPU là gì? Giải thích về Neural Processing Units

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
NPU là một bộ tăng tốc chuyên dụng được thiết kế để thực thi các phép toán mạng nơ-ron phổ biến một cách hiệu quả. Trong điện thoại, máy tính cá nhân, xe hơi, camera và các hệ thống nhúng, nó có thể chạy các khối lượng công việc AI được hỗ trợ với mức tiêu thụ năng lượng thấp hơn hoặc giải phóng CPU và GPU cho các nhiệm vụ khác.
NPU là một thuật ngữ rộng trong ngành chứ không phải một kiến trúc duy nhất. Hiệu năng phụ thuộc vào các toán tử được hỗ trợ, định dạng số, bộ nhớ, trình biên dịch và thời gian chạy, giới hạn nhiệt, và mức độ mà một ứng dụng có thể duy trì trên bộ tăng tốc.
Những điểm chính
- NPUs tập trung vào các phép toán ma trận, vector và tensor với khả năng tái sử dụng dữ liệu cao và tiêu thụ điện năng thấp.
- TOPS tối đa không phải là một chuẩn đoán toàn bộ ứng dụng và có thể giả định độ chính xác hoặc độ thưa nhất định.
- Một mô hình có thể cần chuyển đổi, lượng tử hoá, phân chia đồ thị và dự phòng cho các phép toán không được hỗ trợ.
- So sánh độ trễ, thông lượng, năng lượng, bộ nhớ, chất lượng, quyền riêng tư và khả năng di chuyển trên khối lượng công việc thực tế.
Vai trò của CPU, GPU và NPU
CPU xuất sắc trong việc điều khiển luồng chung và tính tương thích rộng. GPU cung cấp khả năng xử lý song song có thể lập trình và hệ sinh thái phần mềm phong phú. NPU chuyên thực hiện các phép toán tensor lặp lại và có thể bao gồm bộ nhớ cục bộ, mảng nhân‑cộng cộng, và luồng dữ liệu được tối ưu cho suy luận.
Hệ thống hỗn hợp sẽ lên lịch các phần khác nhau ở vị trí phù hợp nhất. Điều này quan trọng đối với edge AI, nơi mà năng lượng liên tục và khả năng phản hồi có thể quan trọng hơn so với thông lượng tối đa của trung tâm dữ liệu.
Biên dịch và thực thi mô hình
Một đồ thị khung được chuyển đổi thành biểu diễn trung gian, tối ưu, lượng tử hoá khi cần, và biên dịch cho các toán tử được hỗ trợ. Thời gian chạy có thể phân chia đồ thị để các lớp không được hỗ trợ thực thi trên CPU hoặc GPU.
Việc chuyển dữ liệu giữa các bộ xử lý có thể làm mất lợi thế của bộ tăng tốc. Các hình dạng tĩnh, bố cục, độ chính xác, batch và việc tái sử dụng bộ nhớ đều ảnh hưởng đến hiệu năng. Hãy kiểm tra artefact đã biên dịch vì chất lượng mô hình deep-learning có thể thay đổi sau khi chuyển đổi.
Hiểu về TOPS và các tuyên bố hiệu suất
TOPS báo cáo hàng nghìn tỷ phép toán mỗi giây dựa trên các giả định nhất định. Các nhà cung cấp có thể tính riêng phép nhân và phép cộng, sử dụng độ chính xác số nguyên bít thấp, hoặc giả định độ thưa. Một con số cao hơn không đảm bảo độ trễ thấp hơn cho một mô hình cụ thể.
Đo thời gian khởi động lạnh và ấm, độ trễ mỗi truy vấn, thông lượng, năng lượng, bộ nhớ tối đa, giảm tốc nhiệt, kích thước ngữ cảnh hoặc ảnh được hỗ trợ, và tỷ lệ phần đồ thị được tăng tốc. Sử dụng độ chính xác và phiên bản phần mềm tương đương.
Các đánh đổi AI trên thiết bị
Thực thi cục bộ có thể giảm phụ thuộc vào mạng và giữ dữ liệu đầu vào thô trên thiết bị, nhưng các mô hình đã tải xuống, nhật ký, sao lưu và các phương án dự phòng đám mây vẫn tạo ra luồng dữ liệu. Việc cung cấp mô hình an toàn và cập nhật nền tảng vẫn là cần thiết.
NPU có thể hỗ trợ các ứng dụng thị giác, âm thanh, ngôn ngữ và cảm biến, bao gồm các khối lượng công việc liên quan đến TinyML. Các nhà phát triển nên thiết kế dự phòng linh hoạt và thông báo khi quá trình xử lý chuyển ra ngoài thiết bị.
Kiến trúc NPU và các phép toán được hỗ trợ
Một NPU tăng tốc các phép toán tensor bằng cách sử dụng các mảng đơn vị nhân‑cộng cộng, bộ nhớ cục bộ, lập lịch luồng dữ liệu và các định dạng số chuyên biệt. Giữ trọng số và kích hoạt gần bộ tính toán giảm thiểu việc di chuyển dữ liệu tốn kém. Các thiết bị thực tế khác nhau về hỗ trợ toán tử, hệ thống bộ nhớ, độ chính xác, độ thưa, khả năng lập trình, và cách chia sẻ công việc với CPU và GPU.
Hiệu năng tối đa thường được quảng cáo bằng TOPS, nhưng TOPS không chỉ định độ chính xác, mức sử dụng, giới hạn bộ nhớ, phạm vi toán tử, hay độ trễ toàn bộ. Hai bộ xử lý có cùng con số tiêu đề có thể hoạt động khác nhau trên cùng một mô hình. Hãy benchmark mô hình đã biên dịch, kích thước batch và chuỗi thực tế, tiền xử lý, chuyển dữ liệu và chế độ năng lượng.
NPU hiệu quả cho các khối lượng công việc nơ-ron được hỗ trợ như thị giác, giọng nói, giảm nhiễu, hiệu ứng nền và các mô hình ngôn ngữ nhỏ gọn. Các toán tử không được hỗ trợ có thể dự phòng sang CPU hoặc GPU, tạo ra chuyển đổi và độ trễ không đoán trước. Kiểm tra báo cáo của trình biên dịch và dấu vết thời gian chạy để xác nhận vị trí thay vì giả định toàn bộ đồ thị sử dụng bộ tăng tốc.
Chuyển đổi mô hình, lượng tử hoá và triển khai
Quá trình triển khai thường di chuyển từ khung đào tạo qua xuất khẩu, tối ưu đồ thị, lượng tử hoá, biên dịch của nhà cung cấp và tích hợp thời gian chạy. Các hình dạng tĩnh và các toán tử phổ biến là dễ nhất để tăng tốc. Luồng điều khiển động, kernel tùy chỉnh, tensor trung gian lớn, và các mẫu chuẩn hoá hoặc attention không được hỗ trợ có thể yêu cầu thay đổi đồ thị hoặc thực thi hỗn hợp.
Định dạng số nguyên và độ chính xác thấp hơn giảm kích thước mô hình, băng thông, năng lượng và độ trễ, nhưng dữ liệu hiệu chuẩn phải đại diện cho đầu vào thực tế. So sánh lượng tử hoá sau đào tạo với đào tạo có nhận thức lượng tử khi chất lượng nhạy cảm. Đánh giá hành vi theo lớp và trường hợp xấu nhất vì độ chính xác trung bình có thể che giấu sự suy giảm trong các trường hợp hiếm hoặc quan trọng về an toàn.
Việc suy luận trên thiết bị cải thiện độ trễ, hoạt động ngoại tuyến và quyền riêng tư bằng cách hạn chế chuyển dữ liệu, nhưng thiết bị vẫn cần các mô hình an toàn, truy cập dữ liệu có quyền và cơ chế cập nhật. Bảo vệ tệp mô hình khi cần, ký các bản cập nhật, công khai dự phòng đám mây, và đảm bảo telemetry không tái tạo lại rủi ro về quyền riêng tư mà kiến trúc cục bộ muốn giảm.
Đánh giá hiệu năng và các đánh đổi ở cấp hệ thống
Đo thời gian khởi động lạnh và độ trễ trạng thái ổn định, thông lượng, năng lượng mỗi lần suy luận, bộ nhớ, hành vi nhiệt, độ chính xác và ảnh hưởng đến pin. Các bài kiểm tra dài tiết lộ việc giảm tốc mà các benchmark ngắn không phát hiện. Bao gồm tiền xử lý và hậu xử lý vì việc thay đổi kích thước, token hoá, giải mã hoặc sao chép dữ liệu có thể chiếm ưu thế so với bộ tăng tốc nhanh.
Lập lịch là vấn đề hệ thống. CPU quản lý logic ứng dụng, GPU có thể render hoặc thực thi các lớp không được hỗ trợ, và NPU chạy các đồ thị tương thích. Các khối lượng công việc đồng thời của camera, âm thanh, hiển thị và AI tranh giành băng thông bộ nhớ và năng lượng. Kiểm tra toàn bộ kịch bản người dùng thay vì một mô hình cô lập trong công cụ của nhà cung cấp.
Khả năng di chuyển vẫn còn hạn chế giữa các trình biên dịch và thời gian chạy. Ưu tiên các định dạng mô hình tiêu chuẩn khi chúng hoạt động, cô lập mã riêng của nhà cung cấp phía sau các giao diện, bảo tồn kết quả tham chiếu, và duy trì phạm vi kiểm thử thiết bị. Lựa chọn phần cứng dựa trên các khối lượng công việc đã được xác thực, hỗ trợ phần mềm, thời gian cập nhật, và tổng chi phí hệ thống — không chỉ dựa trên một thông số của bộ tăng tốc.
Ví dụ thực tế: triển khai mô hình thị giác trên laptop NPU
Một nhóm đào tạo mô hình phân đoạn cho hiệu ứng nền, xuất ra định dạng trao đổi được hỗ trợ, thay thế các toán tử không được hỗ trợ, và hiệu chỉnh lượng tử hoá số nguyên với các camera, ánh sáng, tông da, trang phục và nền đại diện. Trình biên dịch của nhà cung cấp báo cáo các nút chạy trên NPU và các nút dự phòng. Nhóm coi bất kỳ lần chuyển sang dự phòng nào là chi phí hệ thống, vì việc chuyển đổi tensor có thể chiếm ưu thế so với một kernel nhanh.
Việc benchmark đo tiền xử lý camera, thực thi mô hình, hợp thành, bộ nhớ, khởi động lạnh, độ trễ trạng thái ổn định, độ ổn định khung hình, năng lượng và giảm tốc nhiệt trong một cuộc gọi video thực tế. Kết quả được so sánh với các đường đi của CPU và GPU ở chất lượng đầu ra tương đương. Ứng dụng sử dụng phát hiện khả năng và dự phòng đã kiểm tra thay vì giả định bộ tăng tốc tồn tại hoặc hỗ trợ cùng một đồ thị sau khi cập nhật driver.
Kiểm thử phát hành bao gồm các mẫu thiết bị, phiên bản hệ điều hành và driver, các khối lượng công việc đồng thời, chế độ pin và đầu vào không hợp lệ. Các gói mô hình được ký và đánh phiên bản; telemetry ghi lại hiệu năng và lỗi mà không thu thập video không cần thiết. Sản phẩm giải thích khi quá trình xử lý vẫn trên thiết bị và khi các tính năng đám mây được sử dụng. NPU khẳng định vị trí của mình bằng cách cải thiện trải nghiệm toàn diện dưới các ràng buộc thực tế, không phải chỉ đạt được TOPS hoặc benchmark kernel riêng lẻ.
Danh sách kiểm tra triển khai thực tế
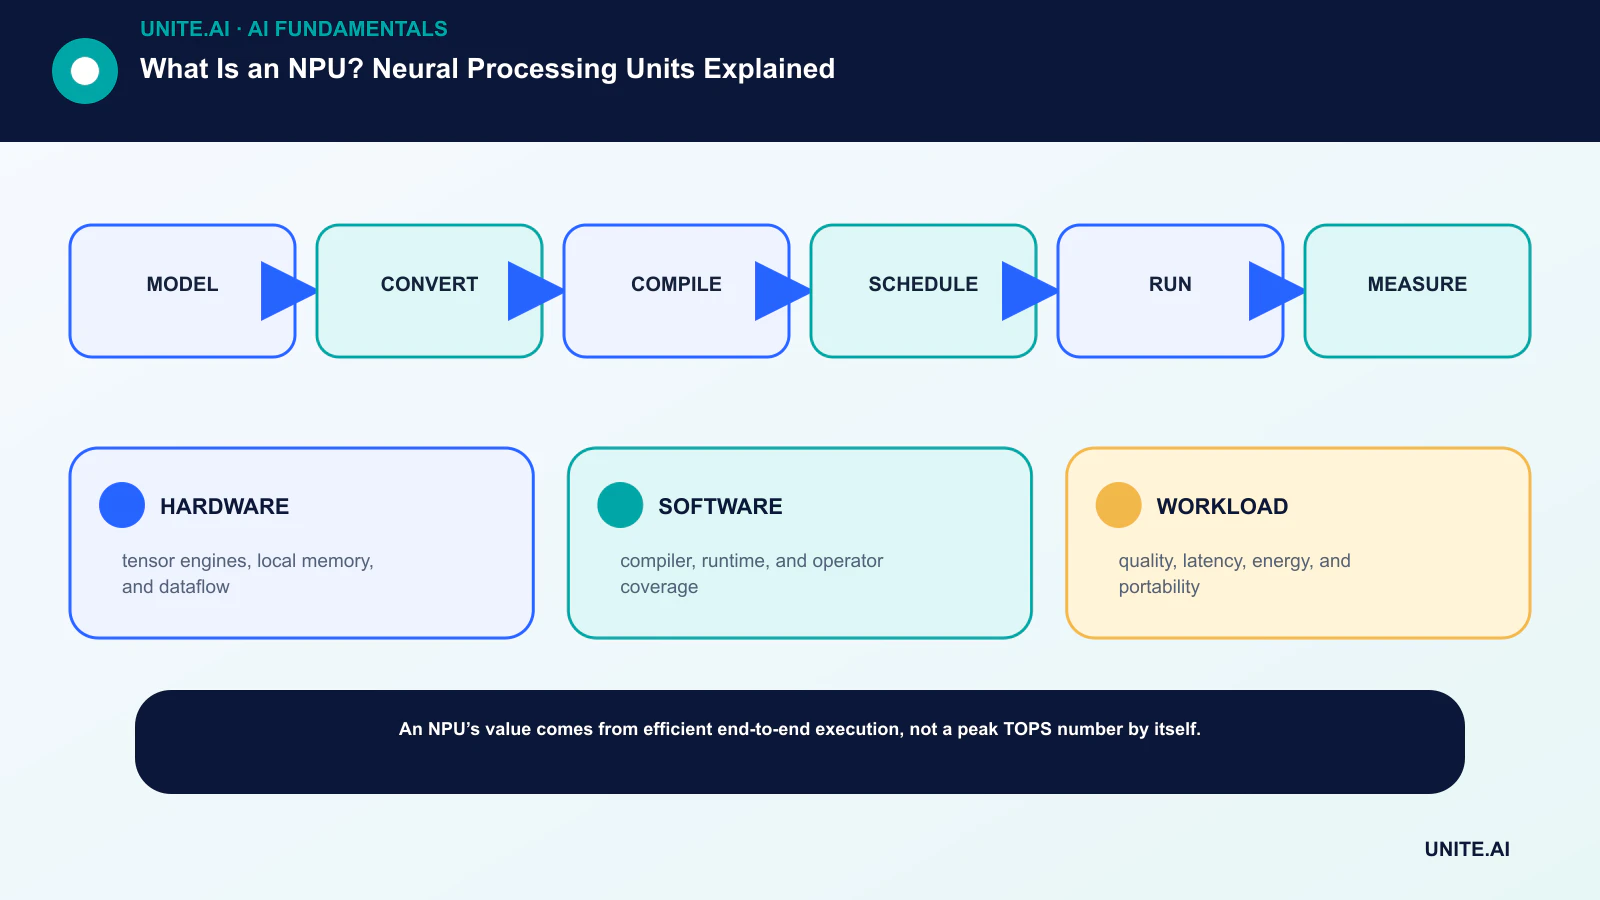
Biến ý tưởng thành quy trình làm việc có giới hạn, có thể kiểm thử: mô hình → chuyển đổi → biên dịch → lên lịch → chạy → đo lường. Chỉ định người chịu trách nhiệm, ghi chép dữ liệu và các phụ thuộc, thiết lập baseline đơn giản, đặt tiêu chí chấp nhận và dừng, kiểm thử các lỗi đại diện, và định nghĩa giám sát, rollback và đánh giá trước khi mở rộng phạm vi. Ghi lại các phiên bản và giả định để đội khác có thể tái tạo kết quả và hiểu những thay đổi.
Trước khi ra mắt, thực hiện đánh giá sẵn sàng được ghi chép với những người xây dựng, vận hành, bảo mật và chịu ảnh hưởng của hệ thống. Kiểm thử các trường hợp bình thường, điều kiện biên, lỗi phụ thuộc và lạm dụng; bảo quản bằng chứng và rủi ro chưa giải quyết. Xác định ai có thể phê duyệt phát hành, thay đổi ngưỡng, ghi đè đầu ra, hoặc dừng hoạt động. Xem lại quyết định khi dữ liệu thực tế đến, vì một dự án thí điểm thành công về mặt kỹ thuật không đảm bảo hiệu suất đáng tin cậy ở quy mô lớn hơn.
- PHẦN CỨNG: động cơ tensor, bộ nhớ cục bộ và luồng dữ liệu.
- PHẦN MỀM: trình biên dịch, thời gian chạy và phạm vi toán tử.
- CÔNG VIỆC: chất lượng, độ trễ, năng lượng và khả năng di chuyển.
Câu hỏi thường gặp
NPU có nhanh hơn GPU không?
Điều này phụ thuộc vào mô hình, độ chính xác, hỗ trợ toán tử, kích thước batch, giới hạn năng lượng và phần mềm. NPU có thể hiệu quả hơn cho một khối lượng công việc trên thiết bị được hỗ trợ, trong khi GPU nhanh hơn hoặc linh hoạt hơn ở các nơi khác.
NPU có giữ toàn bộ dữ liệu AI riêng tư không?
Không. Nó cho phép xử lý cục bộ, nhưng ứng dụng vẫn có thể gửi dữ liệu hoặc kết quả ra các dịch vụ đám mây. Quyền riêng tư phụ thuộc vào kiến trúc và chính sách toàn bộ.
Tài liệu tham khảo chính












