
Nền tảng AI
Giải Thích Cơ Chế Là Gì? Cách Các Nhà Nghiên Cứu Phân Tích Mô Hình AI

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Giải thích cơ chế nghiên cứu cách các thành phần đã học bên trong mạng nơ-ron gây ra hành vi một cách nhân quả. Thay vì chỉ liên kết đầu vào với đầu ra, các nhà nghiên cứu đưa ra giả thuyết về các đặc trưng, đầu attention, neuron và mạch, sau đó can thiệp để kiểm tra các giả thuyết đó.
Lĩnh vực này đã tạo ra các giải thích chi tiết cho một số hành vi được chọn trong các mô hình nhỏ và trung bình, nhưng một bản mô tả đầy đủ và trung thực của mô hình tiên tiến vẫn chưa đạt được. Các giải thích tự động và hình ảnh hấp dẫn có thể là điểm khởi đầu hữu ích, chứ không phải bằng chứng.
Những điểm chính
- Các đặc trưng là các mẫu được biểu diễn; các mạch là các thành phần tương tác được đề xuất để thực hiện một phép tính.
- Việc vá hoạt động, loại bỏ và truy vết nhân quả kiểm tra xem một thành phần có thay đổi hành vi hay không.
- Siêu vị trí nghĩa là một neuron có thể tham gia vào nhiều đặc trưng; các bộ mã hoá thưa thớt cố gắng tạo ra một cơ sở đặc trưng khác.
- Các phương pháp giải thích cần có dữ liệu thực, các thử nghiệm có thể bác bỏ, độ phủ và đánh giá so với các giải thích thay thế.
Từ biểu diễn đến cơ chế
Việc thăm dò đặt câu hỏi liệu thông tin có thể được giải mã từ một hoạt động hay không. Gán nhãn ước tính những đầu vào hoặc thành phần nào quan trọng. Công việc cơ chế đi xa hơn bằng cách đề xuất một phép tính nội bộ và kiểm tra xem các can thiệp có thay đổi hành vi trung gian và cuối cùng như mong đợi hay không.
Điều này khiến nó có liên quan nhưng hẹp hơn so với AI giải thích được. Một giải thích sau khi xảy ra cho một quyết định không nhất thiết là một thuật toán được đảo ngược trong mô hình.
Mạch và các can thiệp nhân quả
Các nhà nghiên cứu có thể xác định một đầu attention hoặc đặc trưng liên quan đến một nhiệm vụ, loại bỏ nó, vá hoạt động từ một lần chạy khác, hoặc truy vết cách thông tin di chuyển qua các lớp. Một giả thuyết tốt dự đoán hành vi trên các ví dụ mới và chịu được các kiểm soát.
Các can thiệp có thể tạo ra các trạng thái ngoài phân phối, vì vậy một thay đổi hành vi không tự động tiết lộ phép tính tự nhiên. Hãy sử dụng nhiều phương pháp, các kiểm soát phù hợp và các hiệu ứng định lượng thay vì chỉ một lời nhắc minh họa.
Siêu vị trí và các đặc trưng thưa thớt
Mạng nơ-ron có thể biểu diễn nhiều đặc trưng hơn số chiều riêng lẻ bằng cách siêu vị trí chúng. Do đó, một neuron có thể kích hoạt cho nhiều mẫu không liên quan, khiến nhãn ở mức neuron trở nên gây hiểu lầm.
Các bộ mã hoá thưa thớt học một từ điển lớn hơn các đặc trưng từ các hoạt động của mô hình. Chúng có thể làm cho các mẫu tách biệt hơn, nhưng độ thưa được chọn, dữ liệu huấn luyện, lỗi tái tạo và các nhãn tự động ảnh hưởng đến những gì được khôi phục. Các đặc trưng Mạng nơ-ron vẫn cần xác thực nhân quả.
An toàn, gỡ lỗi và hạn chế
Các công cụ cơ chế có thể giúp tìm ra các sự kiện được ghi nhớ, thiên kiến, chiến lược lừa dối, hoặc các mạch thất bại và có thể hỗ trợ chỉnh sửa hoặc giám sát. Những công cụ này cũng có thể bỏ lỡ các phép tính phân tán, hiếm gặp hoặc phụ thuộc vào ngữ cảnh.
Xem các phát hiện như bằng chứng có phạm vi: phiên bản mô hình, nhiệm vụ, bộ dữ liệu, lớp, can thiệp, hiệu ứng và độ không chắc chắn. Kết nối việc giải thích với các đánh giá hành vi, red‑teaming và quản trị AI có trách nhiệm thay vì sử dụng nó như một chứng chỉ an toàn chung.
Biểu diễn, mạch và bằng chứng nhân quả
Giải thích cơ chế nghiên cứu cách các phép tính nội bộ tạo ra hành vi của mô hình. Các nhà nghiên cứu kiểm tra các hoạt động, trọng số, attention và các đặc trưng trung gian, sau đó đưa ra giả thuyết về các biểu diễn và mạch. Một biểu diễn không nhất thiết được lưu trữ trong một neuron; nó có thể được phân tán qua các hướng, lớp, token và các kết hợp phụ thuộc vào ngữ cảnh.
Các bộ mã hoá thưa thớt cố gắng phân tách các hoạt động dày đặc thành một tập hợp lớn hơn các đặc trưng kích hoạt một cách chọn lọc. Nhãn đặc trưng là các diễn giải của con người dựa trên các ví dụ quan sát được, không phải là dữ liệu thực. Lỗi tái tạo, độ thưa, việc tách đặc trưng, hấp thụ và các đặc trưng chết ảnh hưởng đến những gì quá trình phân tách tiết lộ và những gì nó bỏ lỡ.
Sự tương quan không đủ để đưa ra một tuyên bố cơ chế. Việc vá hoạt động, loại bỏ, truy vết nhân quả, điều hướng và các can thiệp trọng số có mục tiêu kiểm tra xem một thành phần có thay đổi hành vi như dự đoán hay không. Các can thiệp cũng có thể tạo ra các trạng thái ngoài phân phối, vì vậy kết quả cần có các kiểm soát, phân tích liều‑phản ứng, các giải thích thay thế và việc tái lập trên các lời nhắc và mô hình khác nhau.
Quy trình giải thích nghiêm ngặt
Bắt đầu với một hành vi được đo lường chính xác và một bộ dữ liệu tách biệt các giả thuyết cạnh tranh. Xác định vị trí các lớp, vị trí, thành phần hoặc đặc trưng liên quan; kiểm tra các cơ chế tiềm năng; can thiệp; và kiểm tra xem mạch được đề xuất có dự đoán được các trường hợp mới hay không. Giữ các ví dụ khám phá tách biệt khỏi đánh giá xác nhận để giảm thiên lệch lựa chọn.
Các công cụ tự động có thể xếp hạng neuron, đặc trưng, đầu hoặc đường đi, trong khi các mô hình ngôn ngữ có thể đề xuất mô tả. Tự động hoá tăng độ phủ nhưng có thể tạo ra các câu chuyện hợp lý. Đánh giá các giải thích dựa trên các ví dụ hoạt động chưa dùng và các dự đoán nhân quả, ghi lại độ không chắc, và làm cho các hiện vật có thể tái tạo được với phiên bản mô hình, tokenizer, lời nhắc và mã.
Các cơ chế có thể đa nghĩa, dư thừa, phi tuyến và phân tán. Việc loại bỏ một thành phần có thể được bù đắp bởi các thành phần khác, trong khi một đặc trưng có thể tham gia vào nhiều hành vi. Các phát hiện tiêu cực mang tính thông tin: một mạch dường như thất bại ngoài các ví dụ đã được biên tập nên được thu hẹp hoặc loại bỏ thay vì cứu vớt bằng một giải thích ngày càng mơ hồ.
Ứng dụng, hạn chế và tuyên bố an toàn
Giải thích có thể giúp gỡ lỗi ảo giác, thiên kiến, ghi nhớ, hành vi phá vỡ hoặc khả năng khái quát không mong đợi; so sánh các mô hình; và tạo ra các giả thuyết khoa học. Nó cũng có thể xác định các đặc trưng để giám sát hoặc can thiệp. Những ứng dụng này đòi hỏi xác thực theo nhiệm vụ vì một hình ảnh nghiên cứu hữu ích không tự động trở thành một kiểm soát sản xuất đáng tin cậy.
Việc không phát hiện được một đặc trưng không chứng minh rằng khả năng hoặc ý định không tồn tại, và một đặc trưng có thể đọc được không chứng minh mô hình sử dụng nó trong câu trả lời cụ thể. Các công cụ quan sát một phần của phép tính với độ phủ hạn chế. Các tuyên bố an toàn phải chỉ rõ độ nhạy của phát hiện, tỷ lệ dương tính giả, phân phối, kẻ tấn công và các điểm mù đã biết.
Sử dụng giải thích cùng với các đánh giá hành vi, red‑team, quản trị dữ liệu, kiểm soát truy cập, giám sát và phản hồi sự cố. Công bố các phương pháp và ví dụ phản chứng khi có thể. Lĩnh vực này đang tiến nhanh, nhưng các kỹ thuật hiện tại vẫn chưa cung cấp một giải thích đầy đủ, trung thực về cách suy luận của mô hình tiên tiến hay một đảm bảo chung về sự phù hợp.
Ví dụ thực tế: kiểm tra một mạch mô hình được đề xuất
Giả sử một mô hình dường như sử dụng một tập hợp các đầu attention và đặc trưng để giải quyết đối tượng gián tiếp trong một câu. Các nhà nghiên cứu định nghĩa một bộ dữ liệu kiểm soát với các tên, vị trí, yếu tố gây nhiễu và ví dụ phản chứng đa dạng, sau đó đo lường hành vi. Kiểm tra hoạt động xác định các thành phần tiềm năng, nhưng giả thuyết được viết trước khi can thiệp: thông tin mỗi thành phần mang, nơi nó di chuyển, và cách thay đổi nó sẽ làm thay đổi đầu ra như thế nào.
Việc vá hoạt động và loại bỏ kiểm tra tính cần và đủ trên các ví dụ chưa dùng. Một chỉnh sửa có mục tiêu thay đổi token dự đoán theo hướng mong đợi ủng hộ cơ chế; việc giảm hiệu suất rộng rãi thì không. Các kiểm soát vá các vị trí và thành phần không liên quan, thay đổi mức độ can thiệp, và so sánh các mạch thay thế. Nhóm công bố các trường hợp tiêu cực nơi giải thích thất bại và tránh gán mục đích có thể đọc được cho con người chỉ dựa trên tương quan.
Để khẳng định một ứng dụng an toàn, phương pháp phải phát hiện hành vi liên quan với độ nhạy đã biết dưới các lời nhắc thực tế và sự thích nghi của kẻ tấn công. Các bộ giám sát đặc trưng được đánh giá về tỷ lệ dương tính giả, khả năng tránh né, cập nhật mô hình và tính nhân quả. Bằng chứng giải thích có thể hướng dẫn gỡ lỗi và các thử nghiệm tiếp theo, nhưng việc thực thi vẫn nằm trong các kiểm soát bên ngoài và giám sát hành vi. Một sơ đồ mạch thuyết phục là một giả thuyết khoa học có bằng chứng — không phải là một giải thích đầy đủ về mô hình hay một đảm bảo về hành vi chưa thấy.
Danh sách kiểm tra triển khai thực tiễn
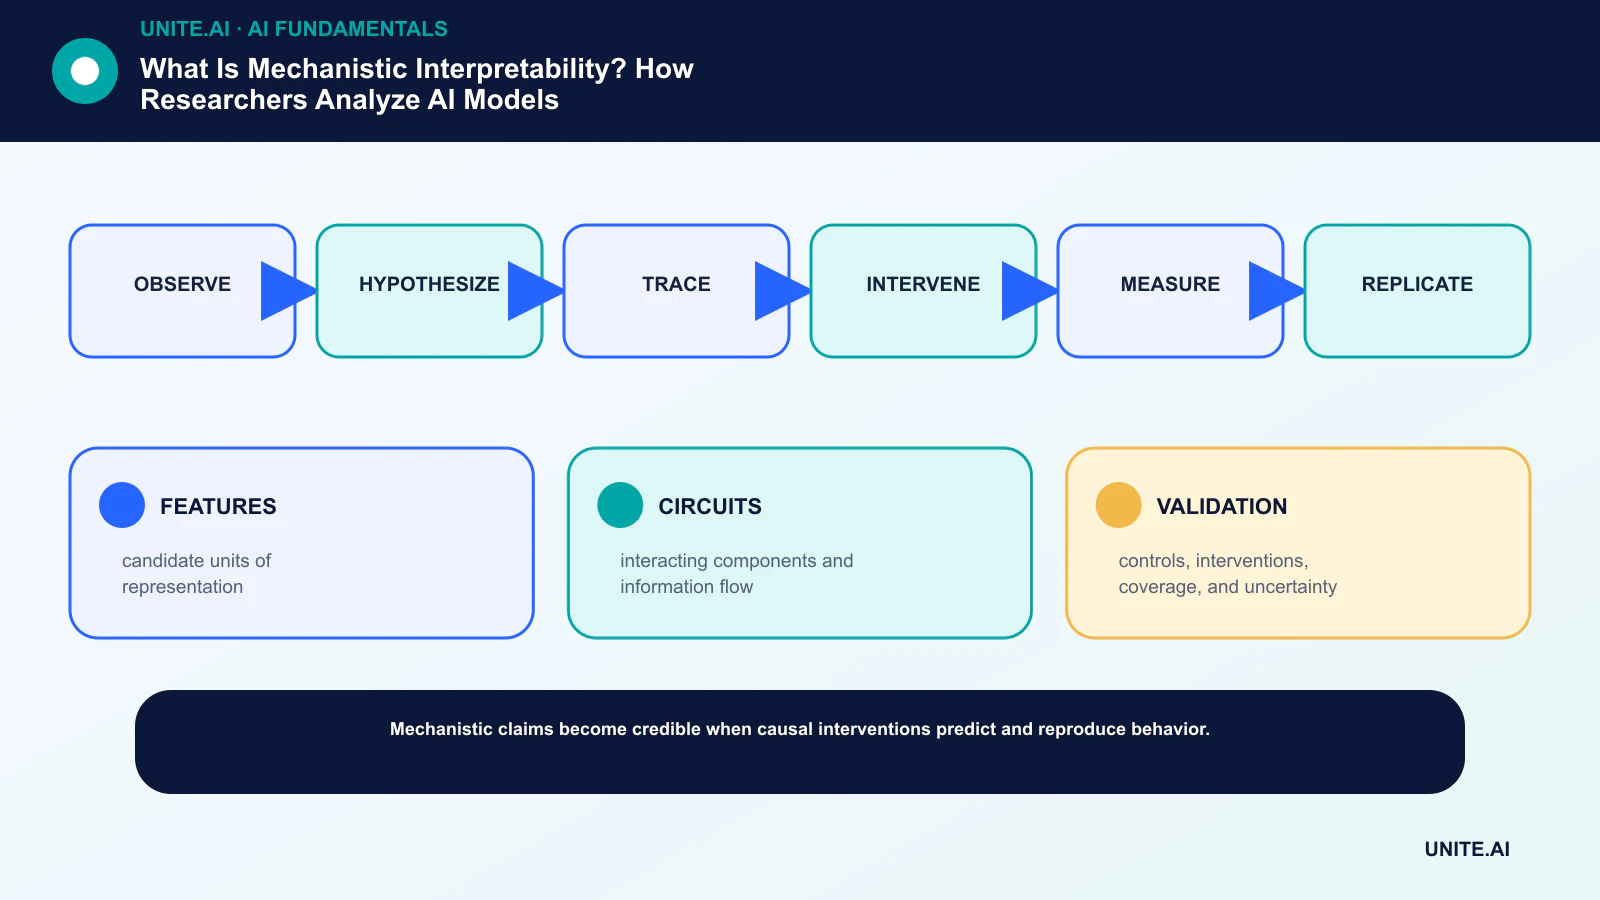
Biến ý tưởng thành một quy trình làm việc có giới hạn, có thể kiểm tra được: quan sát → đưa ra giả thuyết → truy vết → can thiệp → đo lường → tái lập. Đặt tên cho người chịu trách nhiệm, ghi chép dữ liệu và các phụ thuộc, thiết lập một chuẩn cơ bản đơn giản, đặt tiêu chuẩn chấp nhận và ngừng, kiểm tra các lỗi đại diện, và xác định giám sát, khôi phục và đánh giá trước khi mở rộng phạm vi. Ghi lại các phiên bản và giả định để đội khác có thể tái tạo kết quả và hiểu những gì đã thay đổi.
Trước khi ra mắt, thực hiện một cuộc đánh giá sẵn sàng được ghi chép với những người xây dựng, vận hành, bảo mật và chịu ảnh hưởng của hệ thống. Kiểm tra các trường hợp bình thường, điều kiện biên, lỗi phụ thuộc và lạm dụng; bảo quản bằng chứng và các rủi ro chưa giải quyết. Xác định ai có thể phê duyệt phát hành, thay đổi ngưỡng, ghi đè đầu ra hoặc dừng hoạt động. Xem lại quyết định sau khi dữ liệu thực tế đến, vì một dự án thí nghiệm thành công về mặt kỹ thuật không đảm bảo hiệu suất đáng tin cậy ở quy mô lớn hơn.
- FEATURES: các đơn vị biểu diễn tiềm năng.
- CIRCUITS: các thành phần tương tác và luồng thông tin.
- VALIDATION: kiểm soát, can thiệp, độ phủ và độ không chắc.
Câu hỏi thường gặp
Giải thích cơ chế có giống như đọc trọng số mô hình không?
Không. Trọng số thô không tự giải thích được. Các nhà nghiên cứu phân tích các hoạt động, đặc trưng, thành phần và các can thiệp để xây dựng và kiểm tra các giả thuyết nhân quả.
Các bộ mã hoá thưa thớt có thể giải thích đầy đủ một LLM không?
Không. Chúng cung cấp một cơ sở đặc trưng tiềm năng và có thể hỗ trợ phân tích mạch, nhưng độ phủ, độ trung thực, tái tạo, gán nhãn và khả năng mở rộng vẫn là những vấn đề chưa giải quyết.
Tài liệu tham khảo chính












