
Góc nhìn Anderson
GAN như một trình kết xuất khuôn mặt cho ‘CGI truyền thống’

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google

Điểm chínhTrong không gian tiềm ẩn của GAN, việc tách biệt danh tính khỏi biểu cảm vẫn là thách…
Xem thêm
- Trong không gian tiềm ẩn của GAN, việc tách biệt danh tính khỏi biểu cảm vẫn là thách thức trung tâm chưa được giải quyết đối với tổng hợp video khuôn mặt.
- Các mô hình CGI tham số như SMPL và 3DMM ngày càng được sử dụng để áp đặt trật tự lên các mã tiềm ẩn khó kiểm soát của GAN.
- Phương pháp kết hợp Rendering with Style của Disney đã tạo ra kết quả kỳ lạ bằng cách kết hợp các bản đồ kết cấu truyền thống với hình ảnh do GAN tạo ra.
Bài bình luận Khi các mạng đối kháng sinh (GAN) lần đầu thể hiện khả năng tái tạo những khuôn mặt 3D chân thực đến kinh ngạc, sự xuất hiện ấy đã khơi lên cuộc đổ xô khai thác tiềm năng chưa được sử dụng của GAN để tạo video khuôn mặt người nhất quán theo thời gian.
Dường như đâu đó trong không gian tiềm ẩn của GAN ắt phải có trật tự và tính hợp lý: một cấu trúc logic ngữ nghĩa mới hình thành, nằm trong các mã tiềm ẩn, cho phép GAN tạo nhiều góc nhìn và cách thể hiện nhất quán, chẳng hạn thay đổi biểu cảm, của cùng một khuôn mặt. Từ đó có thể tạo ra video deepfake thuyết phục theo thời gian, vượt xa các bộ tự mã hóa.
Đầu ra độ phân giải cao hẳn sẽ đơn giản so với môi trường độ phân giải thấp nghèo nàn mà hạn chế GPU buộc DeepFaceLab và FaceSwap phải sử dụng. “Vùng hoán đổi” khuôn mặt trong quy trình tự mã hóa sẽ trở thành “vùng tạo mới” của GAN, dựa trên vài ảnh đầu vào hoặc thậm chí một ảnh duy nhất.
Sẽ không còn sự lệch nhau giữa khuôn mặt hoán đổi và khuôn mặt chủ thể gốc, vì toàn bộ hình ảnh được tạo từ đầu, bao gồm tóc, đường hàm và các rìa ngoài của nét mặt — những thành phần thường gây khó khăn cho deepfake tự mã hóa truyền thống.
Mùa đông của video khuôn mặt GAN
Thực tế cho thấy mọi việc không dễ đến vậy. Cuối cùng, việc tách biệt các yếu tố trở thành vấn đề cốt lõi và vẫn là thách thức chính. Làm sao giữ một danh tính khuôn mặt riêng biệt rồi đổi tư thế hoặc biểu cảm mà không thu thập hàng nghìn ảnh tham chiếu để dạy mạng nơ-ron điều gì xảy ra khi thực hiện những thay đổi này, như cách các hệ thống tự mã hóa phải làm đầy công sức?
Hướng suy nghĩ sau đó trong nghiên cứu điều khiển chuyển động và tổng hợp khuôn mặt GAN là có thể áp dụng những phép biến đổi có mục tiêu, mang tính chung và dựa trên mẫu cho danh tính đầu vào mà không cần biến đổi riêng cho từng danh tính. Ví dụ, một khuôn mặt GAN có thể nhận biểu cảm chưa từng xuất hiện trong bất kỳ ảnh nào của người đó mà GAN biết.

Trong bài báo năm 2022 Tensor-based Emotion Editing in the StyleGAN Latent Space, các biểu cảm theo mẫu được áp dụng lên khuôn mặt đầu vào từ bộ dữ liệu FFHQ. Nguồn: https://arxiv.org/pdf/2205.06102.pdf
Rõ ràng, cách làm chung cho mọi người không thể bao quát sự đa dạng biểu cảm riêng của từng cá nhân. Ta phải tự hỏi liệu nụ cười đặc trưng như của Jack Nicholson hay Willem Dafoe có được thể hiện trung thực dưới tác động của các mã tiềm ẩn cho “biểu cảm trung bình” hay không.

Người lạ Latin quyến rũ này là ai? Dù GAN tạo khuôn mặt “chân thực” và có độ phân giải cao hơn, phép biến đổi không dựa trên nhiều ảnh thật của diễn viên như DeepFaceLab, vốn được huấn luyện sâu trên cơ sở hàng nghìn ảnh như vậy. Do đó, độ giống bị suy giảm. Ở hậu cảnh, một mô hình DeepFaceLab được nhập vào DeepFaceLive, phiên bản triển khai phát trực tiếp của phần mềm nổi tiếng nhưng gây tranh cãi này. Ví dụ lấy từ https://www.youtube.com/watch?v=9tr35y-yQRY (2022) và https://arxiv.org/pdf/2205.06102.pdf.
Nhiều bộ chỉnh sửa biểu cảm GAN đã được đề xuất trong vài năm qua; đa số làm việc với những danh tính không quen thuộc, nên người đọc thông thường không thể biết phép biến đổi trung thực đến đâu vì họ không biết những khuôn mặt ấy.

Các danh tính không quen thuộc được biến đổi bằng Cascade-EF-GAN năm 2020. Nguồn: https://arxiv.org/pdf/2003.05905.pdf
Có lẽ bộ chỉnh sửa khuôn mặt GAN nhận nhiều sự chú ý và trích dẫn nhất trong ba năm qua là InterFaceGAN, có thể di chuyển trong không gian tiềm ẩn qua những mã liên quan đến tư thế, tức góc máy hoặc góc mặt, biểu cảm, tuổi, chủng tộc, giới tính và các đặc điểm quan trọng khác.
Khả năng “morphing” theo phong cách thập niên 1980 của InterFaceGAN và các khung tương tự chủ yếu minh họa đường đi của phép biến đổi khi ảnh được chiếu trở lại qua một mã tiềm ẩn phù hợp, chẳng hạn tuổi. Về tạo cảnh quay liên tục theo thời gian, đến nay những cách làm ấy vẫn là các “thảm họa ấn tượng”.
Nếu tính thêm khó khăn khi tạo tóc nhất quán theo thời gian và việc khám phá hoặc điều chỉnh mã tiềm ẩn không có sẵn chỉ dẫn thời gian, có thể hợp lý khi kết luận GAN không phải Tất Cả Những Gì Bạn Cần™ để tổng hợp video khuôn mặt. Thậm chí khó xác định cách đưa chỉ dẫn ấy vào một khung thiết kế cho ảnh tĩnh, không có cơ chế xuất video tích hợp.
Các nỗ lực sau đó mang lại cải tiến từng bước trong tách biệt các yếu tố, còn những hướng khác bổ sung quy ước thị giác máy tính thành “lớp dẫn hướng”, như dùng phân đoạn ngữ nghĩa để điều khiển trong bài báo SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing cuối năm 2021.
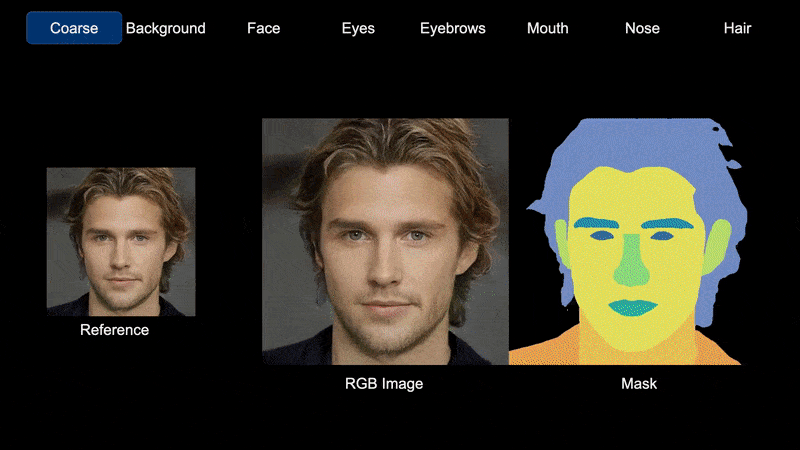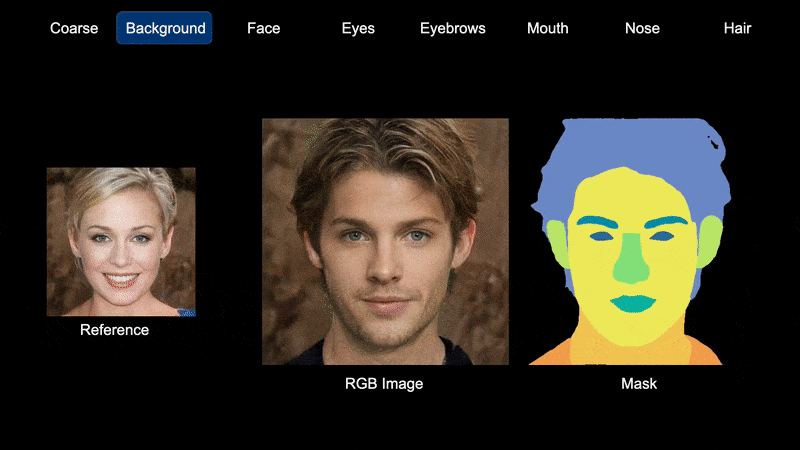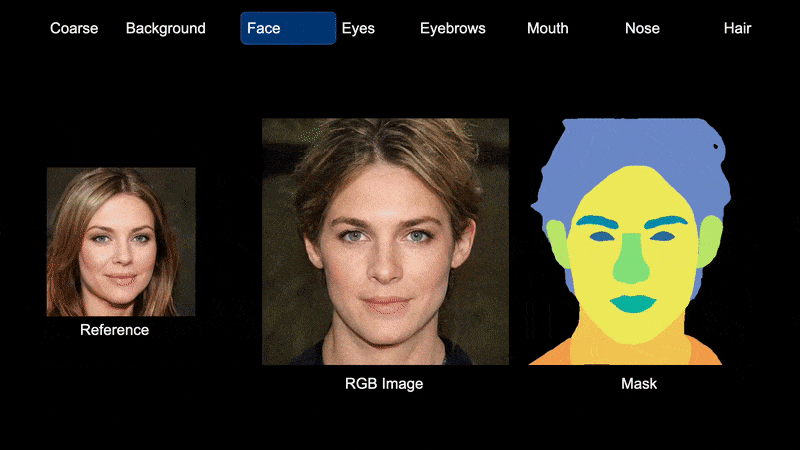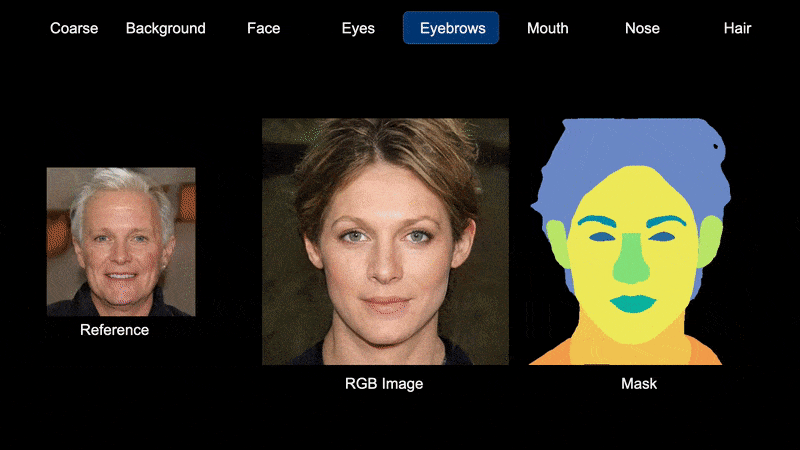
Phân đoạn ngữ nghĩa như một cách điều khiển không gian tiềm ẩn trong SemanticStyleGAN. Nguồn: https://semanticstylegan.github.io/
Dẫn hướng bằng tham số
Giới nghiên cứu tổng hợp khuôn mặt GAN ngày càng sử dụng khuôn mặt CGI tham số truyền thống để dẫn hướng và tạo trật tự cho những mã tiềm ẩn ấn tượng nhưng khó kiểm soát của GAN.
Dù các mô hình cơ sở khuôn mặt tham số đã là thành phần quen thuộc trong nghiên cứu thị giác máy tính suốt hơn hai mươi năm, gần đây sự quan tâm tăng lên cùng việc dùng nhiều hơn các mô hình CGI Skinned Multi-Person Linear Model (SMPL), hướng tiếp cận do Viện Max Planck và ILM tiên phong, rồi được cải tiến qua khung Sparse Trained Articulated Human Body Regressor (STAR).

SMPL, ở đây là biến thể SMPL-X, có thể áp một lưới CGI tham số phù hợp tư thế ước tính của toàn bộ cơ thể trong ảnh, gồm cả biểu cảm khi cần. Nhờ đó có thể thực hiện thao tác mới lên ảnh, dùng lưới làm chỉ dẫn thể tích hoặc tri giác. Nguồn: https://arxiv.org/pdf/1904.05866.pdf
Phát triển được ca ngợi nhất theo hướng này là sáng kiến năm 2019 của Disney Rendering with Style, kết hợp bản đồ kết cấu truyền thống với ảnh do GAN tạo nhằm cải thiện đầu ra hoạt hình kiểu deepfake.

Cũ gặp mới trong hướng tiếp cận lai của Disney với deepfake do GAN tạo. Nguồn: https://www.youtube.com/watch?v=TwpLqTmvqVk
Phương pháp Disney đưa các thành phần CGI được kết xuất truyền thống vào mạng StyleGAN2 để điền bổ sung khuôn mặt ở những vùng khó giữ tính nhất quán theo thời gian khi tạo video, chẳng hạn kết cấu da.

Quy trình Rendering with Style.
Vì đầu CGI tham số dẫn hướng quá trình có thể điều chỉnh theo người dùng, khuôn mặt GAN có thể phản ánh những thay đổi đó, gồm tư thế đầu và biểu cảm.
Dù nhằm kết hợp khả năng điều khiển của CGI với tính chân thực tự nhiên của khuôn mặt GAN, kết quả cuối cùng lại bộc lộ điểm yếu của cả hai. Phương pháp vẫn không giữ được kết cấu tóc và ngay cả vị trí các nét cơ bản một cách nhất quán:
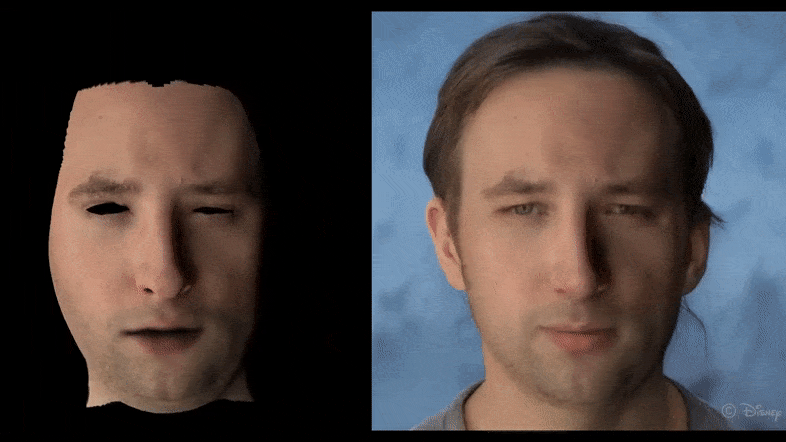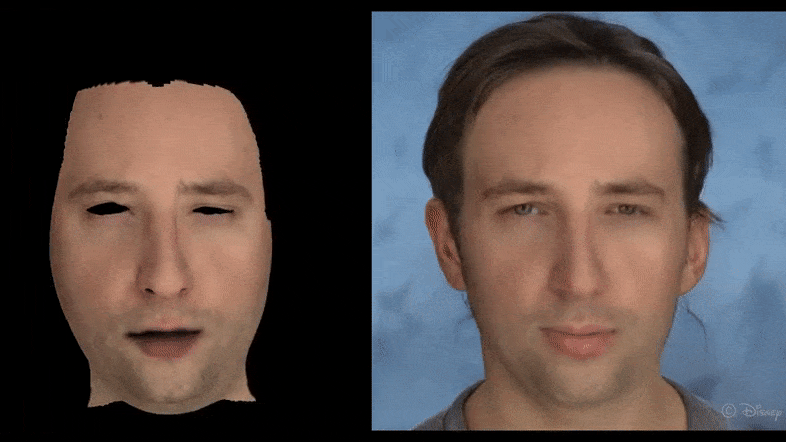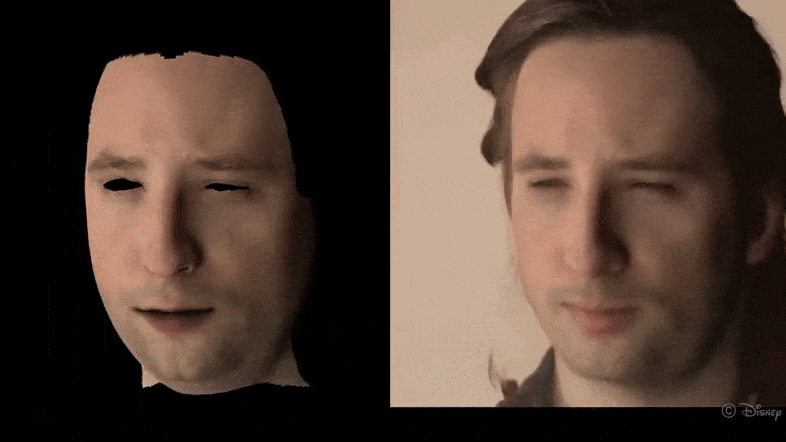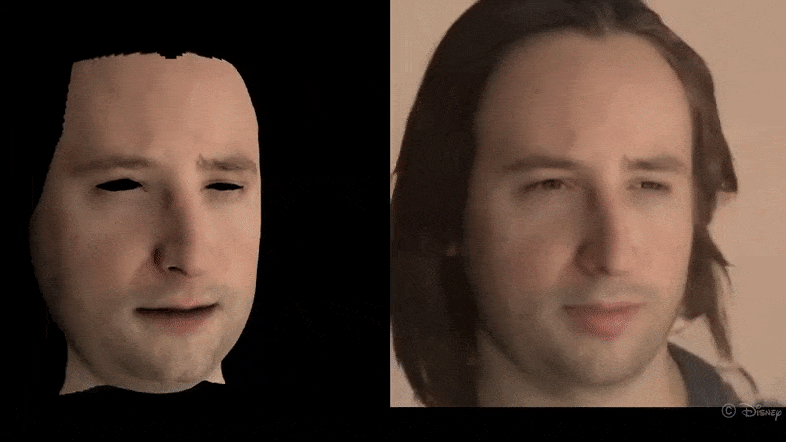
Rendering with Style tạo một kiểu “thung lũng kỳ dị” mới, dù nguyên lý vẫn có tiềm năng.
Bài báo StyleRig: Rigging StyleGAN for 3D Control over Portrait Images năm 2020 đi theo hướng ngày càng phổ biến, sử dụng mô hình khuôn mặt ba chiều có thể biến dạng (3DMM) làm đại diện để thay đổi đặc điểm trong StyleGAN, ở đây qua mạng điều khiển mới mang tên RigNet:

Các mô hình 3DMM làm đại diện diễn giải không gian tiềm ẩn trong StyleRig. Nguồn: https://arxiv.org/pdf/2004.00121.pdf
Tuy nhiên, như thường thấy ở những sáng kiến này, kết quả vẫn có vẻ giới hạn ở thay đổi tư thế rất nhỏ và thay đổi biểu cảm hoặc cảm xúc không dựa trên hiểu biết riêng về người đó.

StyleRig cải thiện mức điều khiển nhưng tóc nhất quán theo thời gian vẫn là vấn đề chưa giải quyết. Nguồn: https://www.youtube.com/watch?v=eaW_P85wQ9k
Có thể thấy kết quả tương tự trong MOST-GAN của Mitsubishi Research, một bài báo năm 2021 dùng 3DMM phi tuyến làm kiến trúc tách biệt các yếu tố, nhưng cũng gặp khó khăn để đạt chuyển động linh hoạt và nhất quán.
Nghiên cứu mới nhất tìm cách kết hợp khả năng điều khiển và tách biệt các yếu tố là One-Shot Face Reenactment on Megapixels, một lần nữa dùng đầu tham số 3DMM làm giao diện thân thiện cho StyleGAN.

Trong quy trình MegaFR của One-Shot Face Reenactment, mạng tổng hợp khuôn mặt bằng cách kết hợp một ảnh thật được ánh xạ ngược vào biểu diễn tiềm ẩn với tham số lấy từ mô hình 3DMM đã kết xuất. Nguồn: https://arxiv.org/pdf/2205.13368.pdf
OSFR thuộc nhóm công cụ chỉnh sửa khuôn mặt GAN đang phát triển, hướng đến quy trình chỉnh sửa tuyến tính kiểu Photoshop/After Effects: người dùng nhập ảnh mong muốn rồi áp dụng biến đổi, thay vì tìm mã liên quan đến danh tính trong không gian tiềm ẩn.
Một lần nữa, biểu cảm tham số là cách thêm biểu cảm mang tính chung và không cá nhân hóa. Nó dẫn đến các biến đổi có vẻ kỳ dị theo cách riêng, không phải lúc nào cũng tích cực.

Biểu cảm được thêm vào OSFR.
Như nghiên cứu trước, OSFR suy ra tư thế gần bản gốc từ một ảnh và có thể “chính diện hóa”, chuyển ảnh khuôn mặt lệch góc thành chân dung nhìn thẳng:

Ảnh gốc phía trên và các chân dung chính diện suy ra từ một cách triển khai OSFR trong bài báo mới.
Trên thực tế, kiểu suy luận này giống một số nguyên lý trắc quang ảnh làm nền tảng cho Neural Radiance Fields (NeRF). Tuy nhiên, ở đây hình học phải xác định từ một ảnh thay vì 3–4 góc nhìn giúp NeRF suy ra các tư thế xen kẽ bị thiếu và tạo cảnh 3D thần kinh có người mà ta có thể khám phá.
(Tuy nhiên, NeRF cũng không phải Tất Cả Những Gì Bạn Cần™, vì tập hợp trở ngại khi tổng hợp video khuôn mặt gần như khác hoàn toàn so với GAN.)
GAN có chỗ đứng trong tổng hợp video khuôn mặt không?
Việc tạo biểu cảm động và tư thế ngoài phân bố huấn luyện từ một ảnh nguồn hiện giống nỗi ám ảnh giả kim trong nghiên cứu khuôn mặt GAN. Lý do chính là GAN hiện là phương pháp duy nhất có thể tạo khuôn mặt thần kinh ở độ phân giải khá cao và độ trung thực tương đối lớn. Dù các khung deepfake tự mã hóa huấn luyện được trên nhiều tư thế và biểu cảm thật, chúng phải hoạt động ở độ phân giải đầu vào và đầu ra giới hạn bởi VRAM, đồng thời cần ảnh “chủ”. NeRF chịu hạn chế tương tự và, khác hai hướng còn lại, hiện chưa có phương pháp được thiết lập để thay đổi biểu cảm; nhìn chung nó cũng khó chỉnh sửa.
Con đường duy nhất cho hệ thống tổng hợp khuôn mặt CGI/GAN chính xác dường như là tìm cách tập hợp danh tính từ nhiều ảnh trong không gian tiềm ẩn. Khi đó, mã danh tính không cần đi khắp không gian để dùng tham số tư thế không liên quan, mà có thể dùng chính các ảnh thật liên quan làm tham chiếu biến đổi.
Ngay cả trong trường hợp ấy, hoặc nếu toàn bộ mạng StyleGAN được huấn luyện trên bộ mặt của một danh tính như bộ huấn luyện của tự mã hóa, logic ngữ nghĩa còn thiếu có lẽ vẫn phải do công nghệ bổ trợ cung cấp, chẳng hạn phân đoạn ngữ nghĩa hay khuôn mặt 3DMM tham số. Ít nhất trong tình huống đó, chúng sẽ có thêm dữ liệu để làm việc.


