
Интервью
Рази Разиуддин, сооснователь и генеральный директор FeatureByte – Интервью

 Добавьте Unite.AI в избранные источники в Google
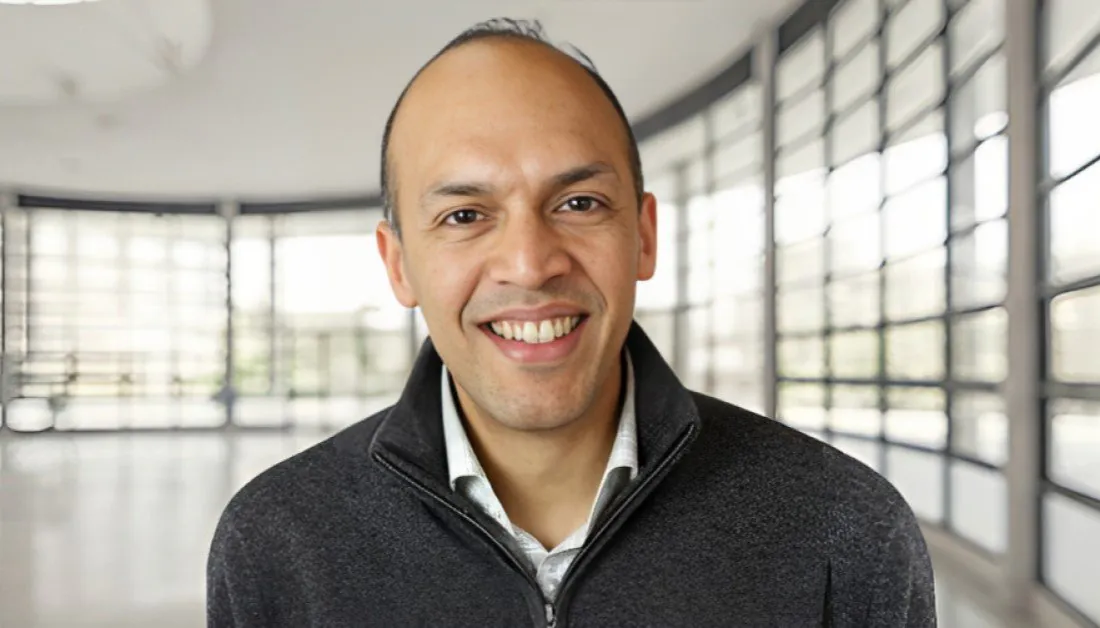
Рази Разиуддин является сооснователем и генеральным директором FeatureByte, его цель – устранить последнее значительное препятствие для масштабирования ИИ в корпоративной среде. Опыт Рази в области аналитики и роста охватывает команды руководства двух стартапов-единорогов. Рази помог масштабировать DataRobot с 10 до 850 сотрудников за менее чем шесть лет. Он разработал стратегию выхода на рынок, основанную на услугах, которая стала визитной карточкой быстрого роста DataRobot.
FeatureByte поставила своей миссией масштабировать корпоративный ИИ, радикально упрощая и индустриализируя данные ИИ. Платформа инженерии и управления признаками (FEM) позволяет специалистам по данным создавать и делиться передовыми признаками и готовыми к производству конвейерами данных за несколько минут – вместо недель или месяцев.
Что изначально привлекло вас к информатике и машинному обучению?
Как человек, который начал программировать в школе, я был очарован машиной, с которой можно “говорить” и контролировать через код. Я сразу же увлекся бесконечными возможностями новых приложений. Машинное обучение представляло собой парадигмальный сдвиг в программировании, позволяя машинам учиться и выполнять задачи без указания шагов в коде. Бесконечный потенциал приложений МО делает меня взволнованным каждый день.
Вы были первым сотрудником, нанятым на бизнес-роль в DataRobot, автоматизированной платформе машинного обучения, которая позволяет организациям стать управляемыми ИИ. Затем вы помогли масштабировать компанию с 10 до 1 000 сотрудников за менее чем 6 лет. Какие были некоторые ключевые выводы из этого опыта?
Переход от нуля до одного трудный, но невероятно интересный и полезный. Каждый этап эволюции компании представляет собой разные проблемы, но видеть, как компания растет и преуспевает, – это удивительное чувство.
Мой опыт с AutoML открыл мне глаза на неограниченный потенциал ИИ. Увлекательно видеть, как эта технология может быть использована в различных отраслях и приложениях. В конце концов, создание новой категории – редкое достижение, но невероятно полезное. Мои ключевые выводы из этого опыта:
- Создайте удивительный продукт и не гонитесь за кратковременными тенденциями
- Не бойтесь быть неконформистом
- Сосредоточьтесь на решении проблем клиентов и предоставлении ценности
- Всегда будьте открыты для инноваций и попыток новых вещей
- Создайте и прививайте правильную культуру компании с самого начала
Можете ли вы поделиться историей создания FeatureByte?
Это хорошо известный факт в мире ИИ/МО – что качественный ИИ начинается с качественных данных. Но подготовка, развертывание и управление данными ИИ (или признаками) сложны и отнимают много времени. Мой сооснователь, Ксавье Конорт, и я столкнулись с этой проблемой лично в DataRobot. Хотя моделирование стало намного проще благодаря инструментам AutoML, инженерия и управление признаками остаются огромной проблемой. Основываясь на нашем совокупном опыте и экспертизе, Ксавье и я почувствовали, что мы можем действительно помочь организациям решить эту проблему и выполнить обещание ИИ повсюду.
Инженерия признаков является ядром FeatureByte, можете ли вы объяснить, что это такое для наших читателей?
В конечном итоге, качество данных определяет качество и производительность моделей ИИ. Данные, которые вводятся в модели для обучения и прогнозирования будущих результатов, называются признаками. Признаки представляют информацию об объектах и событиях, таких как демографические или психографические данные потребителей, или расстояние между держателем карты и продавцом для транзакции по кредитной карте или количество предметов различных категорий из покупки в магазине.
Процесс преобразования сырых данных в признаки – для обучения моделей МО и прогнозирования будущих результатов – называется инженерией признаков.
Почему инженерия признаков является одним из самых сложных аспектов проектов машинного обучения?
Инженерия признаков очень важна, потому что этот процесс напрямую отвечает за производительность моделей МО. Хорошая инженерия признаков требует трех довольно независимых навыков, которые объединяются – знания предметной области, науки о данных и инженерия данных. Знания предметной области помогают специалистам по данным определить, какие сигналы извлечь из данных для конкретной проблемы или случая. Вам нужны навыки науки о данных, чтобы извлечь эти сигналы. И, наконец, инженерия данных помогает вам развернуть конвейеры и выполнить все эти операции в масштабе на больших объемах данных.
В большинстве организаций эти навыки живут в разных командах. Эти команды используют разные инструменты и не общаются хорошо друг с другом. Это приводит к большому трению в процессе и замедляет его до полной остановки.
Можете ли вы поделиться некоторыми идеями о том, почему инженерия признаков является слабейшим звеном в масштабировании ИИ?
Согласно Эндрю Нгу, известному эксперту в области ИИ, “Прикладное машинное обучение по сути является инженерией признаков.” Несмотря на свою важнейшую роль для цикла жизни машинного обучения, инженерия признаков остается сложной, отнимающей много времени и зависящей от экспертных знаний. Существует серьезный недостаток инструментов, которые могут сделать этот процесс проще, быстрее и более индустриализированным. Усилия и экспертиза, необходимые для этого, сдерживают предприятия от возможности развертывания ИИ в масштабе.
Можете ли вы поделиться некоторыми проблемами, связанными с созданием решения, ориентированного на данные, которое радикально упрощает инженерию признаков для специалистов по данным?
Создание продукта, который имеет 10-кратное преимущество над статус-кво, очень сложно. К счастью, у Ксавье есть глубокая экспертиза в области науки о данных, которую он использует для переосмысления всего процесса работы с признаками на основе фундаментальных принципов. У нас есть команда мирового уровня, состоящая из специалистов по данным полного цикла и инженеров, способных воплотить наше видение в реальность. И у нас есть пользователи и партнеры по разработке, которые консультируют нас по упрощению UX для решения их проблем.
Как платформа FeatureByte ускорит подготовку данных для приложений машинного обучения?
Подготовка данных для МО – это итеративный процесс, который полагается на быстрое экспериментирование. Открытый исходный код FeatureByte SDK – это декларативная структура для создания передовых признаков всего лишь несколькими строками кода и развертывания конвейеров данных за несколько минут вместо недель или месяцев. Это позволяет специалистам по данным сосредоточиться на творческом решении проблем и быстром экспериментировании с живыми данными, а не беспокоиться о технической инфраструктуре.
Результатом является не только более быстрая подготовка и подача данных в производстве, но и улучшение производительности моделей благодаря мощным функциям.
Можете ли вы обсудить, как платформа FeatureByte дополнительно предложит возможность оптимизировать различные текущие задачи управления?
Платформа FeatureByte предназначена для управления жизненным циклом признаков МО. Декларативная структура позволяет FeatureByte развертывать конвейеры данных автоматически, извлекая метаданные, которые имеют отношение к управлению общей средой. Пользователи могут контролировать работоспособность конвейеров и затраты, а также управлять происхождением, версией и правильностью признаков, все из одного GUI. Корпоративный ролевой контроль доступа и рабочие процессы утверждения обеспечивают конфиденциальность и безопасность данных, избегая при этом разрастания признаков.
Есть ли что-то еще, что вы хотели бы поделиться о FeatureByte?
Большинство корпоративных инструментов ИИ фокусируются на улучшении моделей машинного обучения. Мы поставили своей миссией помочь предприятиям масштабировать свой ИИ, упрощая и индустриализируя данные ИИ. В FeatureByte мы решаем самую большую проблему для практиков ИИ: предоставление последовательного, масштабируемого способа подготовки, подачи и управления данными на протяжении всего жизненного цикла модели, радикально упрощая весь процесс.
Если вы являетесь специалистом по данным или инженером, интересующимся оставаться на переднем крае науки о данных, я бы посоветовал вам испытать силу FeatureByte бесплатно.
Спасибо за отличное интервью, читателям, которые хотят узнать больше, следует посетить FeatureByte.


