
Интервью
Гил Эльбаз, сооснователь и технический директор Datagen – Интервью

 Добавьте Unite.AI в избранные источники в Google
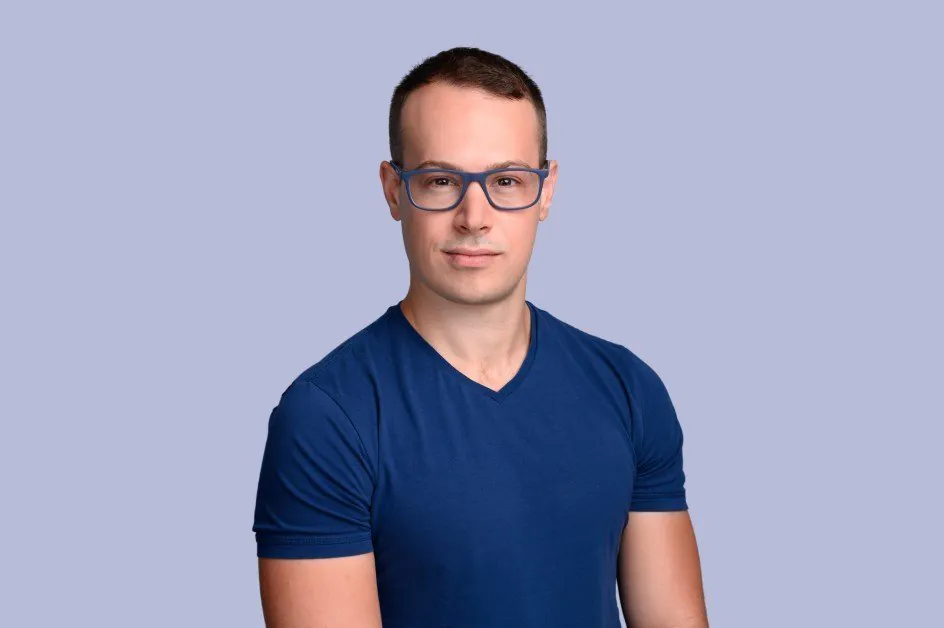
Гил Эльбаз является техническим директором и сооснователем Datagen, базирующейся в Тель-Авиве. Он получил степень бакалавра и магистра в Технионе. Исследовательская работа Гила была сосредоточена на 3D-компьютерном зрении и была опубликована на CVPR, ведущей конференции по компьютерному зрению в мире. Datagen является пионером в новой области Симулированной Данных, подмножестве синтетических данных, которая концентрируется на фотографически реалистичном воссоздании мира вокруг нас. Компания вышла из режима скрытности с более чем 18 миллионами долларов финансирования в марте 2021 года и сейчас работает с рядом компаний из списка Fortune 100 в области дополненной/виртуальной реальности, робототехники и автомобильной промышленности, включая большинство ведущих технологических гигантов США.
Что изначально привлекло вас к робототехнике и машинному обучению?
Научно-фантастические книги, такие как серия “Фондация” Айзека Азимова и “Я, робот”, всегда заставляли меня думать о будущем, в котором роботы будут неотъемлемой частью нашей повседневной жизни. Есть так много скучных, повторяющихся задач, которые люди выполняют; я знал, что не хочу их выполнять, и не мог представить, что кто-то другой захочет. Учитывая, что робототехника является технологической неизбежностью, я подумал, что движение в этом направлении будет умным, “защищенным от будущего” карьерным решением.
Итак, я первоначально подошел к этой области, сосредоточившись на физических аспектах предмета, и получил степень в области машиностроения в Технионе в Хайфе, Израиль. К концу моего обучения я начал глубоко погружаться в мир инструментов и возможностей CAD. Это инструменты, которые позволяют инженерам-машиностроителям проектировать структуры и механические устройства (все, от моста до автомобиля). Я увидел огромную возможность сделать значительный вклад без необходимости иметь дело с медленными итерациями физического мира. На практике эти программы имели очень мало, если вообще имели, возможностей машинного обучения/компьютерного зрения, интегрированных в них, которые помогали инженерам создавать более простые, дешевые и стабильные механические системы (это было в 2015 году). Я отправился в направлении компьютерного зрения на 3D-данные с помощью глубокого обучения (очень нового в то время) с целью создания более умных программ CAD. Работа в ранние дни современного глубокого обучения чувствовалась как часть чего-то, что могло быть действительно большим – подобно интернету.
На практике мои исследования были первыми, которые привели революцию глубокого обучения к нашей факультету в Технионе. Это позже превратилось в статью, принятую на ведущую конференцию по компьютерному зрению в мире, CVPR, и я летал на Гавайи на CVPR 2017. Презентация моей статьи и встреча с людьми открыли мне глаза на масштаб сообщества компьютерного зрения (которое сегодня не менее чем в 10 раз больше), тысячи участников, все страстно работающие над исследованиями в этой области. Это событие практически закрепило мое направление, показав мне силу компьютерного зрения и потенциал, который ждет своего освобождения.
Не могли бы вы рассказать историю создания Datagen?
Datagen была основана в 2018 году с миссией трансформировать то, как команды получают данные для обучения компьютерного зрения. Годом ранее мы увидели демонстрацию Oculus Rift, которая состояла из шлема виртуальной реальности и устройства дистанционного управления. После демонстрации мы задумались: “с учетом сложных камер, встроенных в шлем, почему был нужен дистанционный контроль для подключения виртуального пространства к физическому (т.е. отслеживать движение руки)?” Нейронные сети уже были достаточно совершенными, чтобы справиться с этим, поэтому что было проблемой?” Именно тогда у нас появилась идея – Данные! Мы сразу увидели огромную возможность решить проблемы 3D-пространственного присутствия с помощью передового компьютерного зрения и 3D-метаданных. Вместо того, чтобы сосредоточиться исключительно на VR/AR, мы выбрали более целостный подход, концентрируясь на казалось бы неразрешимой проблеме генерации достаточного (и точного) обучающих данных для реализации реальных 3D-приложений ИИ.
С фокусом на людях и взаимодействии человека с окружающей средой, Datagen является пионером в новой области Симулированной Данных, подмножестве синтетических данных, которая концентрируется на фотографически реалистичном воссоздании мира вокруг нас. Сегодня мы работаем с наиболее инновационными компаниями в мире, чтобы стимулировать и ускорить их разработку компьютерного зрения, и поддерживаемся некоторыми из наиболее уважаемых инвесторов в этой области.
Для читателей, которые не знакомы, могли бы вы объяснить, что конкретно является синтетическими данными?
Синтетические данные – это любые обучающие данные, которые вместо того, чтобы собираться через прямое измерение или наблюдение реального мира, генерируются либо алгоритмически, либо через симуляцию. В контексте компьютерного зрения синтетические данные – это компьютерно-генерированные изображения с необходимыми метаданными для обучения искусственного интеллекта. С учетом проблем с конфиденциальностью и очень реальными физическими и экономическими ограничениями реальных данных, трудно переоценить значение синтетических данных для машинного обучения и ИИ. В недавнем отчете Gartner предсказал, что к 2024 году большинство данных, используемых в области ИИ, будут искусственно генерироваться по этим причинам.
Какие есть преимущества синтетических данных по сравнению с ручным сбором данных?
Краткий ответ: подумайте о каждом аспекте ручного сбора данных, который является нежелательным, и удалите их из процесса – это и есть преимущества синтетических данных.
Генерация разнообразных наборов данных в большом масштабе для обучения компьютерного зрения – это дорогостоящий и трудоемкий процесс, и вариативность очень ограничена тем фактом, что размещение людей в конкретных местах и фотографирование их – это сложный процесс – гораздо более сложный и дорогой, чем делать это в симулированной среде. Другое значительное преимущество заключается в эффективном устранении необходимости ручной аннотации, которая является скучной, трудоемкой и склонной к человеческим ошибкам.
Datagen называет симулированные данные подмножеством синтетических данных. Не могли бы вы подробнее рассказать о том, что такое симулированные данные?
Симулированные данные – это синтетические данные, генерируемые через симуляцию. Мы используем GANs (а также некоторые другие передовые методы машинного обучения) для генерации 3D-объектов и размещения их в высокореалистичных 3D-симуляциях реального мира. Это выглядит как процесс “виртуальной фотографии” с первого лица, но работает в фотореалистичной, физически основанной системе. Эти симуляции производят визуальные данные (как если бы они были собраны в реальном мире), вместе с полным набором аннотаций (физика, освещение и т.д.). Итак, Симулированные Данные – это синтетические данные, которые являются фотореалистичными, контекстно-генерированными, 3D-изображениями, собранными в симулированной среде.
Как Datagen генерирует адаптированные симулированные данные?
Технология Datagen генерирует симулированные данные, которые являются как масштабируемыми, так и адаптированными к уникальным потребностям каждого клиента. Мы делаем это, учитывая каждый аспект каждого проекта – от системы компьютерного зрения, используемой в проекте, до демографического состава региона, в котором он будет работать. Будем ли мы работать напрямую с нашими клиентами или просто позволять их инженерам работать с нашей технологией, процесс Datagen начинается с установления ключевых параметров для каждого конкретного случая использования, таких как спецификации объектива, освещение, окружающая среда, демографическое распределение и т.д. Datagen использует GANs и другие передовые инструменты и методы для генерации огромного разнообразия активов, включая все, от человеческих голов с динамическими выражениями лица для обучения ИИ в эмоциональном анализе, до интерьеров транспортных средств для мониторинга пассажиров в салоне, и домашних сред для приложений видеоконференций, чтобы назвать лишь несколько. Для каждого типа актива Datagen вводит вариативность по бесчисленным дискретным осям (от тона кожи и высоты бровей до размера, цвета и формы мебели), используя параметры, которые тонко настроены для отражения конкретного применения.
Благодаря этим возможностям, наборы данных Datagen не только большие и высоко-варьируемые, но и оптимизированы для целей обучения уникальной системы для выполнения уникальной задачи (или набора задач) в уникальной среде, в которой она будет использоваться – все без компрометации способности масштабировать. Мы также учитываем конкретные требования к аннотациям/метаданным для каждого применения.
Какие есть примеры решений в робототехнике, где используются синтетические и/или симулированные данные?
Одним из величайших преимуществ использования симулированных данных в робототехнике является возможность генерации изображений аппаратуры, которая еще находится в стадии разработки. Таким образом, “мозг” робота (ИИ) и “тело” робота (аппаратура) могут быть разработаны параллельно. Теперь обучение может эволюционировать по мере эволюции спецификаций, а не ждать, пока окончательный продукт будет полностью прототипирован, прежде чем можно будет сделать фотографии и начать разработку ИИ.
Кроме того, поскольку симулированные данные генерируются в контексте, можно легко учитывать взаимодействие между роботом и его окружающей средой. Итак, если вы представите себе робота, который хватает и удаляет дефектные продукты с конвейера, симулированные данные позволят вам не только сгенерировать данные для каждого физического дефекта продукта, но и с точки зрения робота, чтобы захватить полный диапазон движения роботизированной руки, ее взаимодействие с объектом, который она хватает. Что еще более важно, 3D-метаданные означают, что нет необходимости тщательно аннотировать изображение за изображением, чтобы гарантировать, что робот может правильно идентифицировать продукт, дефекты, свою руку или все, что находится в его поле зрения.
Какие есть случаи использования симулированных данных в умных автомобилях?
Симулированные данные в разработке умных автомобилей делают бесконечно более простым разработку наборов данных для конкретных моделей автомобилей, пока они проектируются, итерируя в концерте с автомобилем самим по себе на различных стадиях проектирования и производства. С симулированными изображениями данные инженеры также могут более эффективно использовать визию в салоне, чтобы определить сонливых или отвлеченных водителей, если водитель снял руку с руля или любой другой из множества краевых случаев для учета безопасности водителя. Это также позволяет инженерам учитывать большее разнообразие водителей и пассажиров и вводить вариативность в форме угла изображения и освещения – все без нарушения конфиденциальности реальных людей.
Недавно Datagen объявила о большом количестве волнующих новых назначений, что это значит для будущего компании?
Недавние дополнения к нашему консультативному совету и руководству включают некоторых из наиболее блестящих и опытных профессионалов в области ИИ и компьютерного зрения. Их знания, проницательность и опыт помогут ориентировать и ускорить рост Datagen, пока мы навигируем в отрасли, которая все еще молода и полна возможностей. В области с так nhiều неизвестными, ничего не более ценного, чем знания.
Есть ли что-то еще, что вы хотели бы поделиться о Datagen?
Базируясь в Тель-Авиве, Datagen является частью гораздо большего экономического и культурного сдвига, который произошел в Израиле, и мы гордимся тем, что являемся частью этого. За короткий период времени Израиль (Тель-Авив в частности) вырос в крупный глобальный технологический хаб, с процветающей экосистемой стартапов и энергичным инвестиционным сообществом. Хотя Израиль часто считается технологическим хабом, ориентированным на кибербезопасность, ИИ и данные-центричные технологии выросли экспоненциально в последние годы. Сегодня в Израиле более 680 компаний по искусственному интеллекту, которые в совокупности привлекли 4,5 миллиарда долларов. Этот взрыв роста за последние несколько лет в основном обусловлен высокой концентрацией инженеров и всемирно известных университетов Израиля. Эти академические учреждения предоставляют доступ к талантам и передовой новой технологии в этой области. За последние два месяца Datagen наняла более 20 сотрудников и планирует привлечь дополнительных членов команды в отделы продаж и маркетинга, программного обеспечения и DevOps, а также продукта.
Спасибо за отличное интервью, читателям, которые хотят узнать больше, следует посетить Datagen.


