
Взгляд Anderson
Точность воспроизведения и реализм в дипфейк-видео

 Добавьте Unite.AI в избранные источники в Google

Ключевые моментыРеалистичность дипфейков основана на целостной деградации, а не на высокой точности…
Показать больше
- Реалистичность дипфейков основана на целостной деградации, а не на высокой точности воспроизведения, чтобы обмануть зрителей.
- DeepFaceLab и FaceSwap включают встроенные параметры для ухудшения качества сгенерированных лиц с целью контекстуальной правдоподобности.
- Новое обучение детекторов с использованием реалистичных конвейеров деградации повышает устойчивость алгоритмов обнаружения к реальным артефактам.
Не все практики глубоких подделок имеют одну и ту же цель: импульс исследований в области синтеза изображений – поддерживаемый влиятельными сторонниками, такими как Adobe (ADBE ), NVIDIA (NVDA ) и Facebook – заключается в том, чтобы развивать технологии так, чтобы методы машинного обучения могли в конечном итоге воссоздать или синтезировать человеческую деятельность с высоким разрешением и в самых сложных условиях (точность воспроизведения).
Напротив, цель тех, кто хочет использовать технологии глубоких подделок для распространения дезинформации, заключается в создании правдоподобных симуляций реальных людей различными методами, кроме простой достоверности глубоко подделанных лиц. В этом сценарии дополнительные факторы, такие как контекст и правдоподобие, почти равны потенциалу видео симулировать лица (реализм).
Этот иллюзионистский подход распространяется на ухудшение окончательного качества изображения видео с глубокой подделкой, так что все видео (а не только обманная часть, представленная глубоко подделанным лицом) имеет целостный визуальный облик, точный для ожидаемого качества для среды.
«Целостный» не означает «высококачественный» – достаточно того, что качество последовательно на протяжении всего оригинала и вставленного, фальсифицированного контента, и соответствует ожиданиям. В плане вывода потока VOIP на платформах, таких как Skype и Zoom, планка может быть удивительно низкой, с прерываниями и рывками видео и целым рядом потенциальных артефактов сжатия, а также “сглаживающими” алгоритмами, предназначенными для уменьшения их эффектов – которые сами по себе составляют дополнительный ряд “неаутентичных” эффектов, которые мы приняли как следствия ограничений и причуд живого вещания.
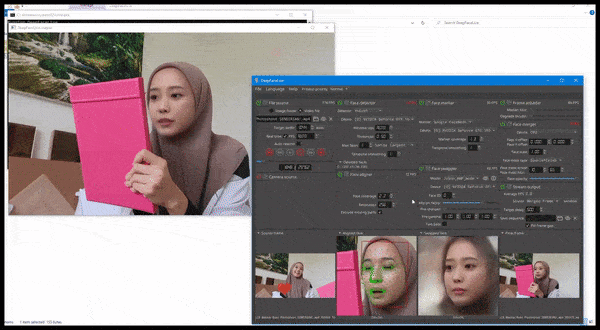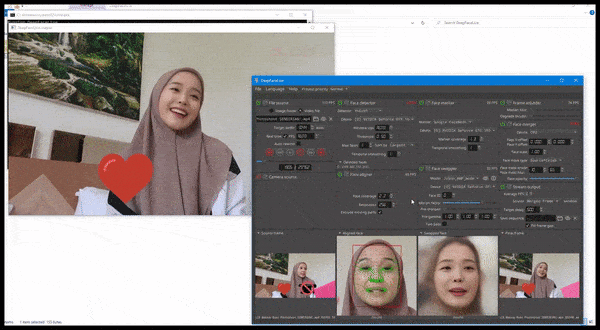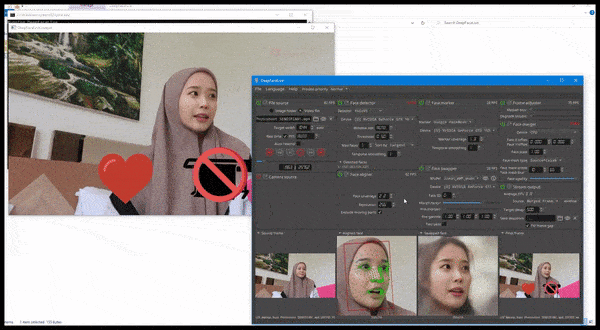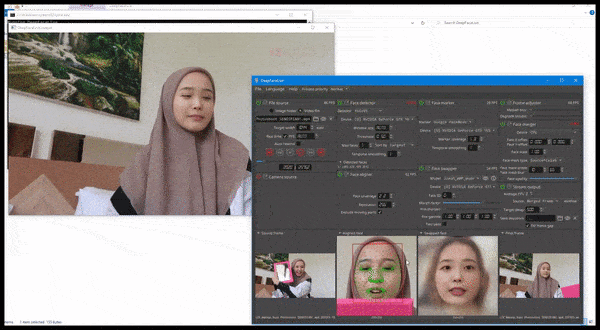
DeepFaceLive в действии: эта версия потокового вещания ведущего программного обеспечения для глубоких подделок DeepFaceLab может обеспечить контекстный реализм, представляя фальсификации в контексте ограниченного качества видео, полного с проблемами воспроизведения и другими рекуррентными артефактами соединения. Источник: https://www.youtube.com/watch?v=IL517EgYH8U
Встроенная Деградация
Действительно, два самых популярных пакета глубоких подделок (обе производные от спорного исходного кода 2017 года) содержат компоненты, предназначенные для интеграции глубоко подделанного лица в контексте “исторического” или видео более низкого качества путем ухудшения сгенерированного лица. В DeepFaceLab параметр bicubic_degrade_power выполняет эту функцию, а в FaceSwap настройка grain в конфигурации Ffmpeg также помогает интеграции ложного лица, сохраняя зерно во время кодирования*.

Настройка grain в FaceSwap помогает аутентичной интеграции в видеоконтент, не являющийся высококачественным, и наследственный контент, который может содержать эффекты зерна пленки, которые относительно редки в наши дни.
Часто вместо полного и интегрированного видео с глубокой подделкой создатели дипфейков будут выводить изолированную серию файлов PNG с альфа-каналами, каждый из которых показывает только синтетическое лицо, выведенное программой, так что поток изображений можно преобразовать в видео на платформах с более сложными возможностями эффектов ухудшения качества, таких как Adobe After Effects, до того, как фальшивые и реальные элементы будут объединены для окончательного видео.
Помимо этих намеренных ухудшений, содержание работы с глубокими подделками часто рекомпрессируется, либо алгоритмически (где платформы социальных сетей стремятся сэкономить пропускную способность, производя более легкие версии загрузок пользователей) на платформах, таких как YouTube и Facebook, либо путем переработки оригинальной работы в анимированные GIF, разделы деталей или другие разнообразно мотивированные рабочие процессы, которые рассматривают исходный релиз как отправную точку и впоследствии вводят дополнительное сжатие.
Реалистичные Контексты Обнаружения Глубоких Подделок
С учетом этого новая работа из Швейцарии предлагает пересмотр методологии, лежащей в основе подходов к обнаружению глубоких подделок, обучая системы обнаружения изучать характеристики контента глубоких подделок, когда он представлен в намеренно ухудшенных контекстах.

Стохастическое увеличение данных, применено к одному из наборов данных, используемых в новой работе, с гауссовским шумом, гамма-коррекцией и гауссовым размытием, а также артефактами сжатия JPEG. Источник: https://arxiv.org/pdf/2203.11807.pdf
В новой работе исследователи утверждают, что передовые пакеты обнаружения глубоких подделок полагаются на нереалистичные условия бенчмарка для контекста метрик, которые они применяют, и что “ухудшенный” вывод глубоких подделок может упасть ниже минимального порога качества для обнаружения, хотя их реалистично “грязный” контент, скорее всего, обманет зрителей из-за правильного внимания к контексту.
Исследователи ввели новую “реальную” процедуру деградации данных, которая успешно улучшает обобщаемость ведущих детекторов глубоких подделок, с лишь незначительной потерей точности на исходных показателях обнаружения, полученных “чистыми” данными. Они также предлагают новую оценочную основу, которая может оценить устойчивость детекторов глубоких подделок в реальных условиях, поддерживаемую обширными исследованиями абляции.
Документ называется Новый Подход к Улучшению Обучения-Основанного Обнаружения Глубоких Подделок в Реалистичных Условиях, и исходит от исследователей из Группы Мультимедийной Обработки Сигналов (MMSPG) и Федеральной Политехнической Школы Лозанны (EPFL), обе из которых базируются в Лозанне.
Полезная путаница
Предыдущие попытки включения ухудшенного вывода в подходы к обнаружению глубоких подделок включают нейронную сеть Mixup, предложение 2018 года от MIT и FAIR, и AugMix, сотрудничество 2020 года между DeepMind и Google, оба метода увеличения данных, которые пытаются “замутить” обучающий материал так, чтобы помочь обобщению.
Исследователи новой работы также отмечают предыдущие исследования, которые применяли гауссовский шум и артефакты сжатия к обучающим данным, чтобы установить границы отношения между выделенным признаком и шумом, в который он встроен.
Новое исследование предлагает конвейер, который имитирует компрометированные условия как процесса получения изображений, так и сжатия и различных других алгоритмов, которые могут дальнейшим образом ухудшить вывод изображения. Включая этот реальный рабочий процесс в оценочную основу, возможно произвести обучающие данные для детекторов глубоких подделок, которые более устойчивы к артефактам.

Концептуальная логика и рабочий процесс для нового подхода.
Процесс деградации был применен к двум популярным и успешным наборам данных, используемых для обнаружения глубоких подделок: FaceForensics++ и Celeb-DFv2. Кроме того, ведущие рамки детекторов глубоких подделок Capsule-Forensics и XceptionNet были обучены на версиях с ухудшенным качеством двух наборов данных.
Детекторы были обучены с оптимизатором Adam в течение 25 и 10 эпох соответственно. Для трансформации набора данных 100 кадров были случайным образом отобраны из каждого обучающего видео, с 32 кадрами, извлеченными для тестирования, до добавления ухудшающих процессов.
Ухудшения, рассмотренные для рабочего процесса, были шумом, где гауссовский шум с нулевым средним значением был применен на шесть различных уровней; изменением размера, чтобы симулировать уменьшенное разрешение типичных наружных кадров, которое может обычно повлиять на детекторы; сжатием, где различные уровни сжатия JPEG были применены к данным; сглаживанием, где три типичных сглаживающих фильтра, используемых в “деноизинге”, оцениваются для рамки; усилением, где контраст и яркость были скорректированы; и комбинациями, где любая смесь трех вышеуказанных методов была одновременно применена к одному изображению.
Тестирование и Результаты
При тестировании данных исследователи приняли три метрики: Точность (ACC); площадь под ROC-кривой (AUC); и F1-мера.
Исследователи протестировали стандартно обученные версии двух детекторов глубоких подделок на данных с ухудшенным качеством и обнаружили их недостаточность:
‘В целом, большинство реалистичных искажений и обработки чрезвычайно вредны для обычно обученных обучения-основанных детекторов глубоких подделок. Например, метод Capsule-Forensics показывает очень высокие баллы AUC на обоих несжатых FFpp и наборе тестов Celeb-DFv2 после обучения на соответствующих наборах данных, но затем страдает от резкого падения производительности на измененных данных из нашей оценочной основы. Аналогичные тенденции были наблюдаемы с детектором XceptionNet.’
Напротив, производительность двух детекторов была заметно улучшена путем обучения на преобразованных данных, причем каждый детектор теперь более способен обнаруживать ранее не встречавшиеся вводящие в заблуждение медиаматериалы.
‘Схема увеличения данных значительно улучшает устойчивость двух детекторов и при этом они сохраняют высокую производительность на исходных, не измененных данных.’

Сравнения производительности между сырыми и дополненными наборами данных, использованными в исследовании для двух детекторов глубоких подделок.
Документ заключает:
‘Текущие методы обнаружения предназначены для достижения максимально возможной производительности на конкретных бенчмарках. Это часто приводит к потере способности обобщать на более реалистичные сценарии. В этой работе предложена тщательно разработанная схема увеличения данных на основе естественного процесса ухудшения изображения.
‘Обширные эксперименты показывают, что простой, но эффективный метод значительно улучшает устойчивость модели против различных реалистичных искажений и операций обработки в типичных рабочих процессах изображений.’
* Сопоставление зерна в сгенерированном лице является функцией передачи стиля во время процесса преобразования.
Опубликовано впервые 29 марта 2022 года. Обновлено 20:33 EST, чтобы уточнить использование зерна в Ffmpeg.


