
Интервью
Фабиана Клементе, сооснователь и главный офицер данных в YData – Интервью

 Добавьте Unite.AI в избранные источники в Google
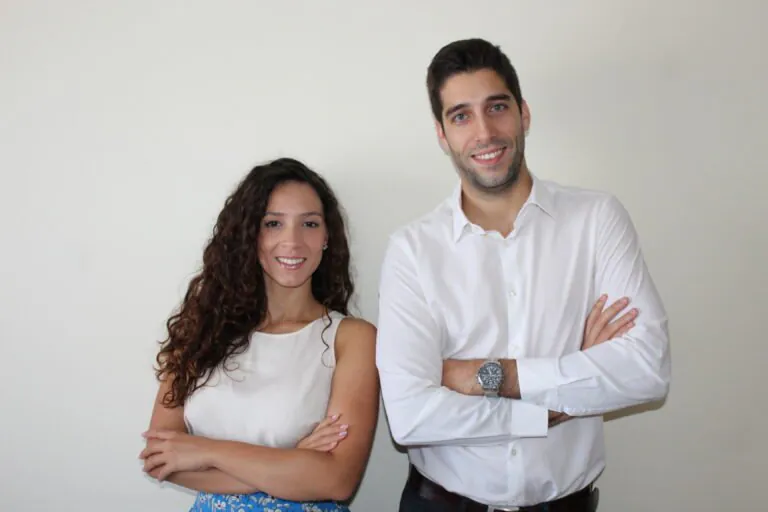
Фабиана Клементе – сооснователь и главный офицер данных в YData. YData – это стартап в области ИИ, создавший первый решение для разработки, ориентированное на данные, которое объединяет открытие, улучшение и масштабирование данных в одной платформе.
Что изначально привлекло вас к ИИ и машинному обучению?
Мой背景 в области прикладной математики, где я имела возможность учиться и понимать, как можно извлечь информацию из данных, а также делать это с помощью кода. В то время это было не так модно, как машинное обучение, но это точно разожгло мою страсть к этой области.
Можете ли вы рассказать историю создания YData?
Как ученый-дата, работавший как в стартапах, так и в крупных компаниях, я имела свою долю трудностей – иногда доступ к данным был заблокирован из-за проблем безопасности или конфиденциальности, а в других случаях доступ был простым, но качество данных было далеким от того, что было необходимо для создания решений на основе ИИ. Зная, что эти трудности очень распространены в большинстве организаций, вдохновило нас на создание компании с целью помочь этим командам преодолеть эти препятствия, ускорив разработку ИИ с улучшением данных.
Можете ли вы описать для нашей аудитории, что такое синтетические данные?
Синтетические данные считаются любыми данными, которые не были сгенерированы в реальном мире, то есть любыми данными, созданными искусственно. Существуют методы, которые позволяют генерировать синтетические данные – от стратегий, основанных на правилах, до использования моделей машинного или глубокого обучения для изучения этих “правил” для нас. В YData мы приняли и специализировались на стратегии, основанной на глубоком обучении, для генерации новых данных, которые сохраняют поведение реальных событий без проблем с конфиденциальностью.
Что делает синтетические данные так важными?
Чем больше организации понимают важность данных для развития своего бизнеса, тем больше будет понимание важности и роли синтетических данных. Сбор реальных данных не только трудоемок и дорог, но иногда также невозможен. Для создания приложений ИИ данные являются жестким требованием – вот где синтетические данные приходят на помощь. Способность генерировать незнакомые сценарии или просто разблокировать доступ к данным является ключом к эволюции в мире, где пионеры, такие как Эндрю Нг, заявляют, что стать ориентированным на данные является ключом к успешному внедрению ИИ.
В самоходных автомобилях или других автоматизированных hoạtностях мы уже можем оценить важность синтетических данных, поэтому я бы сказала, что это только естественно, что это понимание распространится на все отрасли.
Как YData генерирует синтетические данные?
YData использует в основном глубокие генеративные модели для изучения статистических атрибутов и корреляций между переменными исходных данных. Это позволяет модели генерировать статистически значимый набор данных, который имеет то же бизнес-значение, что и исходный, без возможности отслеживания исходных записей.
YData продвигает эту технологию вперед и является компанией, стоящей за Сообществом синтетических данных – группой экспертов в области науки о данных, посвященных распространению и помощи всем, кто хочет изучить и использовать эту технологию.
Как платформа YData помогает обнаруживать и разблокировать новые источники данных?
Платформа YData включает в себя встроенные соединители для любого типа базы данных, хранилища данных или озера данных, что позволяет пользователям легко получить доступ к соответствующей метаданным и понять,是否 существующие данные полезны для ответа на бизнес-вопрос, который они имеют в руках – без даже взгляда на реальные записи.
Можете ли вы поделиться некоторыми деталями о сообществе открытого исходного кода синтетических данных?
Синтетические данные находятся только в начале своего развития, и поэтому осведомленность о том, как они генерируются, их преимуществах или ограничениях еще не достаточно распространена среди более широкой аудитории. Поэтому в YData мы решили пройти более образовательный путь, создав сообщество синтетических данных – помимо того, что это место для обмена идеями или получения помощи от экспертов в области синтетических данных, это также место, где ученые-дата и другие технические специалисты могут начать свое путешествие в область синтетических данных, с некоторыми из наиболее интересных алгоритмов из литературы.
Кроме того, мы также предлагаем перспективу на качество данных, чтобы ученые-дата могли сначала понять данные, с которыми они работают, прежде чем синтезировать или улучшать синтез данных. Мы действительно привержены помощи командам данных в том, чтобы они стали более и более ориентированными на данные.
YData недавно анонсировала 2,7 миллиона долларов финансирования для ускорения международной экспансии. Можете ли вы поделиться некоторыми деталями о том, что это значит для будущего компании и ее стратегии экспансии?
YData родилась международной – мы знали, что такая технология требует ранних采用, которые обычно находятся в наиболее развитых странах. Поэтому наши первые клиенты уже были вне Португалии, по всей Европе, и теперь мы устанавливаем присутствие в Северной Америке. Это финансирование позволит нам укрепить наше присутствие на обоих континентах, не только коммерчески, но и для роста команды: мы – полностью распределенная команда, что позволяет нам нанимать лучшие таланты, где бы они ни находились.
Есть ли что-то еще, что вы хотели бы поделиться о YData?
YData продвигает барьер ориентированного на данные ИИ и создает новую категорию: DataPrepOps – хотя это и не самое красивое название, это боль, с которой сталкиваются многие компании сегодня, когда речь идет о разработке науки о данных. Тренд качества данных продолжает расти, и после конвейеров данных и наблюдаемости данных качество данных для команд науки о данных все еще находится в младенчестве, и YData выходит как лидер мысли в области подготовки данных.
Спасибо за отличное интервью, читателям, которые хотят узнать больше, следует посетить YData.


