Модели и платформы ИИ
Enfabrica представляет Ethernet-основанную ткань памяти, которая может переопределить вывод AI в масштабе

 Добавьте Unite.AI в избранные источники в Google
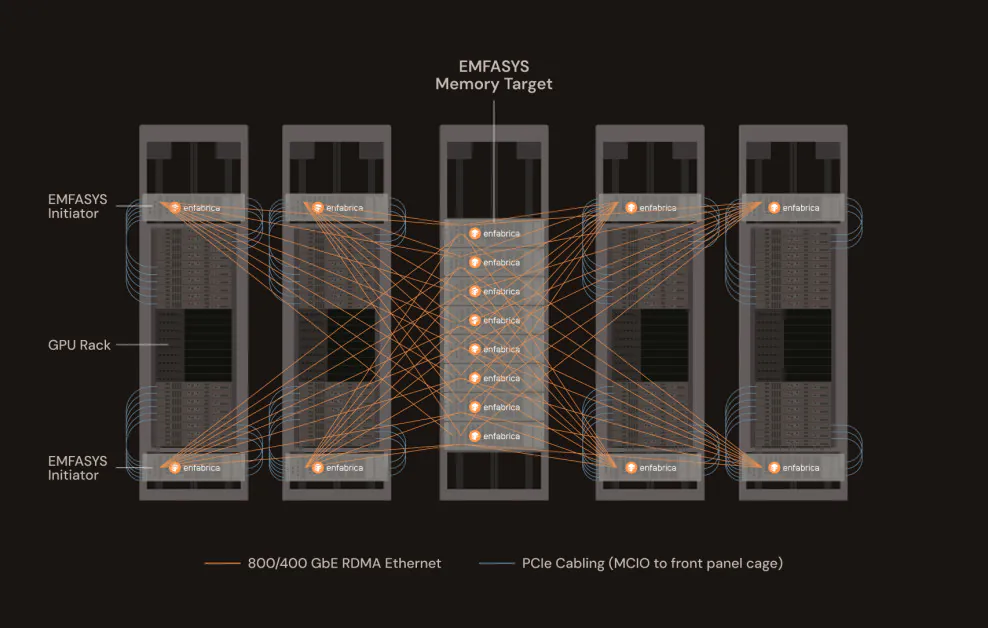
Enfabrica, стартап из Кремниевой долины, поддержанный Nvidia (NVDA ), представил прорывной продукт, который может существенно изменить способ развертывания и масштабирования крупномасштабных рабочих нагрузок AI. Новая система Elastic Memory Fabric System (EMFASYS) компании является первой коммерчески доступной Ethernet-основанной тьмой памяти, специально разработанной для решения основной проблемы вывода генеративного AI: доступа к памяти.
В то время, когда модели AI становятся более сложными, контекстно-осведомленными и постоянными, требуя огромных объемов памяти на каждую сессию пользователя, EMFASYS предлагает новый подход к разделению памяти и вычислений, позволяя центрам обработки данных AI значительно улучшить производительность, снизить затраты и повысить использование своих самых дорогих ресурсов: GPU.
Что такое ткань памяти и почему она важна?
Традиционно память внутри центров обработки данных была тесно связана с сервером или узлом, в котором она находится. Каждый GPU или CPU имеет доступ только к высокой пропускной памяти, напрямую подключенной к нему – обычно HBM для GPU или DRAM для CPU. Эта архитектура работает хорошо, когда рабочие нагрузки небольшие и предсказуемые. Но генеративный AI изменил игру. Большие языковые модели требуют доступа к большим контекстным окнам, истории пользователя и памяти нескольких агентов – все это должно быть обработано быстро и без задержки. Эти требования к памяти часто превышают доступную емкость локальной памяти, создавая узкие места, которые блокируют ядра GPU и увеличивают стоимость инфраструктуры.
Ткань памяти решает эту проблему, превращая память в общий, распределенный ресурс – своего рода сеть-прикрепленную память, доступную любому GPU или CPU в кластере. Представьте себе создание “облака памяти” внутри стойки центра обработки данных. Вместо репликации памяти на серверах или перегрузки дорогой HBM ткань позволяет памяти быть агрегированной, дезагрегированной и доступной по требованию через высокоскоростную сеть. Это позволяет рабочим нагрузкам вывода AI масштабироваться более эффективно, не ограничиваясь физическими ограничениями памяти отдельного узла.
Подход Enfabrica: Ethernet и CXL, вместе наконец
EMFASYS достигает этой архитектуры памяти на уровне стойки, сочетая две мощные технологии: RDMA над Ethernet и Compute Express Link (CXL). Первая обеспечивает сверхнизкую задержку и высокую пропускную способность передачи данных по стандартным Ethernet-сетям. Вторая позволяет памяти быть отсоединенной от CPU и GPU и объединенной в общий ресурс, доступный через высокоскоростные связи CXL.
В основе EMFASYS лежит чип ACF-S от Enfabrica, “СуперNIC” со скоростью 3,2 терабита в секунду, который объединяет сетевое и управление памятью в одном устройстве. Этот чип позволяет серверам взаимодействовать с огромными пулами коммодитизированной памяти DDR5 – до 18 терабайт на узел, распределенных по стойке. Критически важным является то, что он делает это, используя стандартные Ethernet-порты, позволяя операторам использовать существующую инфраструктуру центра обработки данных без инвестиций в проприетарные соединители.
Что делает EMFASYS особенно привлекательным, так это его способность динамически выгружать рабочие нагрузки, ограниченные памятью, с дорогой GPU-прикрепленной HBM на гораздо более доступную DRAM, сохраняя при этом микросекундную задержку доступа. Программный стек за EMFASYS включает в себя интеллектуальные механизмы кэширования и балансировки нагрузки, которые скрывают задержку и оркестрируют перемещение памяти способами, прозрачными для больших языковых моделей, работающих на системе.
Последствия для отрасли AI
Это больше, чем просто умное решение аппаратного обеспечения – это представляет собой философский сдвиг в том, как строится и масштабируется инфраструктура AI. Когда генеративный AI переходит от новинки к необходимости, с миллиардами запросов пользователей, обрабатываемых ежедневно, стоимость обслуживания этих моделей стала невыносимой для многих компаний. GPU часто используются не полностью не из-за недостатка вычислительной мощности, а потому что они простаивают, ожидая памяти. EMFASYS решает эту дисбаланс напрямую.
Позволяя использовать общую, ткань-прикрепленную память, доступную через Ethernet, Enfabrica предлагает операторам центров обработки данных масштабируемую альтернативу постоянному покупанию дополнительных GPU или HBM. Вместо этого они могут увеличивать емкость памяти модульно, используя коммодитизированную DRAM и интеллектуальное сетевое оборудование, снижая общую площадь и улучшая экономику вывода AI.
Последствия выходят за рамки немедленных экономических выгод. Этот тип дезагрегированной архитектуры открывает путь для моделей “память как услуга”, где контекст, история и состояние агента могут сохраняться за пределами одной сессии или сервера, открывая двери для более интеллектуальных и персонализированных систем AI. Она также создает предпосылки для более устойчивых облаков AI, где рабочие нагрузки могут быть распределены эластично по стойке или всему центру обработки данных без жестких ограничений памяти.
Взгляд в будущее
Enfabrica’s EMFASYS в настоящее время проходит тестирование с выбранными клиентами, и хотя компания не раскрыла, кто эти партнеры, Reuters сообщает, что крупные провайдеры облачных услуг AI уже тестируют систему. Это позиционирует Enfabrica не только как поставщика компонентов, но и как ключевого участника в следующем поколении инфраструктуры AI.
Разделив память и вычисления и сделав ее доступной по высокоскоростным коммодитизированным Ethernet-сетям, Enfabrica закладывает основу для новой эры архитектуры AI – той, где вывод может масштабироваться без компромиссов, где ресурсы больше не простаивают, и где экономика развертывания крупномасштабных языковых моделей наконец начинает иметь смысл.
В мире, все больше определяемом контекстно-богатыми, многоагентными системами AI, память больше не является вспомогательным актером – это сцена. И Enfabrica делает ставку на то, что тот, кто построит лучшую сцену, определит производительность AI в течение многих лет.