
Интервью
Елизабет Наммур, генеральный директор и основатель Teleskope – Интервью

 Добавьте Unite.AI в избранные источники в Google
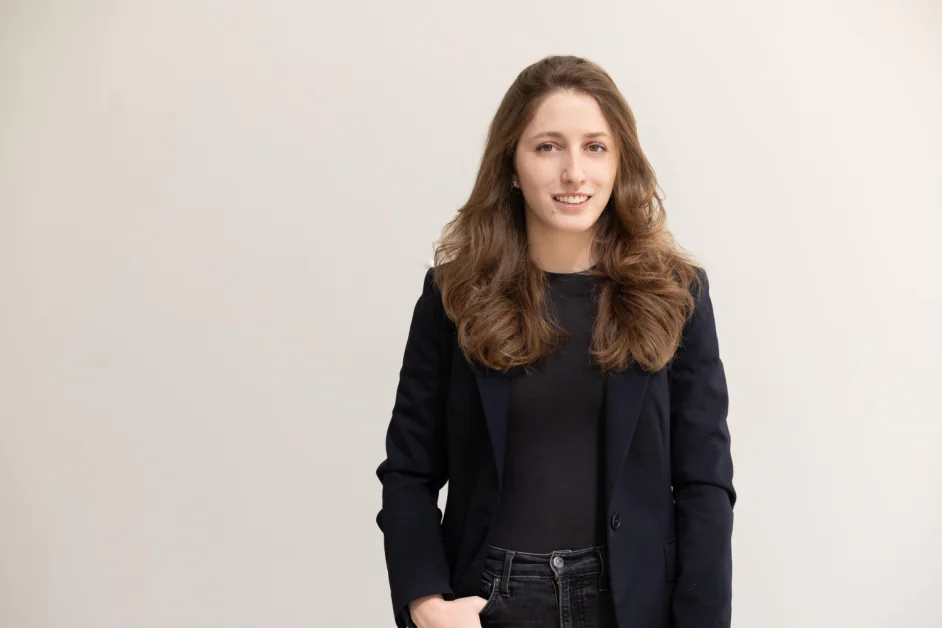
Elizabeth Nammour — генеральный директор и основатель Teleskope, а также инженер по безопасности, ставшая предпринимателем. Её карьера охватывает безопасность данных, разработку программного обеспечения и инновации в крупнейших технологических организациях мира. Работая старшим инженером-программистом по безопасности данных в Airbnb (ABNB ), она столкнулась с практической проблемой: как понимать и контролировать огромные, быстро растущие массивы данных, распределённые по десяткам систем. Этот опыт, наряду с предыдущими техническими и стратегическими ролями в Amazon (AMZN ) и Booz Allen Hamilton (BAH ), сформировал её представление о трудностях управления конфиденциальными данными в больших масштабах и в итоге привёл к созданию компании, решающей эту проблему.
Teleskope — это современная платформа защиты данных, которая помогает организациям постоянно понимать, где находятся их данные, как они используются и какие риски возникают по мере усложнения среды. Платформа, созданная с учётом потребностей разработчиков и специалистов по безопасности, обеспечивает точную видимость данных, автоматическое устранение проблем и управление на основе политик в облачных, SaaS- и гибридных средах. Выходя за рамки статических аудитов и ручных процессов, Teleskope создаёт практическую основу для управления разрастанием данных и ответственного внедрения ИИ.
Вы основали Teleskope после того, как создали в Airbnb собственный инструментарий для обеспечения безопасности данных, позволяющий каталогизировать и классифицировать данные в массовом масштабе. Какой момент убедил вас в том, что это должна быть компания, а не внутренний проект, и как эти первые уроки сформировали ваше представление о продукте?
Когда я закончила разработку этого продукта в Airbnb, у меня появилась возможность написать для блога Airbnb статью «Автоматизация защиты данных в масштабе». Я не ожидала, что это к чему-то приведёт, но сообщество специалистов по безопасности отреагировало очень положительно, и ко мне начали обращаться практики со всего мира. Тогда я поняла, что многие сталкиваются с теми же проблемами, что и я, и что рынок действительно нуждается в таком продукте. В первые годы я во многом опиралась на отзывы коллег, и даже Teleskope версии 1.0 была намного лучше решения, которое я впервые создала в Airbnb. Сегодня наш продукт масштабнее и эффективнее, чем я могла тогда представить.
Ваш многомодельный классификационный конвейер сочетает в себе традиционный ML, модели, зависящие от формата, и валидацию GenAI. Можете ли вы рассказать нам о логике принятия решений и о том, как вы уменьшаете количество ложных срабатываний в масштабе?
Я определённо рекомендую прочитать нашу статью о классификации данных, которую я написала вместе с Иваном, руководителем нашего отдела Data Science. Прежде всего, это в равной степени искусство и наука. Здесь огромное количество нюансов: каждый обнаруженный объект конфиденциальных данных существует в уникальном контексте. Масштаб данных дополнительно усложняет задачу, поскольку сканирование петабайтов производственных данных требует значительных вычислительных ресурсов и времени. Не случайно эта проблема до сих пор считается во многом нерешённой.
Искусство заключается в том, чтобы найти баланс между всеми параметрами – скоростью, задержкой, точностью, стоимостью и широтой охвата (в хранилищах данных, форматах файлов, языках и т. д.). Мы всегда считали, что решение должно быть творческим и мультимодальным. Вот почему мы выбрали наш подход, объединив многие доступные методы классификации, чтобы получить динамичный и детализированный подход, который, как бы подводя итог, позволяет использовать максимально легкий метод без существенного ущерба для точности. Этот динамичный подход позволяет нам сканировать данные в 10-20 раз быстрее, чем инструменты, основанные на универсальных LLM, и при этом получать гораздо более точные результаты, чем регулярные выражения или традиционные контекстно-ориентированные подходы.
Недавно вы представили Prism, ориентированную на понимание данных на бизнес-уровне и исправление ошибок на базе GenAI. Какие новые возможности использования открывает эта технология по сравнению с обнаружением PII на уровне элементов и как вы защищаетесь от галлюцинаций при выполнении действий по исправлению ошибок?
Когда я впервые взялся за решение проблемы классификации и защиты данных, мое внимание было сосредоточено на снижении фактических ложноположительных результатов. Например, как нам убедиться, что, по крайней мере, в 95% случаев, когда мы помечаем что-либо как номер социального страхования, это действительно будет SSN. Несколько лет назад даже 80%-ная точность для различных типов элементов данных была бы большим достижением.
Но благодаря тесному сотрудничеству с нашими заказчиками в прошлом году стало ясно, что “шум”, от которого страдают команды, вызван не только неточной классификацией объектов данных (традиционными “ложными срабатываниями”). Шум часто возникает как из-за того, что вас заваливают нерелевантными предупреждениями, так и из-за получения ложных предупреждений. Что делает Prism, так это открывает нам возможность рассматривать гораздо больше контекста – не только “что это за фрагмент данных” или “кто имеет доступ к этому файлу”, но и “что, собственно говоря, представляет собой этот файл”. Объединив это с информацией, которую мы можем получить о том, чем на самом деле занимается данный бизнес и что его волнует, мы можем предложить продукт, соответствующий различным определениям “конфиденциальных” данных каждой компании.
Учёт такого уровня контекста действительно меняет правила игры. Например, хранение сотен номеров социального страхования в документе Google (GOOGL ) на личном диске может представлять серьёзную угрозу и нарушать политику управления данными. Но папка на защищённом диске отдела кадров, заполненная формами W-2 сотрудников, — это ожидаемая ситуация. Специалисты по безопасности хотят получить предупреждение о первом случае, однако оповещение о каждой правильно сохранённой форме W-2 создаёт лишь шум. Чтобы понимать, где и в каком контексте находятся конфиденциальные данные, одной модели классификации сущностей недостаточно.
Мы сотрудничаем с международной химической компанией Chevron (CVX ) Phillips Chemical. Эта компания вряд ли купила бы инструмент для защиты персональных данных или стандартный DSPM, поскольку риски, связанные с данными потребителей, не являются для неё приоритетом. Зато для неё крайне важна интеллектуальная собственность в виде запатентованных химических формул. Сводя содержание документа к набору сгруппированных меток, мы можем не только выявлять уникальные конфиденциальные элементы, но и находить информационные активы, оказавшиеся в «неправильных» местах. В сочетании с автоматическим устранением проблем этот контекст позволяет архивировать, удалять, редактировать или перемещать файлы в нужное место. Никто другой на рынке защиты данных не выполняет такую работу.
Teleskope обеспечивает непрерывное обнаружение данных в мультиоблачных, локальных и сторонних системах, включая теневые данные. Как выглядит покрытие “полной картой” и как быстро вы можете обнаружить неизвестные хранилища при развертывании с нуля?
“Полный” – это сложное слово, на самом деле это планка, которая постоянно меняется, даже ежедневно. Вот насколько сложно управлять разрастающимися данными. Нашей целью всегда было, чтобы Teleskope существовала везде, где есть данные наших клиентов. В конечном счете, мы являемся продуктом, основанным на интеграции во многих отношениях – мы создали десятки фирменных соединителей данных, которые позволяют сканировать и классифицировать данные с помощью широкого спектра SaaS–инструментов, облачных хранилищ данных и локальных систем. Большинство клиентов начинают с нескольких подключений, которые, по их мнению, представляют наибольший риск или где они наименее заметны, поэтому на самом деле мы редко бываем везде, где хранятся данные компании. Однако в рамках каждого источника данных мы постоянно просматриваем их среду, чтобы обнаружить новые учетные записи, таблицы, новые большие двоичные объекты, файлы, сообщения и т. д. Таким образом, где бы мы ни находились, мы находим данные, новые и старые, практически в режиме реального времени.
Как вы отслеживаете взаимосвязь между обучающими наборами данных, моделями, подсказками и выходными данными для обеспечения безопасности и управления ИИ?
На самом деле у нас есть три основных способа поддержки безопасности и управления ИИ. Во-первых, это наша способность применять нашу технологию классификации и исправления к движущимся данным с помощью наших API. Когда компании создают или подготавливают наборы данных для обучения своих собственных моделей, им нужен способ гарантировать, что данные не содержат личных данных или других конфиденциальных данных. Таким образом, мы подключаемся непосредственно к конвейеру обработки данных и можем очищать наборы данных по мере их перемещения или копирования в обучающий набор, гарантируя, что эти модели никогда не подвергнутся риску вывода конфиденциальных данных.
Во-вторых, мы рассматриваем наш основной продукт как средство внедрения искусственного интеллекта. Каждая компания вынуждена использовать инструменты искусственного интеллекта, чтобы работать более эффективно и идти в ногу с рынком. Отличным примером этого является Copilot от M365, который обеспечивает интеллектуальный поиск и упрощает поиск файлов или данных. Но эти инструменты по определению облегчают поиск конфиденциальных данных, и поэтому многие компании обращаются к нам со словами: “Нам нужно внедрить этот инструмент искусственного интеллекта, но мы боимся, что он всплывет”. Им нужен Teleskope, чтобы войти, просканировать свое окружение и автоматически внедрить свои политики управления данными и безопасности, чтобы они могли с уверенностью внедрять искусственный интеллект.
Наконец, мы создаём интеграции для ИИ-инструментов, которые редактируют или помещают в карантин запросы с конфиденциальными данными до того, как они попадут в общедоступные системы вроде ChatGPT. Многие компании просто запрещают такие инструменты, но их можно внедрять безопасно, гарантируя, что конфиденциальные данные — в том смысле, в котором их определяет каждая компания, — не покинут защищённую среду.
В основе вашего подхода лежат редактирование и “исправление ошибок у источника”. Какова ваша философия в отношении автоматического исправления ошибок в сравнении с другими подходами “человек в курсе” и где вы проводите границы безопасности?
Пару лет назад мы поняли, что, несмотря на всю необходимость поиска и классификации данных, они обеспечивают только половину успеха. Выявление рисков, связанных с данными, – это первый шаг, но устранение этих рисков – реальная конечная цель. Наши клиенты обычно начинают с оценки результатов работы Teleskope в нашем каталоге данных, затем переходят к устранению неполадок с привлечением специалистов, а затем переходят к полностью автоматизированному устранению неполадок. Мы прекрасно понимаем, что на самом деле всегда будут какие-то действия, которые команды никогда не смогут полностью автоматизировать на 100%. Например, удаление данных из производственной базы данных может быть очень проблематичным. Но во многих случаях мы видим, что клиенты внедряют полную автоматизацию для таких задач, как отзыв разрешений, перемещение данных, применение политик архивирования или хранения и т. д.
Многие инструменты DSPM/DLP не справляются с защитой в режиме реального времени. Что пришлось изменить в архитектуре, чтобы работа в реальном времени стала базовым требованием, и на какие задержки и пропускную способность могут рассчитывать предприятия в промышленной эксплуатации?
Чтобы решить задачу работы в реальном времени, важно было разделить её на основные компоненты. В разных ситуациях допустима разная задержка, но цель всегда одна: как можно быстрее предоставить максимально точную информацию. Поэтому нам нужна гибкая архитектура, позволяющая распараллеливать низколатентную систему под разные требования к пропускной способности. Когда Teleskope работает в инфраструктуре предприятия, данные классифицируются и защищаются непосредственно там, что сокращает задержку и объём исходящего трафика. Именно это позволяет устранять риски в критических сценариях менее чем за секунду.
Конфиденциальность и соответствие требованиям: вы требуете постоянного мониторинга и автоматического сопоставления с нормативными документами. Как вы поддерживаете актуальность сопоставлений по мере развития законодательства и насколько настраиваемыми являются элементы управления для разных регионов или бизнес-подразделений?
Откровенно говоря, мы действительно перестали ставить галочки и сосредоточились на глубоком понимании того, что волнует наших клиентов. В некоторых случаях они хотят на 100% соответствовать новейшим нормативным актам, и мы постоянно отслеживаем эти изменения и внедряем их в наш продукт. Но, по правде говоря, большинство компаний настолько далеки от того, чтобы полностью соблюдать эти законы, что мы должны выполнять их там, где они есть, и убедиться, что мы сможем доставить их из пункта А в пункт Б и В пункт С, прежде чем беспокоиться о том, как добраться до пункта Z. Для этого мы сначала понимаем, что означает соблюдение требований законодательства для данной компании (опять же, компания-производитель может не рассматривать что-то вроде GDPR как серьезную проблему), и гарантируем, что сможем разработать продукт с учетом их специфических профилей рисков и потребностей.
Внедрение GenAI: как заказчики используют Teleskope для создания “безопасных входных данных” и “безопасных выходных данных” без снижения скорости разработки? Какие шаблоны вы рекомендуете?
Клиенты интегрируют Teleskope Redact API в конвейеры обучения и инференса, чтобы конфиденциальные данные никогда не передавались генеративным моделям ИИ. Процесс редактирования скрыт от разработчиков, поэтому темп разработки сохраняется: данные редактируются перед инференсом, а после него восстанавливаются.
Забегая вперед, отметим, что вы говорили о комплексной “агентной” платформе защиты данных с автономным восстановлением. Какие этапы будут свидетельствовать о том, что отрасль готова к полностью автономной защите данных?
Мы точно знаем, что индустрия готова к этому. Другие области кибербезопасности, такие как SOC, уже продемонстрировали полный переход к агентному ИИ как средству расширения возможностей служб безопасности. У нас выстроилась очередь из клиентов, которые просят стать партнерами по разработке для этой работы, поэтому мы знаем, что многие компании испытывают ту же боль от необходимости вручную сортировать, исследовать, принимать решение и затем выполнять его, просто чтобы решить одну проблему. Мы абсолютно убеждены в том, что рынок движется именно в этом направлении, и полны решимости возглавить этот сдвиг.
Спасибо за содержательное интервью. Читатели, желающие узнать больше, могут посетить сайт Teleskope.









