
Взгляд Anderson
Уникальное решение DALL-E 2 для двойных значений

 Добавьте Unite.AI в избранные источники в Google
Ключевые моментыDALL-E 2 разделяет неоднозначные слова, такие как 'bat', на несколько объектов в одном…
Показать больше
- DALL-E 2 разделяет неоднозначные слова, такие как 'bat', на несколько объектов в одном изображении.
- Эта семантическая ошибка усугубляется по мере обучения моделей, управляемых CLIP, на более крупных наборах данных.
- Более 80% изображений DALL-E 2 с омонимами демонстрировали непреднамеренные двойные интерпретации.
Каждый, кто изучал итальянский язык, рано учится обращать внимание на контекст при описании метлы, потому что итальянское слово для этого обыденного домашнего предмета имеет крайне непристойное второе значение как глагол*. Хотя мы рано учимся различать семантическую карту и (уместную) применимость слов с несколькими значениями, это не навык, который легко передается гипермасштабным системам синтеза изображений, таким как DALL-E 2 и Stable Diffusion, поскольку они полагаются на модуль контрастного обучения языка и изображений OpenAI (CLIP), который относительно свободно обращается с объектами и их свойствами (однако он все больше занимает позиции в области синтеза изображений и видео с помощью латентной диффузии).
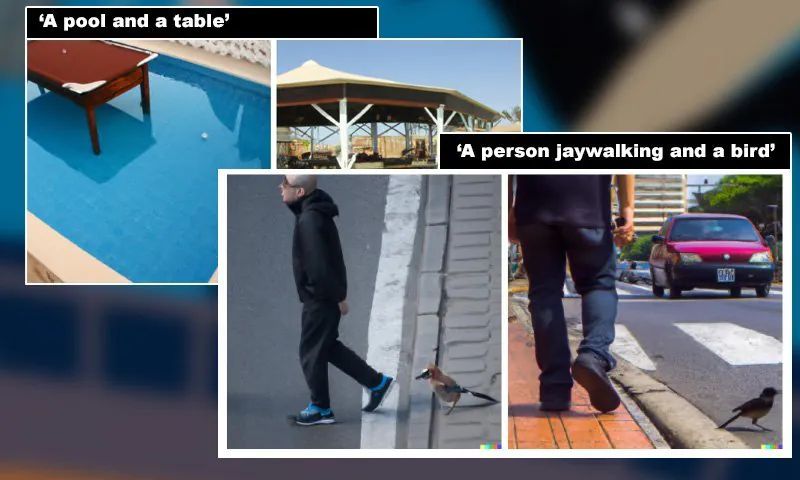
Изучая этот недостаток, новое исследовательское сотрудничество из Университета Бар-Илана и Института искусственного интеллекта Аллена предлагает обширное исследование степени, в которой DALL-E 2 склоняется к таким семантическим ошибкам:

Двойные значения, разделенные на несколько интерпретаций в DALL-E 2 – хотя любая система латентной диффузии может производить такие примеры. В верхнем правом изображении удаление ‘gold’ из подсказки меняет вид рыбы, а в случае ‘зебрового перехода’ необходимо явно указать поверхность дороги, чтобы удалить дублированную ассоциацию. Источник: https://export.arxiv.org/pdf/2210.10606
Авторы обнаружили, что эта тенденция к двойной интерпретации слов и фраз, кажется, не только общей для всех моделей диффузии, управляемых CLIP, но и того, что она ухудшается, когда модели обучаются на все более и более больших объемах данных. В статье отмечается, что ‘сокращенные’ версии моделей текст-изображение, включая DALL-E Mini (теперь Craiyon), производят такие ошибки гораздо реже, и что Stable Diffusion также ошибается меньше – хотя только потому, что очень часто она не следует подсказке вообще, что является другим видом ошибки.

Простая подсказка ‘date’ заставляет DALL-E 2 вызвать два из нескольких значений слова, а слово ‘fan’ также разделяется на два его семантических отображения, и в третьем изображении фраза ‘cone’ надежно превращает неуказанную пищу в подсказке в мороженое, связанное с ‘cone’.
Объясняя, как мы выполняем эффективные лексические разделения, статья гласит:
‘Хотя символы – а также структуры предложений – могут быть двусмысленными, после того, как интерпретация построена, эта двусмысленность уже разрешена. Например, хотя английское слово ‘bat’ в выражении ‘a flying bat’ может быть интерпретирован как либо деревянная палка, либо животное, наши возможные интерпретации предложения являются либо летящей деревянной палкой, либо летящим животным, но никогда не обоими одновременно. Как только слово ‘bat’ было использовано в интерпретации для обозначения объекта (например, деревянной палки), оно не может быть повторно использовано для обозначения другого объекта (животного) в той же интерпретации.’
DALL-E 2, как отмечает статья, не ограничен таким образом:

‘A bat is flying over a baseball stadium’ – первое изображение из статьи, другие три получены просто путем подачи той же подсказки в DALL-E 2.
Это свойство было названо чувствительностью к ресурсам.
Статья идентифицирует три аномальные поведения, проявляемые DALL-E 2: что слово или фраза могут быть интерпретированы и эффективно разделены на два различных объекта, отображая объект или понятие для каждого в одной и той же сцене; что слово может быть интерпретировано как модификатор двух различных объектов (см. примеры ‘золотой рыбки’ и другие выше); и что слово может быть интерпретировано одновременно как модификатор и альтернативный объект – как в подсказке ‘a seal is opening a letter’:

‘A seal is opening a letter’ – первая иллюстрация из статьи, соседние три – идентичные репродукции из DALL-E 2. Фотореалистичные примеры ниже имели дополнительный текст ‘photo, Canon50, 85mm, F5.6, award-winning photo’.
Авторы идентифицируют два режима неудачи для моделей диффузии в этом отношении: что результаты пользовательских подсказок со словами, имеющими несколько значений, часто демонстрируют овеществленное слово вместе с некоторым проявлением понятия; и утечка понятий, где свойства одного объекта ‘протекают’ в другой отображаемый объект.
‘В целом, явления, которые мы изучаем, предоставляют доказательства ограничений лингвистических способностей DALLE-2 и открывают возможности для будущих исследований, которые бы выявили, исходят ли эти ограничения из проблем с кодированием текста, генеративной моделью или обоими. Более широко, предложенный подход может быть расширен на другие сценарии, где процесс декодирования используется для раскрытия индуктивного предубеждения и ограничений моделей текст-изображение.’
Используя 17 слов, которые заставляют DALL-E 2 разделить входные данные на несколько выходов, авторы наблюдали, что омонимическое дублирование произошло в более чем 80% из 216 отображенных изображений.
Исследователи использовали контрольные пары стимулов, чтобы изучить степень, в которой конкретный и, возможно, чрезмерно конкретный язык необходим для предотвращения этих дубликатов. Для тестов сущность-свойство были созданы 10 таких пар, и авторы отмечают, что стимульные подсказки вызывают общее свойство в 92,5% случаев, тогда как контрольная подсказка вызывает его только в 6,6% случаев.
‘[Чтобы] продемонстрировать, рассмотрим зебру и улицу, здесь зебра является сущностью, но она модифицирует улицу, и DALLE-2 постоянно генерирует пешеходные переходы, возможно, из-за сходства зебровых полос с пешеходным переходом. И в соответствии с нашей гипотезой, контроль ‘зебра и гравийная улица’ указывает на тип улицы, который обычно не имеет пешеходных переходов, и действительно, все наши контрольные образцы для этой подсказки не содержат пешеходного перехода.’





