Модели и платформы ИИ
Внедрение кода: всесторонний гид

 Добавьте Unite.AI в избранные источники в Google

Внедрение кода – это революционный способ представления фрагментов кода в виде плотных векторов в непрерывном пространстве. Эти внедрения кода захватывают семантические и функциональные отношения между фрагментами кода, что позволяет использовать мощные приложения в программировании с помощью ИИ. Аналогично внедрению слов в обработке естественного языка (NLP), внедрение кода размещает подобные фрагменты кода близко друг к другу в пространстве векторов, что позволяет машинам лучше понимать и манипулировать кодом.
Что такое внедрение кода?
Внедрение кода преобразует сложные структуры кода в числовые векторы, которые захватывают смысл и функциональность кода. В отличие от традиционных методов, которые рассматривают код как последовательность символов, внедрение кода захватывает семантические отношения между частями кода. Это имеет решающее значение для различных задач программной инженерии, таких как поиск кода, завершение кода, обнаружение ошибок и многое другое.
Например, рассмотрим две функции Python:
def add_numbers(a, b):
return a + b
<p>def sum_two_values(x, y):
result = x + y
return result</p>
Хотя эти функции выглядят по-разному синтаксически, они выполняют одну и ту же операцию. Хорошее внедрение кода должно представлять эти две функции с подобными векторами, захватывая их функциональное сходство, несмотря на их текстовые различия.

Внедрение вектора
Как создаются внедрения кода?
Существуют различные методы создания внедрений кода. Одним из распространенных подходов является использование нейронных сетей для обучения этих представлений на большом наборе данных кода. Сеть анализирует структуру кода, включая токены (ключевые слова, идентификаторы), синтаксис (как структурирован код) и потенциально комментарии, чтобы узнать отношения между разными фрагментами кода.
Давайте разберем этот процесс:
- Код как последовательность: Сначала фрагменты кода рассматриваются как последовательности токенов (переменных, ключевых слов, операторов).
- Обучение нейронной сети: Нейронная сеть обрабатывает эти последовательности и учится сопоставлять их с фиксированными векторными представлениями. Сеть учитывает такие факторы, как синтаксис, семантика и отношения между элементами кода.
- Захват сходства: Цель обучения – разместить подобные фрагменты кода (с подобной функциональностью) близко друг к другу в пространстве векторов. Это позволяет выполнять задачи, такие как поиск подобного кода или сравнение функциональности.
Вот упрощенный пример на Python, показывающий, как можно предварительно обработать код для внедрения:
import ast

<p>def tokenize_code(code_string):
tree = ast.parse(code_string)
tokens = []
for node in ast.walk(tree):
if isinstance(node, ast.Name):
tokens.append(node.id)
elif isinstance(node, ast.Str):
tokens.append('STRING')
elif isinstance(node, ast.Num):
tokens.append('NUMBER')
# Добавьте больше типов узлов по мере необходимости
return tokens</p>

<p># Пример использования
code = """
def greet(name):
print("Hello, " + name + "!")
"""
tokens = tokenize_code(code)
print(tokens)
# Вывод: ['def', 'greet', 'name', 'print', 'STRING', 'name', 'STRING']</p>
Это токенизированное представление затем можно подать в нейронную сеть для внедрения.
Существующие подходы к внедрению кода
Существующие методы внедрения кода можно классифицировать на три основные категории:
Методы на основе токенов
Методы на основе токенов рассматривают код как последовательность лексических токенов. Техники, такие как Term Frequency-Inverse Document Frequency (TF-IDF) и модели глубокого обучения, такие как CodeBERT, относятся к этой категории.
Методы на основе деревьев
Методы на основе деревьев парсят код в абстрактные синтаксические деревья (AST) или другие структуры дерева, захватывая синтаксические и семантические правила кода. Примерами являются деревья нейронных сетей и модели, такие как code2vec и ASTNN.
Методы на основе графов
Методы на основе графов строят графы из кода, такие как графы потока управления (CFG) и графы потока данных (DFG), для представления динамического поведения и зависимостей кода. GraphCodeBERT – это заметный пример.
TransformCode: фреймворк для внедрения кода
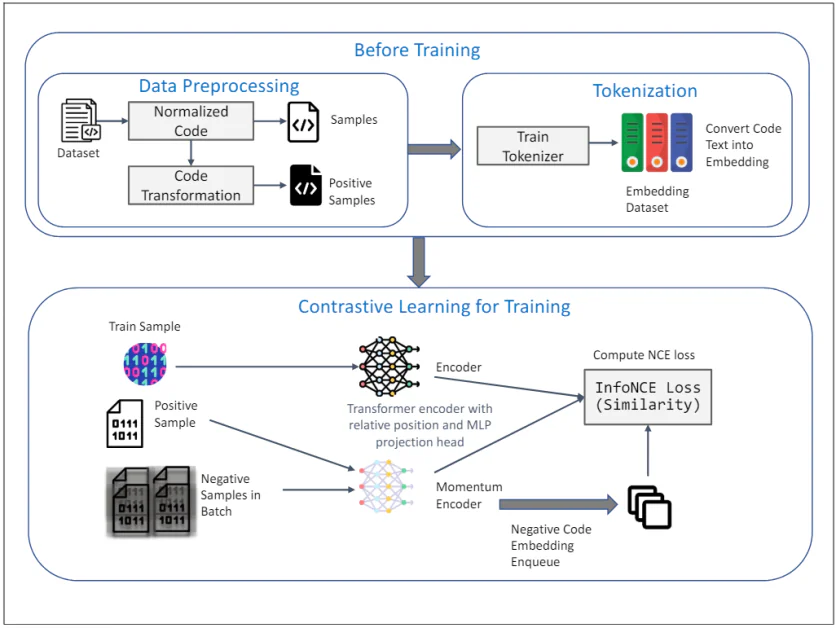
TransformCode: обучение без учителя внедрения кода
TransformCode – это фреймворк, который устраняет ограничения существующих методов, обучая внедрения кода в контрастивном обучении. Он не зависит от кодировщика и языка, что означает, что он может использовать любую модель кодировщика и обрабатывать любой язык программирования.
Диаграмма выше иллюстрирует фреймворк TransformCode для обучения без учителя внедрения кода с помощью контрастивного обучения. Он состоит из двух основных фаз: До обучения и Контрастивное обучение для обучения. Вот подробное объяснение каждого компонента:
До обучения
1. Предварительная обработка данных:
- Набор данных: Первоначальный входной набор данных, содержащий фрагменты кода.
- Нормализованный код: Фрагменты кода проходят нормализацию для удаления комментариев и переименования переменных в стандартный формат. Это помогает уменьшить влияние именования переменных на процесс обучения и улучшить обобщаемость модели.
- Преобразование кода: Нормализованный код затем преобразуется с помощью различных синтаксических и семантических преобразований для генерации положительных образцов. Эти преобразования обеспечивают, что семантический смысл кода остается неизменным, предоставляя разнообразные и прочные образцы для контрастивного обучения.
2. Токенизация:
- Обучение токенизатора: Токенизатор обучается на наборе данных кода для преобразования текста кода в внедрения. Это включает в себя разбиение кода на более мелкие единицы, такие как токены, которые могут быть обработаны моделью.
- Набор данных внедрений: Обученный токенизатор используется для преобразования всего набора данных кода в внедрения, которые служат входными данными для фазы контрастивного обучения.
Контрастивное обучение для обучения
3. Процесс обучения:
- Образец для обучения: Образец из набора данных для обучения выбирается в качестве представления запроса кода.
- Положительный образец: Соответствующий положительный образец – это преобразованная версия запроса кода, полученная во время предварительной обработки данных.
- Отрицательные образцы в пакете: Отрицательные образцы – это все остальные образцы кода в текущем мини-пакете, которые отличаются от положительного образца.
4. Кодировщик и кодировщик с импульсом:
- Кодирующий трансформер с относительной позицией и головкой проекции MLP: И запрос, и положительный образцы подают в кодирующий трансформер. Кодировщик включает относительную позиционную кодировку для захвата синтаксической структуры и отношений между токенами в коде. Головка проекции MLP используется для сопоставления закодированных представлений с пространством более низкой размерности, где применяется цель контрастивного обучения.
- Кодирующий импульс: Также используется кодировщик импульса, который обновляется как скользящее среднее параметров кодировщика запроса. Это помогает поддерживать последовательность и разнообразие представлений, предотвращая коллапс контрастивной потери. Отрицательные образцы кодируются с помощью этого кодировщика импульса и добавляются в очередь для контрастивного обучения.
5. Цель контрастивного обучения:
- Расчет потери InfoNCE (сходства): Потеря InfoNCE (оценка контрастивного шума) рассчитывается для максимизации сходства между запросом и положительными образцами, а также для минимизации сходства между запросом и отрицательными образцами. Эта цель обеспечивает, что обученные внедрения являются дискриминативными и прочными, захватывая семантическое сходство фрагментов кода.
Весь фреймворк использует сильные стороны контрастивного обучения для изучения осмысленных и прочных внедрений кода из неаннотированных данных. Использование преобразований AST и кодировщика импульса еще больше улучшает качество и эффективность обученных представлений, делая TransformCode мощным инструментом для различных задач программной инженерии.
Ключевые особенности TransformCode
- Гибкость и адаптируемость: Может быть расширен для различных задач, требующих представления кода.
- Эффективность и масштабируемость: Не требует большой модели или обширных данных для обучения, поддерживает любой язык программирования.
- Обучение без учителя и с учителем: Может быть применен как к обучению без учителя, так и к обучению с учителем, включая задачи-специфические метки или цели.
- Настраиваемые параметры: Количество параметров кодировщика можно регулировать в зависимости от доступных вычислительных ресурсов.
TransformCode вводит технику аугментации данных, называемую преобразованием AST, которая применяет синтаксические и семантические преобразования к исходным фрагментам кода. Это генерирует разнообразные и прочные образцы для контрастивного обучения.
Применения внедрений кода
Внедрения кода революционизировали различные аспекты программной инженерии, преобразуя код из текстового формата в числовое представление, которое можно использовать моделями машинного обучения. Вот некоторые ключевые применения:
Улучшенный поиск кода
Традиционно поиск кода полагался на совпадение ключевых слов, что часто приводило к нерелевантным результатам. Внедрения кода позволяют выполнять семантический поиск, где фрагменты кода ранжируются на основе их сходства по функциональности, даже если они используют разные ключевые слова. Это значительно улучшает точность и эффективность поиска релевантного кода в больших базах кода.
Умное завершение кода
Инструменты завершения кода предлагают релевантные фрагменты кода на основе текущего контекста. Используя внедрения кода, эти инструменты могут предоставлять более точные и полезные предложения, понимая семантический смысл кода, который пишется. Это переводится в более быстрый и продуктивный опыт программирования.
Автоматическая коррекция кода и обнаружение ошибок
Внедрения кода можно использовать для выявления шаблонов, которые часто указывают на ошибки или неэффективности в коде. Анализируя сходство между фрагментами кода и известными шаблонами ошибок, эти системы могут автоматически предлагать исправления или выделять области, которые могут потребовать дальнейшего осмотра.
Улучшенная суммаризация кода и генерация документации
Большие базы кода часто не имеют надлежащей документации, что затрудняет новым разработчикам понимание их работы. Внедрения кода могут создавать краткие суммарии, которые захватывают суть функциональности кода. Это не только улучшает поддержку кода, но и облегчает передачу знаний внутри команд разработчиков.
Улучшенные обзоры кода
Обзоры кода имеют решающее значение для поддержания качества кода. Внедрения кода могут помочь рецензентам, выделяя потенциальные проблемы и предлагая улучшения. Кроме того, они могут облегчить сравнения между разными версиями кода, что делает процесс обзора более эффективным.
Кросс-лингвальная обработка кода
Мир разработки программного обеспечения не ограничивается одним языком программирования. Внедрения кода имеют потенциал для облегчения задач кросс-лингвальной обработки кода. Захватывая семантические отношения между кодом, написанным на разных языках, эти методы могут позволить выполнять задачи, такие как поиск кода и анализ, на разных языках программирования.