
Взгляд Anderson
Adobe Research расширяет возможности редактирования лиц с разделением признаков в GAN

 Добавьте Unite.AI в избранные источники в Google
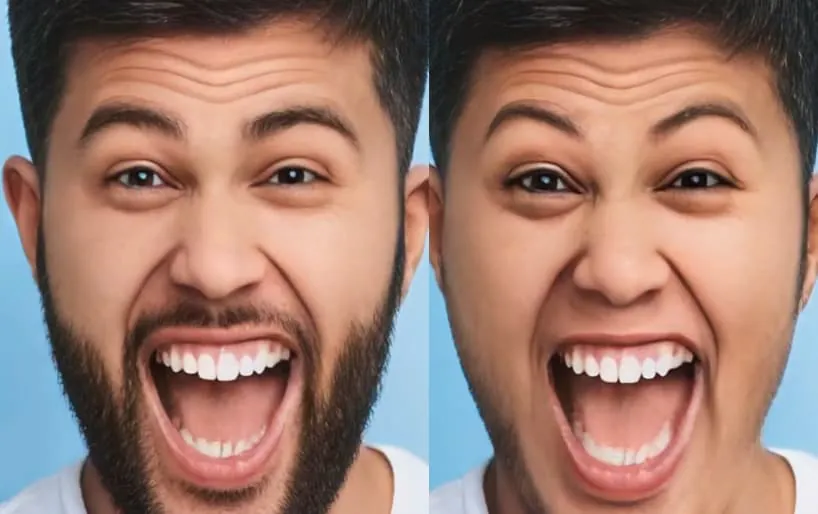
Ключевые моментыСкрытый преобразователь Adobe фиксирует личность при редактировании 35 черт лица без…
Показать больше
- Скрытый преобразователь Adobe фиксирует личность при редактировании 35 черт лица без переобучения.
- Система использует FaceNet в качестве дискриминатора для предотвращения деградации идентичности при трансформации атрибутов.
- Конкурирующие фреймворки, такие как InterFaceGAN, смешивают возраст с полом или очками, но подход Adobe избегает этих побочных эффектов.
Несложно понять, почему переплетение является проблемой в синтезе изображений, поскольку это часто проблема и в других областях жизни; например, намного сложнее удалить куркуму из карри, чем выбросить соленый огурец из бургера, и практически невозможно удалить сладость из чашки кофе. Некоторые вещи просто поставляются в комплекте.
Аналогично, переплетение является препятствием для архитектур синтеза изображений, которые идеально хотели бы разделить различные функции и понятия при использовании машинного обучения для создания или редактирования лиц (или собак, лодок или любой другой области).
Если бы вы могли разделить такие нити, как возраст, пол, цвет волос, тон кожи, эмоция и так далее, у вас появились бы настоящие инструменты и гибкая система для детального создания и редактирования изображений лиц, не таща нежелательных “пассажиров” в эти преобразования.

При максимальном переплетении (выше слева) вы можете только изменить изображение обученной сети GAN на изображение другого человека.
Это фактически использование последней технологии компьютерного зрения для достижения того, что было решено другими средствами более тридцати лет назад.
С некоторой степенью разделения (‘Среднее разделение’ на более раннем изображении выше), можно выполнить изменения стиля, такие как изменение цвета волос, выражения, косметического нанесения и ограниченного поворота головы, среди прочего.

Источник: FEAT: Редактирование лица с вниманием, февраль 2022, https://arxiv.org/pdf/2202.02713.pdf
Было несколько попыток в последние два года создать интерактивные среды редактирования лица, которые позволяют пользователю изменять характеристики лица с помощью ползунков и других традиционных взаимодействий с пользовательским интерфейсом, сохраняя при этом основные черты целевого лица при внесении изменений. Однако это оказалось сложной задачей из-за переплетения функций/стиля в латентном пространстве GAN.
Например, черта очков часто переплетается с чертой возраста, что означает, что добавление очков может также “возрастить” лицо, а изменение возраста лица может добавить очки, в зависимости от степени разделения высокоуровневых функций (см. “Тестирование” ниже для примеров).
Было почти невозможно изменить цвет волос и другие аспекты волос без перерасчета волос и их расположения, что дает “шипящий”, переходный эффект.

Источник: Демо InterFaceGAN (CVPR 2020), https://www.youtube.com/watch?v=uoftpl3Bj6w
Прохождение от латентного к латентному GAN
Новая статья, возглавляемая Adobe (ADBE ), представленная на WACV 2022, предлагает новый подход к этим основным проблемам в статье под названием От латентного к латентному: обученное отображение для редактирования нескольких атрибутов лица с сохранением личности в изображениях, сгенерированных StyleGAN.
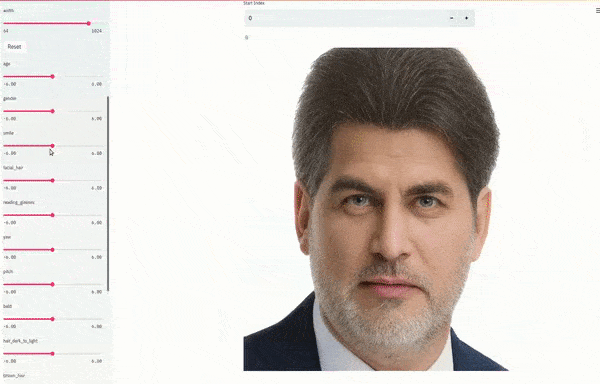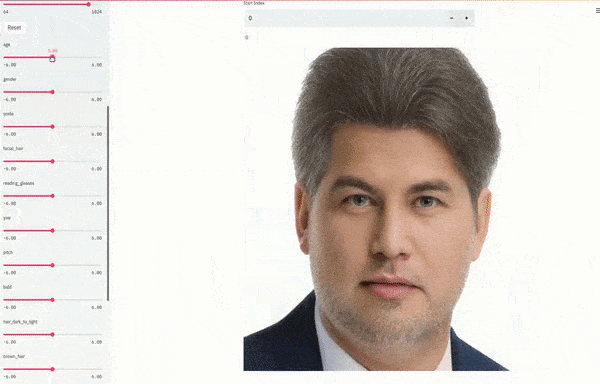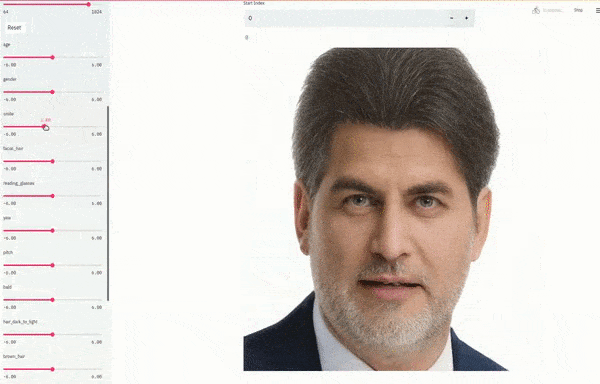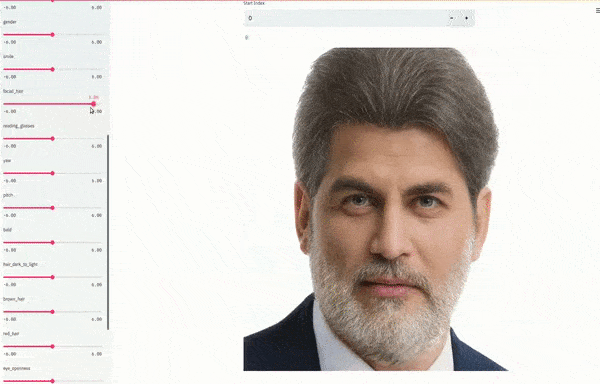
Дополнительный материал из статьи Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images. Здесь видно, что основные характеристики лица не втягиваются в не связанные с ними изменения. Полное видео в конце статьи позволяет рассмотреть больше деталей в более высоком разрешении. Источник: https://www.youtube.com/watch?v=rf_61llRH0Q
Работу возглавил прикладной исследователь Adobe Siavash Khodadadeh совместно с четырьмя другими исследователями Adobe и исследователем с кафедры компьютерных наук Университета Центральной Флориды.
Статья интересна частично потому, что Adobe уже некоторое время работает в этой области, и заманчиво представить себе эту функциональность в проекте Creative Suite в ближайшие несколько лет; но в основном потому, что архитектура, созданная для этого проекта, использует другой подход к сохранению визуальной целостности в редакторе лица GAN при внесении изменений.
Авторы заявляют:
‘[Мы] обучаем нейронную сеть для выполнения латентного преобразования, которое находит латентное кодирование, соответствующее изображению с измененным атрибутом. Поскольку этот метод выполняет преобразование за один шаг, он не полагается на линейную или нелинейную траекторию постепенного изменения атрибутов.’
‘Благодаря сквозному обучению сети на всем конвейере генерации система может адаптироваться к латентным пространствам архитектур генераторов. Свойства сохранения, такие как сохранение идентичности человека, могут быть закодированы в виде обучающих потерь. ‘
‘Как только сеть латентного преобразования была обучена, ее можно повторно использовать для произвольных изображений без переобучения.’
Это последнее утверждение означает, что предложенная архитектура поступает к конечному пользователю уже обученной. Ей все еще необходимо запустить нейронную сеть на локальных ресурсах, но новые изображения можно “бросить” и они будут готовы для изменения почти сразу, поскольку фреймворк достаточно декуплирован, чтобы не требовать дальнейшего обучения, специфичного для изображения.
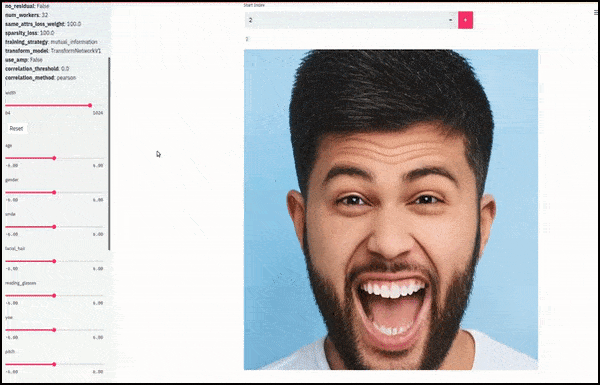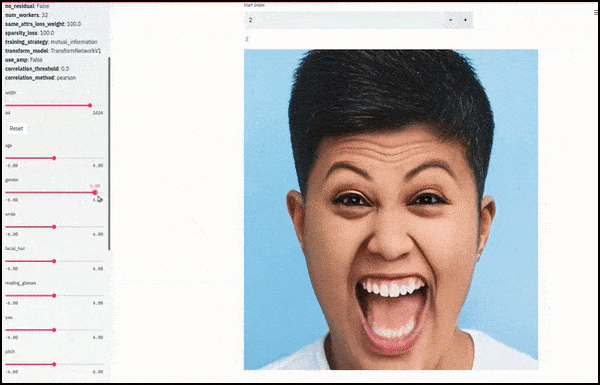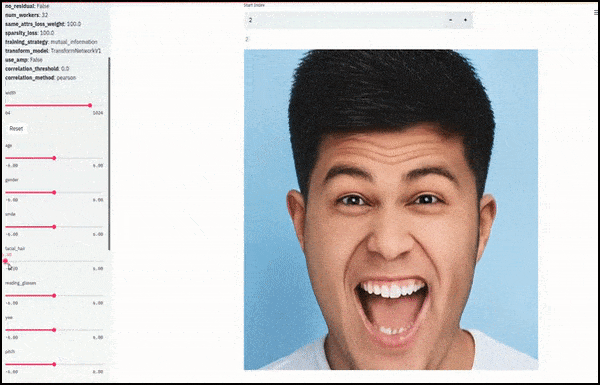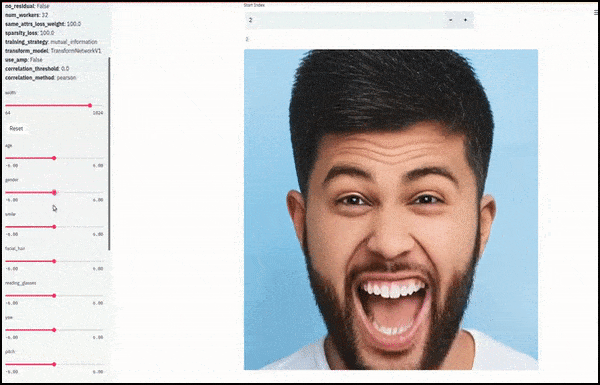
Пол и растительность на лице меняются по мере того, как ползунки задают случайные и произвольные траектории в латентном пространстве, а не просто перемещаются между конечными точками. Больше преобразований в высоком разрешении показано во встроенном видео в конце статьи.
Среди основных достижений в работе – способность сети “заморозить” идентичности в латентном пространстве, изменяя только атрибут в целевом векторе, и предоставляя “поправочные члены”, которые сохраняют идентичности, подвергаемые преобразованию.
По сути, предложенная сеть встроена в более широкую архитектуру, которая оркестрирует все обработанные элементы, которые проходят через предварительно обученные компоненты с замороженными весами, которые не будут производить нежелательные боковые эффекты на преобразованиях.
Поскольку процесс обучения полагается на триплеты, которые можно сгенерировать либо из исходного изображения (под обратным преобразованием GAN), либо из существующего начального латентного кодирования, весь процесс обучения проходит без учителя, а неявные операции привычных систем разметки и отбора данных фактически уже встроены в архитектуру. Фактически, новая система использует готовые атрибутные регрессоры:
‘[Количество] атрибутов, которые наша сеть может независимо контролировать, ограничено только возможностями распознавателя(ей) – если у вас есть распознаватель для атрибута, мы можем добавить его к произвольным лицам. В наших экспериментах мы обучили сеть латентного преобразования для регулирования 35 различных атрибутов лица, больше, чем в любом предыдущем подходе.’
Система включает дополнительную защиту от нежелательных “побочных” преобразований: в отсутствие запроса на изменение атрибута сеть латентного преобразования будет сопоставлять латентный вектор с самим собой, еще больше увеличивая стабильное сохранение целевой идентичности.
Распознавание лица
Одна из повторяющихся проблем с редакторами лица GAN и архитектурами кодирователя/декодирователя за последние несколько лет заключалась в том, что применяемые преобразования склонны ухудшать сходство. Чтобы бороться с этим, проект Adobe использует встроенную сеть распознавания лица под названием FaceNet в качестве дискриминатора.

Архитектура проекта: FaceNet расположен внизу слева от центра. Источник: Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images, OpenAccess.
(На личной заметке, это, кажется, обнадеживающий шаг к интеграции стандартных систем распознавания лица и даже распознавания выражений в генеративные сети, вероятно, лучший способ преодолеть слепое сопоставление пикселей с пикселями, которое доминирует в текущих архитектурах deepfake за счет верности выражения и других важных областей в секторе генерации лица.)
Доступ ко всем областям в латентном пространстве
Еще одной впечатляющей особенностью фреймворка является его способность путешествовать произвольно между потенциальными преобразованиями в латентном пространстве, по желанию пользователя. Несколько предыдущих систем, которые предоставляли исследовательские интерфейсы, часто оставляли пользователя в основном “прокручивающим” между фиксированными временными шкалами преобразования функций – впечатляюще, но часто довольно линейным или предписанным опытом.
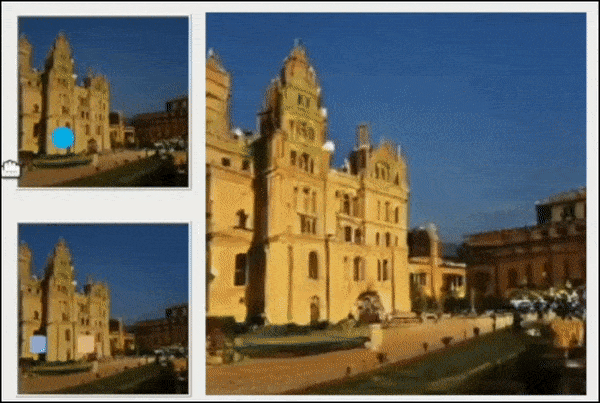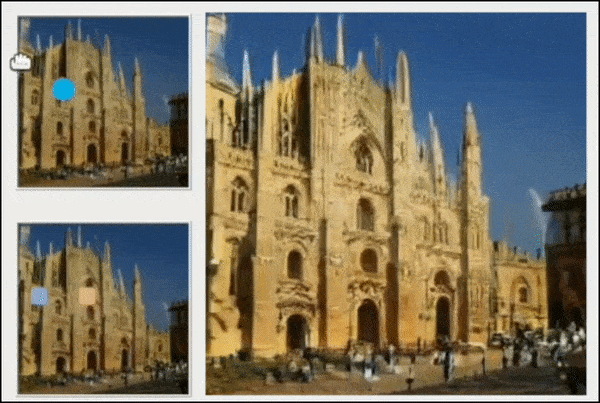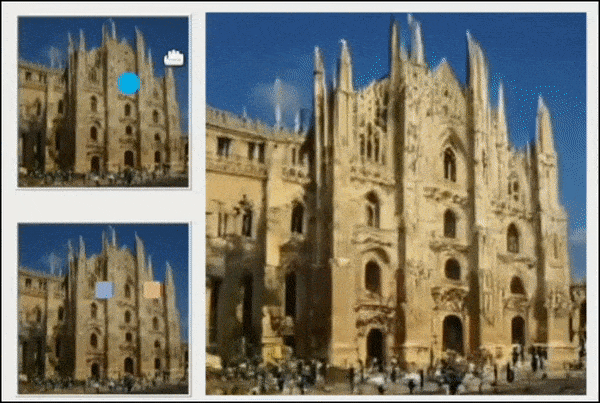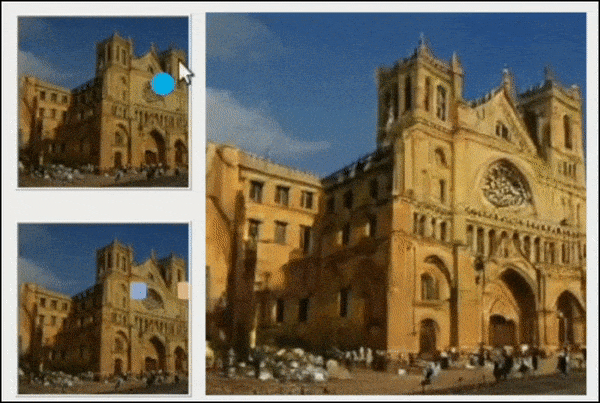
Из работы Улучшение равновесия GAN путем повышения пространственной осведомленности: пользователь перемещается между возможными точками перехода, соединяющими два положения в латентном пространстве, но остается в пределах заранее обученных положений. Для других преобразований того же материала требуется перенастройка и/или повторное обучение. Источник: https://genforce.github.io/eqgan/
Помимо использования совершенно новых изображений, пользователь также может вручную “заморозить” элементы, которые он хочет сохранить во время процесса преобразования. Таким образом пользователь может гарантировать, что (например) фоны не смещаются или что глаза остаются открытыми или закрытыми.
Данные
Сеть регрессии атрибутов была обучена на трех наборах данных: FFHQ, CelebAMask-HQ и локальном наборе данных, сгенерированном GAN путем выборки 400 000 векторов из пространства Z StyleGAN-V2.
Изображения вне распределения (OOD) были отфильтрованы, и атрибуты были извлечены с помощью Face API от Microsoft, в результате чего получился набор изображений, разделенный на 90/10, оставив 721 218 обучающих изображений и 72 172 тестовых изображений для сравнения.
Тестирование
Хотя экспериментальная сеть была первоначально сконфигурирована для размещения 35 потенциальных преобразований, они были сокращены до восьми для проведения аналогичного тестирования против сравнимых фреймворков InterFaceGAN, GANSpace и StyleFlow.
Восемь выбранных атрибутов были возраст, лысость, борода, выражение, пол, очки, наклон головы вверх или вниз и поворот головы в сторону. Было необходимо переоборудовать конкурирующие фреймворки для некоторых из восьми атрибутов, которые не были предусмотрены в исходной версии, таких как добавление лысости и бороды в InterFaceGAN.
Как ожидаемо, более высокий уровень переплетения произошел в соперничающих архитектурах. Например, в одном тесте InterFaceGAN и StyleFlow оба изменили пол субъекта, когда был запрос на применение возраста:

Два конкурирующих фреймворка ввели изменение пола в преобразование ‘возраста’, также изменив цвет волос без прямого указания пользователя.
Кроме того, два из соперников обнаружили, что очки и возраст являются неотделимыми аспектами:

Очки и изменение цвета волос включены без дополнительной платы!
Это не безоговорочная победа исследования по всем показателям: как можно увидеть в сопровождающем видео, встроенном в конце статьи, фреймворк наименее эффективен, когда пытается экстраполировать различные углы поворота головы в сторону, в то время как GANSpace имеет лучший общий результат для возраста и наложения очков. Система латентного преобразования показала одинаковые результаты с GANSpace и StyleFlow в отношении изменения наклона головы вверх или вниз.

Результаты, рассчитанные на основе калибровки детектора лица MTCNN. Более низкие результаты лучше.
Для получения дополнительной информации и лучшего разрешения примеров см. сопровождающее видео ниже.
Опубликовано впервые 16 февраля 2022 года.





