
Unghiul lui Anderson
UniTune: tehnica alternativă Google de editare neuronală a imaginilor

 Adaugă Unite.AI la sursele tale preferate pe Google
Puncte cheieUniTune reglează fin un model de difuzie pe o singură imagine pentru a permite editări…
Vezi mai mult
- UniTune reglează fin un model de difuzie pe o singură imagine pentru a permite editări precise ghidate de text.
- Spre deosebire de DreamBooth sau Textual Inversion, UniTune respinge ambele abordări pentru o mai bună păstrare a detaliilor.
- Metoda atinge o separare semantică ridicată, păstrând fețele intacte în timpul transformărilor radicale ale fundalului.
Cercetarea Google pare să atace editarea imaginilor pe baza textului din mai multe direcții și, probabil, așteaptă să vadă ce “prinde”. Imediat după lansarea din această săptămână a lucrării Imagic, gigantul căutării a propus o metodă latentă de difuzie suplimentară pentru efectuarea unor editări cu totul imposibile pe baza comenzilor text, numită UniTune.
Pe baza exemplelor prezentate în documentul proiectului nou, UniTune a atins un grad extraordinar de descompunere a poziției semantice și a ideii de la conținutul real al imaginii:

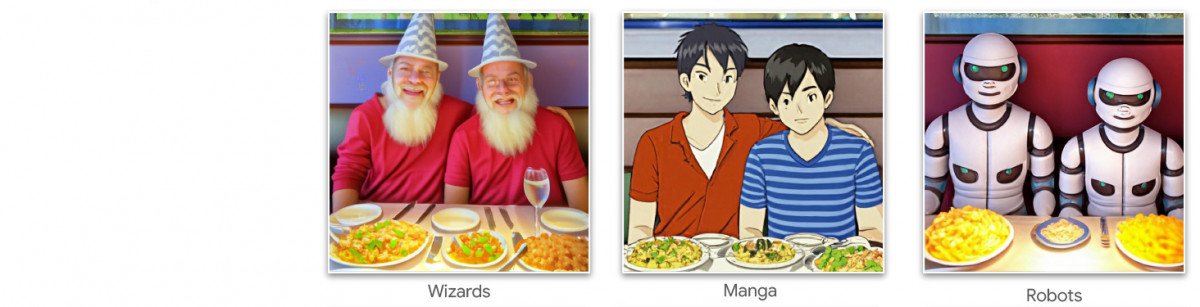

Comanda UniTune asupra compoziției semantice este remarcabilă. Observați cum, în rândul superior de imagini, fețele celor două persoane nu au fost distorsionate de transformarea extraordinară a restului imaginii sursă (dreapta). Sursă: https://arxiv.org/pdf/2210.09477.pdf
În calitate de fani ai Stable Diffusion, probabil ați învățat deja că aplicarea editărilor asupra unor secțiuni parțiale ale unei imagini fără a altera negativ restul imaginii poate fi o operațiune dificilă, uneori imposibilă. Deși distribuțiile populare, cum ar fi AUTOMATIC1111, pot crea masti pentru editări locale și restricționate, procesul este tortuos și adesea imprevizibil.
Răspunsul evident, cel puțin pentru un practician în domeniul viziunii computerizate, este de a interpune un strat de segmentare semantică care poate recunoaște și izola obiecte dintr-o imagine fără intervenția utilizatorului, și, într-adevăr, au existat recent mai multe inițiative noi de-a lungul acestei linii de gândire.
O altă posibilitate pentru blocarea operațiunilor de editare a imaginilor neuronale haotice și încurcate este de a utiliza modulul Contrastive Language-Image Pre-training (CLIP) al OpenAI, care se află în centrul modelelor de difuzie latentă, cum ar fi DALL-E 2 și Stable Diffusion, pentru a acționa ca un filtru în punctul în care un model text-Imagine este gata să trimită un render interpretat înapoi utilizatorului. În acest context, CLIP ar trebui să acționeze ca un sentinel și modul de control al calității, respingând renderurile deformate sau altfel inadecvate. Acest lucru urmează să fie instituit (legătură Discord) la portalul DreamStudio al Stability.ai, accesat prin API. Totuși, întrucât CLIP este probabil atât cauza, cât și soluția într-un asemenea scenariu (deoarece a influențat și modul în care a fost creată imaginea), iar cerințele hardware pot depăși resursele disponibile local unui utilizator final, această abordare ar putea să nu fie ideală.
Limbaj Comprimat
UniTune propus în schimb “ajustează” un model de difuzie existent – în acest caz, Imagen al Google, deși cercetătorii afirmă că metoda este compatibilă cu alte arhitecturi de difuzie latentă – astfel încât un token unic este injectat în acesta, care poate fi chemat prin includerea acestuia într-un prompt text.
La prima vedere, acest lucru pare a fi similar cu DreamBooth, care poate injecta caractere sau obiecte noi într-un punct de control existent, adesea în mai puțin de o oră, pe baza a doar câtorva imagini sursă; sau Textual Inversion, care creează fișiere “sidecar” pentru un punct de control, care sunt apoi tratate ca și cum ar fi fost antrenate inițial în model, și pot profita de resursele proprii ale modelului prin modificarea clasificatorului de text, rezultând un fișier mic (în comparație cu punctele de control minim 2GB ale DreamBooth).
În realitate, cercetătorii afirmă că UniTune a respins ambele abordări. Ei au constatat că Textual Inversion a omis prea multe detalii importante, în timp ce DreamBooth “a avut rezultate mai slabe și a durat mai mult” decât soluția pe care au decis-o în final.
Totuși, UniTune folosește aceeași abordare de „metaprompt” semantic încapsulat ca DreamBooth: modificările învățate sunt invocate prin cuvinte unice alese de persoana care antrenează modelul, fără a intra în conflict cu termenii existenți în modelul public antrenat cu mult efort.QUOTEOPEN„Pentru a efectua editarea, eșantionăm modelele ajustate cu promptul «[rare_tokens] edit_prompt» (de exemplu, «beikkpic doi câini într-un restaurant» sau «beikkpic un minion»).”QUOTECLOSE
Procesul
Deși este uimitor de ce două documente aproape identice, în ceea ce privește funcționalitatea finală, ar apărea de la Google în aceeași săptămână, există, în ciuda multor asemănări între cele două inițiative, cel puțin o diferență clară între UniTune și Imagic – aceasta din urmă utilizează prompturi de limbaj natural “necomprimate” pentru a ghida operațiunile de editare a imaginilor, în timp ce UniTune antrenează tokeni unici în stil DreamBooth.
Prin urmare, dacă ați edita cu Imagic și ați dori să efectuați o transformare de acest fel…

Din documentul UniTune – UniTune se poziționează împotriva cadrului de editare neurală rival, SDEdit. Rezultatele UniTune sunt în partea dreaptă, în timp ce masca estimată este vizibilă în a doua imagine de la stânga.
… în Imagic, ați introduce “a treia persoană, așezată în fundal, ca o bestie păroasă drăguță”.
Comanda echivalentă UniTune ar fi “Tipul de la spate ca [x]”, unde x este cuvântul ciudat și unic legat de conceptul fin-antrenat asociat cu personajul bestiei păroase.
În timp ce DreamBooth și Textual Inversion primesc mai multe imagini pentru a crea o abstracție de tip deepfake care poate fi controlată în numeroase poziții, UniTune și Imagic primesc o singură imagine: originalul nemodificat. Aceasta seamănă cu instrumentele de editare bazate pe GAN din ultimii ani, care convertesc imaginea de intrare în coduri din spațiul latent al GAN-ului, apoi deplasează aceste coduri în alte zone ale spațiului pentru a modifica imaginea (de exemplu, proiectând imaginea unui tânăr brunet prin coduri asociate cu „bătrân” sau „blond”). Prin comparație, rezultatele obținute astfel într-un model de difuzie sunt surprinzător de exacte și mult mai puțin ambigue.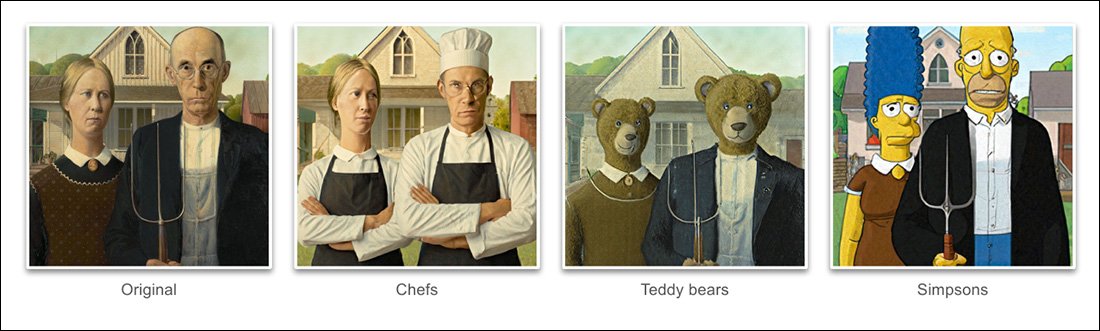
Procesul de ajustare fină
Metoda UniTune trimite în esență imaginea originală printr-un model de difuzie cu un set de instrucțiuni despre cum ar trebui modificată, utilizând repositoriile uriașe de date disponibile antrenate în model. În esență, puteți face acest lucru chiar acum cu funcționalitatea img2img a Stable Diffusion – dar nu fără a distorsiona sau a schimba în vreun fel părțile imaginii pe care ați prefera să le păstrați.
În timpul procesului UniTune, sistemul este ajustat, adică UniTune forțează modelul să reia antrenamentul, cu majoritatea straturilor sale decongelate (a se vedea mai jos). În majoritatea cazurilor, ajustarea va scădea valorile generale ale pierderii ale unui model de înaltă performanță, câștigat cu greu, în favoarea injectării sau rafinării unui alt aspect care este dorit să fie creat sau îmbunătățit.
Totuși, în UniTune, copia modelului asupra căreia se lucrează, chiar dacă ocupă mai mulți gigaocteți, pare tratată ca un „înveliș” de unică folosință și eliminată la final după îndeplinirea unui singur scop. Acest volum de date devine o criză zilnică de stocare pentru utilizatorii DreamBooth, ale căror modele, chiar și după reducere, ocupă cel puțin 2 GB pentru fiecare subiect. Ca în Imagic, ajustarea principală are loc pe cele două niveluri inferioare dintre cele trei ale Imagen (bază 64px, 64px>256px și 256px>1024px). Spre deosebire de Imagic, cercetătorii văd o valoare potențială și în ajustarea ultimului și celui mai mare nivel de super-rezoluție, deși încă nu au încercat-o. Pentru nivelul inferior de 64px, modelul este orientat spre imaginea de bază în timpul antrenării: perechi imagine/text duplicate sunt introduse timp de 128 de iterații, cu loturi de 4 și Adafactor ca funcție de pierdere, la o rată de învățare de 0,0001. Numai codificatorul T5 este înghețat în timpul acestei ajustări; el este înghețat și în antrenarea inițială a Imagen. Operația se repetă pentru nivelul 64>256px, cu aceeași procedură de augmentare cu zgomot folosită la antrenarea originală a Imagen.
Eșantionare
Există multe metode posibile de eșantionare prin care pot fi obținute modificările din modelul ajustat, inclusiv ghidarea fără clasificator (CFG), o piesă principală și a Stable Diffusion. CFG definește în esență măsura în care modelul este liber să “urmeze imaginația” și să exploreze posibilitățile de render – sau, în setări mai scăzute, măsura în care ar trebui să se conformeze datelor sursă de intrare și să facă modificări mai puțin ample sau dramatice.

Similar cu Textual Inversion (puțin mai puțin cu DreamBooth), UniTune este receptiv la aplicarea unor stiluri grafice distincte asupra imaginilor originale, precum și la editări mai fotorealiste.
Cercetătorii au experimentat, de asemenea, cu tehnica “început târziu” a SDEdit, în care sistemul este încurajat să păstreze detaliile originale prin faptul că este doar parțial “zgomot” de la început, ci mai degrabă menține caracteristicile sale esențiale. Deși cercetătorii au folosit-o doar pe stratul inferior (64px), ei cred că ar putea fi o tehnică de eșantionare utilă în viitor.
Cercetătorii au folosit și prompt-to-prompt ca tehnică text suplimentară pentru condiționarea modelului: QUOTEOPEN„În configurația «prompt to prompt», am constatat că tehnica pe care o numim Prompt Guidance este deosebit de utilă pentru reglarea fidelității și expresivității.”QUOTECLOSEQUOTEOPEN„Prompt Guidance seamănă cu ghidarea fără clasificator, dar referința este un alt prompt, nu modelul necondiționat. Aceasta ghidează modelul către diferența dintre cele două prompturi.”QUOTECLOSE

Prompt-to-prompt în UniTune izolează eficient zonele de modificat.
Totuși, autorii afirmă că ghidarea prin prompt a fost necesară doar uneori, când CFG nu obținea rezultatul dorit. O altă abordare nouă de eșantionare întâlnită în dezvoltarea UniTune a fost interpolarea: zonele imaginii sunt suficient de distincte, iar compoziția originalului și a imaginii modificate suficient de similară, pentru a permite o interpolare mai „naivă”.

Interpolarea poate face inutile procesele mai costisitoare ale UniTune când zonele de transformat sunt separate și bine delimitate.
Autorii sugerează că interpolarea ar putea funcționa atât de bine pentru multe imagini sursă încât să devină setarea implicită. Ea poate produce și transformări extraordinare când ocluziile complexe nu trebuie rezolvate prin metode mai intensive. UniTune poate face editări locale cu sau fără măști, dar poate decide și singur unde să le plaseze, combinând o putere neobișnuită de interpretare cu păstrarea robustă a trăsăturilor esențiale ale datelor sursă:

În imaginea de sus din a doua coloană, UniTune, solicitat să introducă un „tren roșu în fundal”, l-a plasat într-o poziție potrivită și autentică. În celelalte exemple, observați păstrarea integrității semantice față de sursă chiar și în schimbări extraordinare ale conținutului pixelilor și stilurilor de bază.
Latență
Deși prima iterație a oricărui sistem nou va fi întotdeauna lentă, și deși este posibil ca implicarea comunității sau angajamentul corporativ (de obicei nu este vorba de ambele) să accelereze și să optimizeze o rutină care consumă multe resurse, atât UniTune, cât și Imagic efectuează câteva manevre majore de învățare automată pentru a crea aceste editări uimitoare, și este discutabilă măsura în care un astfel de proces care consumă multe resurse ar putea fi redus la scară pentru uz casnic, în loc de acces API-driven (deși acesta din urmă poate fi mai de dorit pentru Google).
În acest moment, drumul dus-întors de la intrare la rezultat este de aproximativ 3 minute pe un GPU T4, cu aproximativ 30 de secunde suplimentare pentru inferență (conform oricărei rutine de inferență). Autorii recunosc că acesta este un timp de latență ridicat și abia calificat ca “interactiv”, dar ei observă, de asemenea, că modelul rămâne disponibil pentru editări suplimentare odată ce a fost ajustat inițial, până când utilizatorul termină procesul, ceea ce reduce timpul pe editare.
Publicat pentru prima dată pe 21 octombrie 2022.


