
Unghiul lui Anderson
Editarea obiectelor asistată de IA cu Imagic de la Google și Erase and Replace de la Runway

 Adaugă Unite.AI la sursele tale preferate pe Google

Puncte cheieImagic ajustează fin modelele de difuzie pentru editări granulare ale obiectelor, spre…
Vezi mai mult
- Imagic ajustează fin modelele de difuzie pentru editări granulare ale obiectelor, spre deosebire de Erase and Replace de la Runway, care doar înlocuiește.
- Erase and Replace de la Runway înlocuiește obiectele rapid, dar nu poate edita conținutul existent, ci doar îl înlocuiește.
- Optimizarea per imagine a Imagic durează opt minute pe cipuri TPUV4 gemene, limitându-l la utilizarea prin API.
Săptămâna aceasta, doi noi algoritmi grafici bazați pe IA, dar diferiți unul de celălalt, le oferă utilizatorilor modalități inedite de a modifica obiectele din fotografii cu un nivel ridicat de precizie și eficiență.
Primul este Imagic, de la Google Research, realizat în colaborare cu Institutul de Tehnologie din Israel și Institutul de Știință Weizmann. Imagic permite editarea detaliată a obiectelor pe baza unor instrucțiuni text, prin ajustarea fină a modelelor de difuzie.

Modificați ce doriți și lăsați restul neschimbat – Imagic promite editarea precisă doar a părților pe care vreți să le modificați. Sursa: https://arxiv.org/pdf/2210.09276.pdf
Oricine a încercat vreodată să modifice un singur element într-o nouă randare Stable Diffusion știe prea bine că, pentru fiecare editare reușită, sistemul va schimba cinci lucruri care vă plăceau exact așa cum erau. Acest neajuns îi obligă în prezent pe mulți dintre cei mai talentați entuziaști SD să treacă mereu de la Stable Diffusion la Photoshop și înapoi, pentru a remedia astfel de „daune colaterale”. Numai din acest punct de vedere, realizările Imagic par remarcabile.
La momentul redactării acestui articol, Imagic nu are încă nici măcar un videoclip de prezentare și, având în vedere atitudinea prudentă a Google față de lansarea unor instrumente de sinteză a imaginilor fără restricții, nu se știe dacă vom avea ocazia să testăm sistemul și, în caz afirmativ, în ce măsură.
Al doilea produs este funcția Erase and Replace de la Runway ML, mult mai accesibilă, o funcție nouă din secțiunea „AI Magic Tools” a suitei sale de instrumente pentru efecte vizuale bazate pe învățare automată, disponibilă exclusiv online.
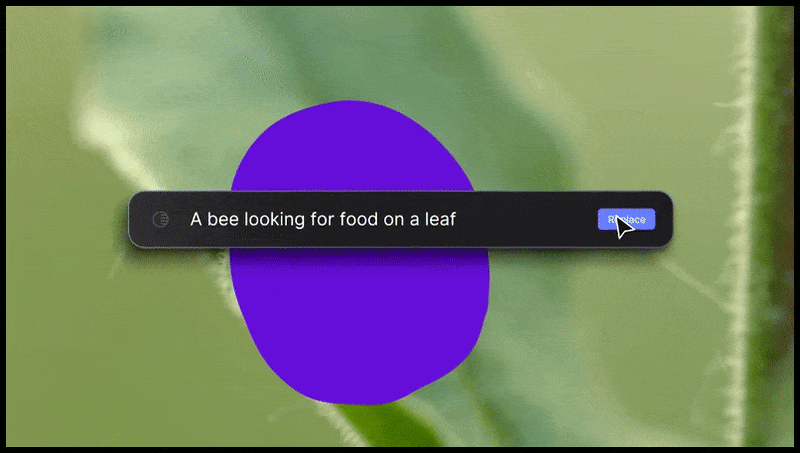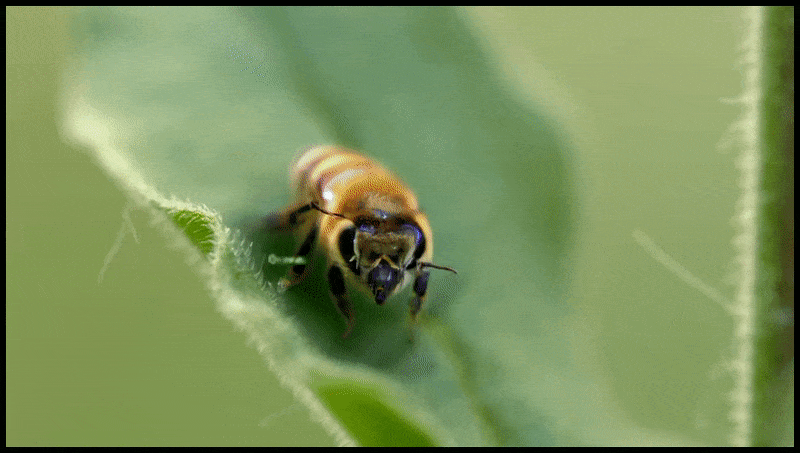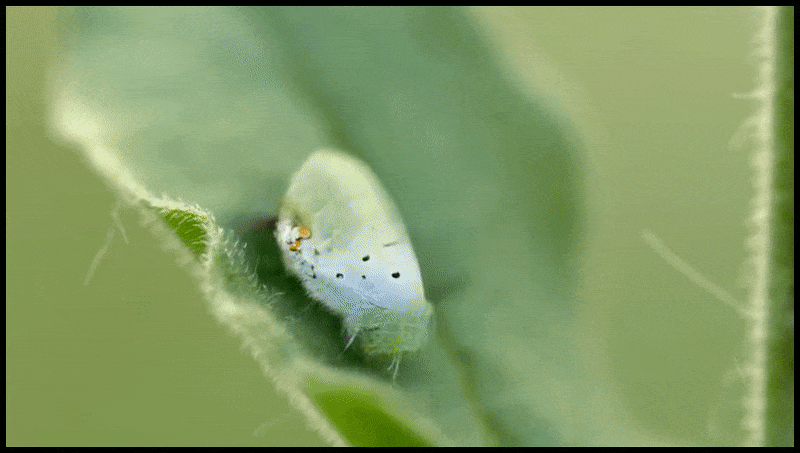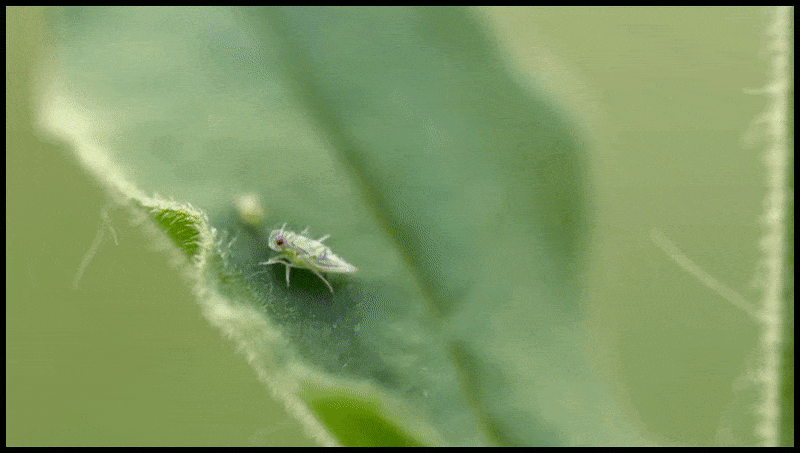
Funcția Erase and Replace de la Runway ML, prezentată deja într-o previzualizare a unui sistem de editare text-video.
Să vedem mai întâi ce oferă Runway.
Erase and Replace
La fel ca Imagic, Erase and Replace funcționează exclusiv cu imagini statice, deși Runway a prezentat în avanpremieră aceeași funcționalitate într-o soluție de editare text-video care nu a fost încă lansată:
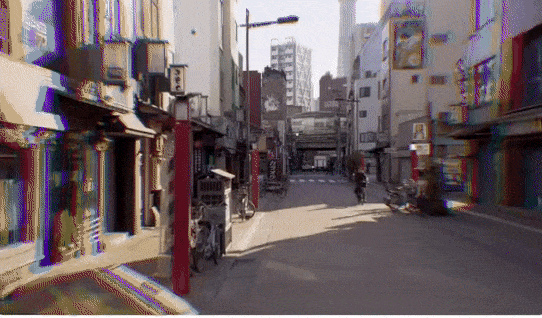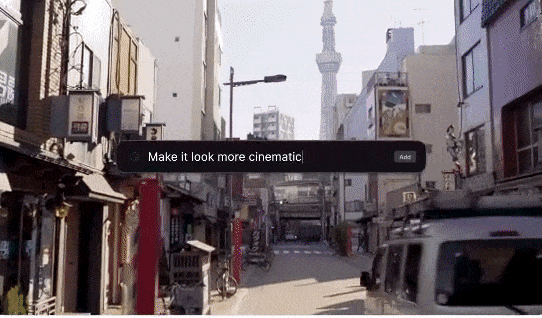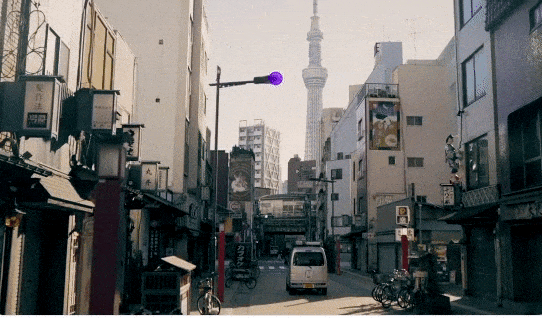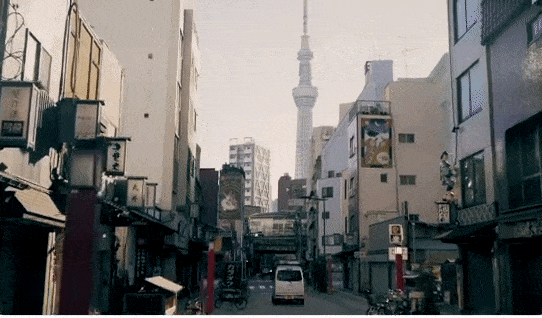
Oricine poate testa noua funcție Erase and Replace pe imagini, însă versiunea pentru videoclipuri nu este încă disponibilă publicului. Sursa: https://twitter.com/runwayml/status/1568220303808991232
Deși Runway ML nu a dezvăluit detalii despre tehnologiile din spatele funcției Erase and Replace, viteza cu care poți înlocui o plantă de apartament cu un bust destul de convingător al lui Ronald Reagan sugerează că motorul care reinventează obiectul ales în Erase and Replace este un model de difuzie precum Stable Diffusion (sau, mult mai puțin probabil, o versiune licențiată a DALL-E 2).

Înlocuirea unei plante de apartament cu un bust al lui The Gipper nu se face chiar atât de repede, dar e destul de rapidă. Sursa: https://app.runwayml.com/
Sistemul impune unele restricții de tipul celor din DALL-E 2: imaginile sau textele care declanșează filtrele Erase and Replace vor genera un avertisment că încălcările ulterioare ar putea duce la suspendarea contului — practic, o copie aproape identică a politicilor pe care OpenAI le aplică în continuare pentru DALL-E 2.
Multe dintre rezultate nu prezintă imperfecțiunile tipice ale Stable Diffusion. Runway ML este investitor și partener de cercetare în proiectul SD și este posibil să fi antrenat un model proprietar superior ponderilor checkpoint-ului open-source 1.4, cu care ne luptăm în prezent noi, ceilalți (în timp ce multe alte echipe de dezvoltare, atât amatoare, cât și profesioniste, antrenează sau ajustează fin modele Stable Diffusion).
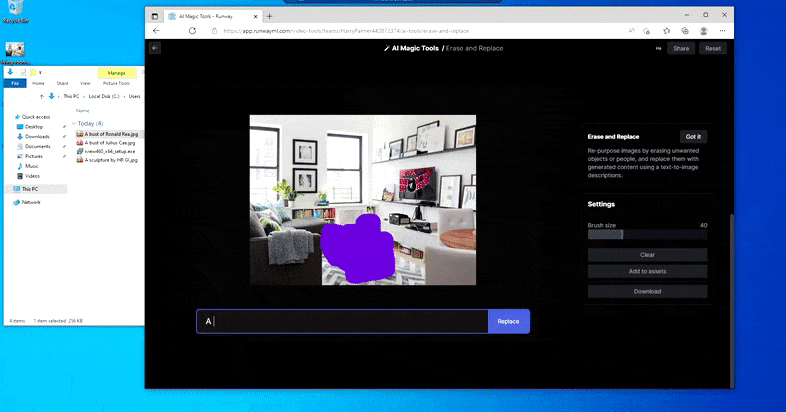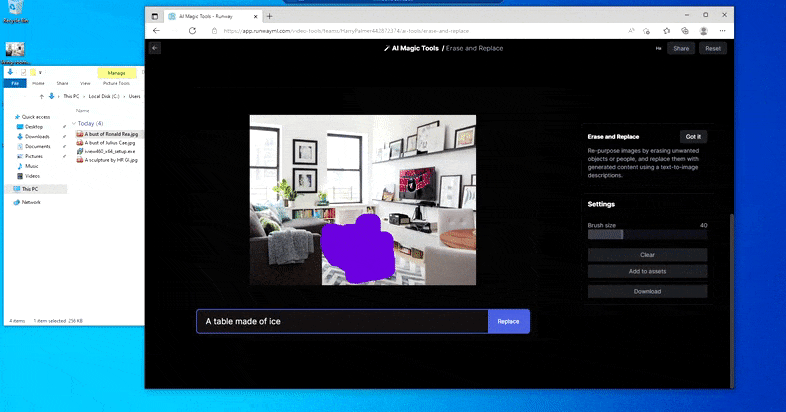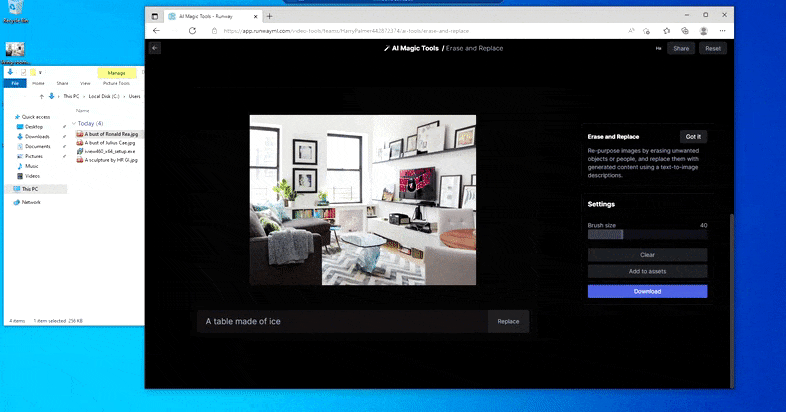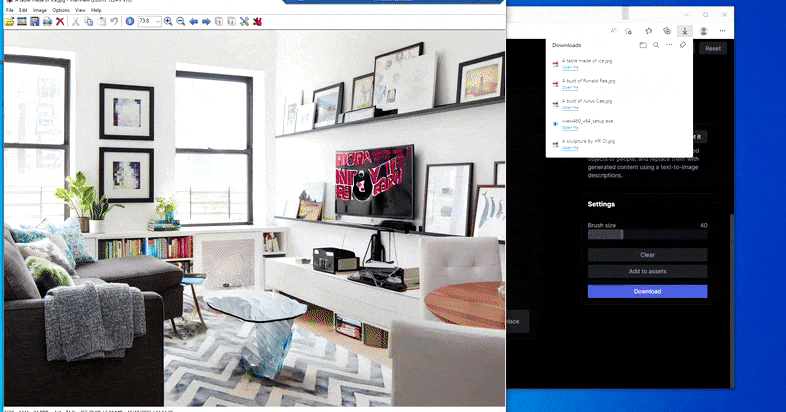
Înlocuirea unei mese de uz casnic cu o „masă făcută din gheață” în Erase and Replace de la Runway ML.
La fel ca Imagic (vezi mai jos), Erase and Replace este, ca să spunem așa, „orientat spre obiecte” — nu poți pur și simplu să ștergi o zonă „goală” din imagine și să o completezi cu rezultatul instrucțiunii text; într-o astfel de situație, sistemul va identifica pur și simplu cel mai apropiat obiect aparent de-a lungul liniei de vizibilitate a măștii (cum ar fi un perete sau un televizor) și va aplica transformarea acolo.
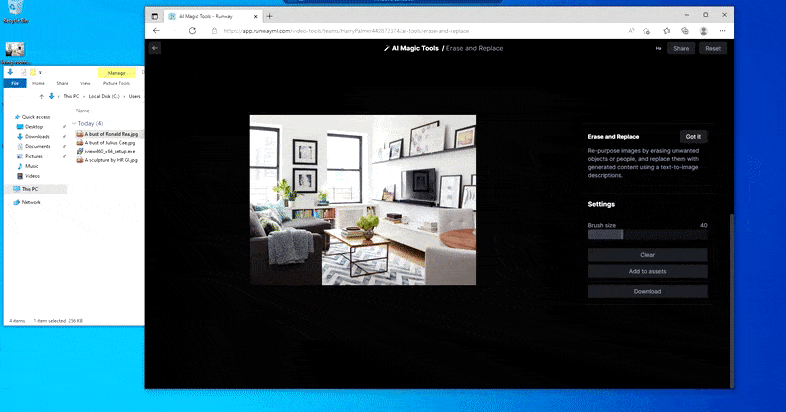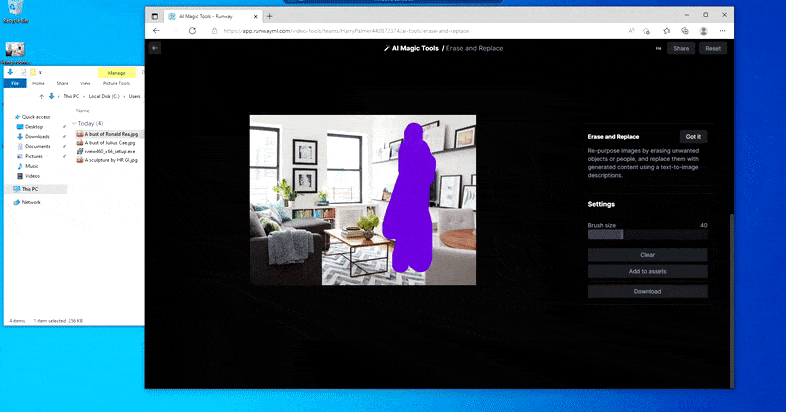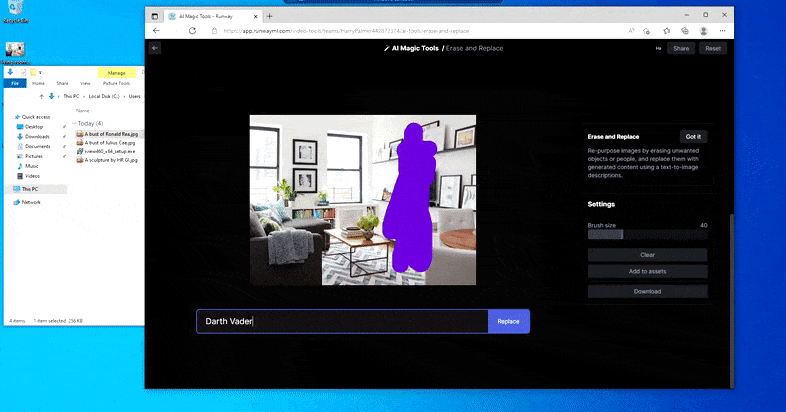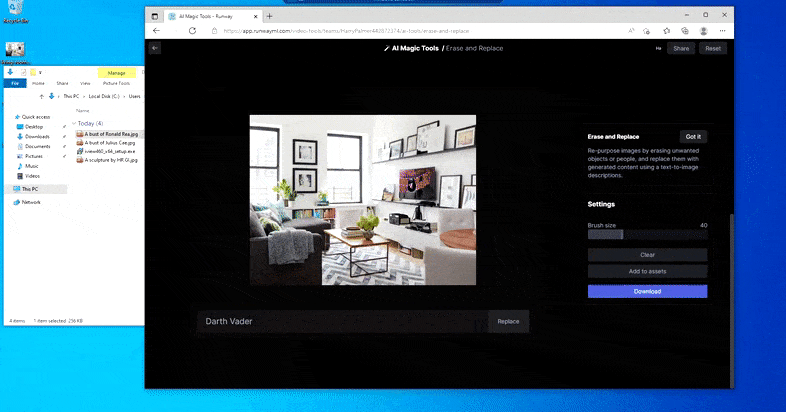
Așa cum sugerează și numele, în Erase and Replace nu poți insera obiecte într-un spațiu gol. Aici, o încercare de a-l invoca pe cel mai faimos dintre lorzii Sith produce o pictură murală ciudată, cu Vader, pe televizor, aproximativ în locul în care fusese desenată zona de înlocuire.
Este greu de spus dacă Erase and Replace evită să folosească imagini protejate prin drepturi de autor (care sunt în continuare, în mare parte, blocate în DALL-E 2, deși cu rezultate variabile) sau dacă modelul folosit de motorul de randare din backend pur și simplu nu este optimizat pentru acest tip de sarcină.

„Muralul cu Nicole Kidman”, ușor indecent, arată că modelul folosit aici, bazat probabil pe difuzie, nu are restricția sistematică pe care o avea DALL-E 2 de a refuza randarea unor chipuri realiste sau a unor imagini provocatoare, în timp ce rezultatele încercărilor de a evoca opere protejate prin drepturi de autor variază de la ambiguu („xenomorf”) la absurd („tronul de fier”). În dreapta jos, imaginea originală.
Ar fi interesant de aflat ce metode folosește Erase and Replace pentru a izola obiectele pe care le poate înlocui. Probabil că imaginea este procesată cu o variantă a CLIP, obiectele distincte fiind identificate prin recunoașterea obiectelor și apoi delimitate prin segmentare semantică. Niciuna dintre aceste operații nu funcționează nici pe departe la fel de bine într-o instalare obișnuită de Stable Diffusion.
Dar nimic nu este perfect: uneori, sistemul pare să șteargă obiectul fără să-l înlocuiască, chiar și atunci când, așa cum am văzut în imaginea de mai sus, mecanismul de randare din fundal înțelege cu siguranță ce înseamnă o solicitare text. În acest caz, este imposibil să transformi o măsuță de cafea într-un xenomorf — în schimb, măsuța pur și simplu dispare.
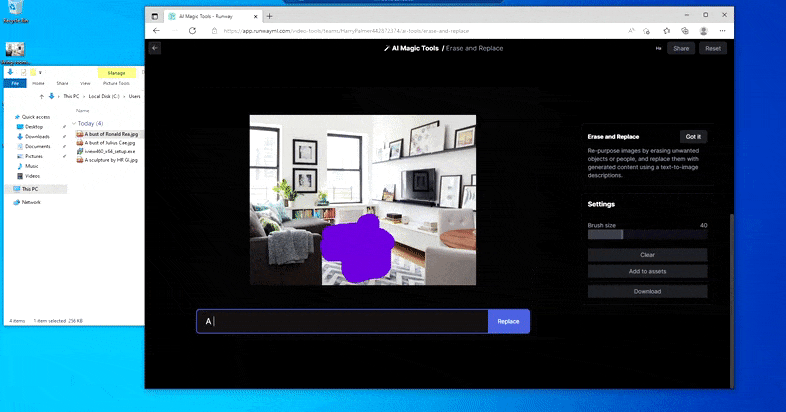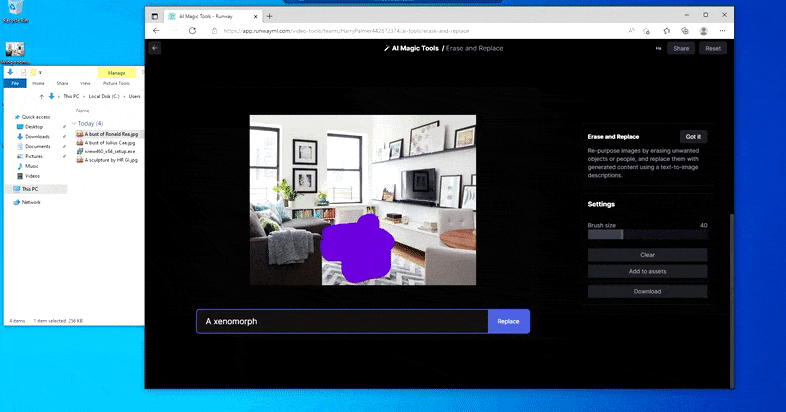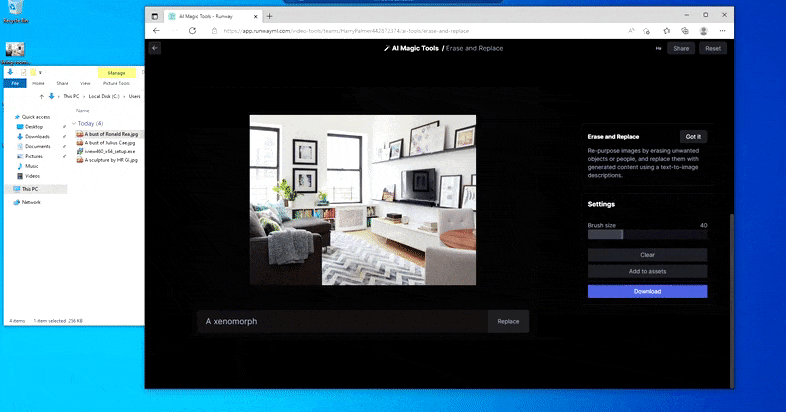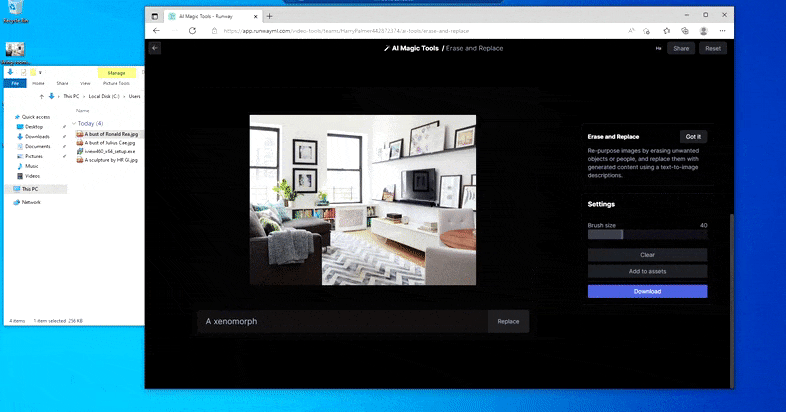
O versiune mai înfricoșătoare a jocului „Unde-i Waldo?”, în care Erase and Replace nu reușește să genereze un extraterestru.
Erase and Replace pare să fie un sistem eficient de înlocuire a obiectelor, cu rezultate excelente la completarea zonelor mascate. Totuși, nu poate edita obiectele existente, așa cum sunt percepute, ci doar le poate înlocui. Modificarea efectivă a conținutului existent al unei imagini, fără a compromite elementele din jur, este, probabil, o sarcină mult mai dificilă, strâns legată de îndelungata luptă din domeniul cercetării în viziune computerizată pentru separarea reprezentărilor în diversele spații latente ale cadrelor populare.
Imagic
Aceasta este sarcina pe care și-o propune Imagic. Noul articol de cercetare prezintă numeroase exemple de editări care modifică cu succes anumite aspecte ale unei fotografii, lăsând restul imaginii neatins.

În Imagic, imaginile modificate nu prezintă întinderile, distorsiunile și „ghicirea zonelor ocluzionate” caracteristice manipulării imaginilor deepfake ca pe niște marionete, care se bazează pe informații anterioare limitate, derivate dintr-o singură imagine.
Sistemul folosește un proces în trei etape: optimizarea reprezentării textului, ajustarea fină a modelului și, în cele din urmă, generarea imaginii modificate.

Imagic codifică solicitarea textului țintă pentru a obține reprezentarea inițială a textului, apoi optimizează rezultatul astfel încât să corespundă imaginii de intrare. După aceea, modelul generativ este ajustat fin pe baza imaginii-sursă, prin adăugarea unei serii de parametri, înainte de a fi supus interpolării solicitate.
În mod previzibil, cadrul tehnologic se bazează pe arhitectura text-video Imagen de la Google, deși cercetătorii afirmă că principiile sistemului se pot aplica, în general, modelelor de difuzie latentă.
Imagen folosește o arhitectură cu trei niveluri, în locul structurii cu șapte niveluri utilizate în versiunea mai recentă a software-ului companiei pentru generarea de videoclipuri din text. Cele trei module distincte cuprind un model generativ de difuzie care operează la o rezoluție de 64x64px; un model de super-rezoluție care mărește această ieșire la 256x256px; și un model suplimentar de super-rezoluție, care mărește ieșirea până la rezoluția de 1024×1024.
Imagic intervine în cea mai timpurie etapă a acestui proces, optimizând reprezentarea textului solicitat la etapa de 64px cu ajutorul unui optimizator Adam, la o rată de învățare statică de 0.0001.

O demonstrație remarcabilă a separării reprezentărilor: utilizatorii finali care au încercat să schimbe ceva atât de simplu precum culoarea unui obiect randat într-un model de difuzie, GAN sau NeRF știu cât de important este faptul că Imagic poate efectua astfel de transformări fără să „destrame” coerența restului imaginii.
Apoi, modelul de bază Imagen este ajustat fin timp de 1500 de pași pentru fiecare imagine de intrare, folosind ca factor de condiționare reprezentarea numerică revizuită. În același timp, stratul secundar 64px>256px este optimizat în paralel pe imaginea condiționată. Cercetătorii observă că o optimizare similară pentru stratul final 256px>1024px are „efecte minime sau inexistente” asupra rezultatelor finale și, prin urmare, nu au implementat-o.
Articolul afirmă că procesul de optimizare durează aproximativ opt minute pentru fiecare imagine, pe două cipuri TPUV4. Randarea finală are loc în nucleul Imagen, folosind schema de eșantionare DDIM.
Ca și în cazul proceselor similare de ajustare fină pentru DreamBooth de la Google, reprezentările numerice obținute pot fi folosite și pentru stilizare, precum și pentru editări fotorealiste care includ informații extrase din baza de date extinsă care stă la baza Imagen (deoarece, după cum arată prima coloană de mai jos, imaginile-sursă nu conțin niciunul dintre elementele necesare pentru a realiza aceste transformări).

Cu Imagic se pot obține mișcări și editări fotorealiste flexibile, iar codurile derivate și separate în reprezentări independente obținute în acest proces pot fi folosite la fel de ușor pentru rezultate stilizate.
Cercetătorii au comparat Imagic cu lucrări anterioare: SDEdit, o abordare bazată pe GAN din 2021, realizată în colaborare de Universitatea Stanford și Universitatea Carnegie Mellon; și Text2Live, o colaborare din aprilie 2022 între Institutul de Știință Weizmann și NVIDIA.

O comparație vizuală între Imagic, SDEdit și Text2Live.
Este clar că metodele anterioare întâmpină dificultăți, însă, în rândul de jos, care presupune introducerea unei schimbări majore de postură, metodele existente nu reușesc deloc să remodeleze materialul-sursă, spre deosebire de Imagic, care obține un rezultat remarcabil.
Deși necesarul de resurse al Imagic și timpul de antrenare pentru fiecare imagine sunt reduse în comparație cu cele obișnuite în astfel de proiecte, este puțin probabil ca tehnologia să fie inclusă într-o aplicație locală de editare a imaginilor pentru calculatoare personale; nici nu este clar în ce măsură procesul de ajustare fină ar putea fi redus pentru a se încadra în limitele accesibile consumatorilor.
În forma actuală, Imagic este o soluție impresionantă, mai potrivită pentru API-uri — un mediu cu care Google Research, precaut în fața criticilor legate de facilitarea creării de deepfake-uri, s-ar putea simți oricum cel mai confortabil.
Publicat pentru prima dată la 18 octombrie 2022.


