
Fundamentele AI
Modele generative vs. discriminative în învățarea automată

 Adaugă Unite.AI la sursele tale preferate pe Google
Generative și discriminative descriu ce învață un model despre date și ținte. În clasificarea supervizată clasică, un model generativ învață o distribuție comună, cum ar fi P(x, y) sau distribuția condiționată pe clasă P(x|y), în timp ce un model discriminativ învață P(y|x) sau o frontieră de decizie directă.
Distincția este utilă, dar sistemele moderne combină adesea obiectivele. Un model poate învăța reprezentări generative și apoi să fie ajustat fin pentru predicție discriminativă, sau poate împărți un nucleu comun între generare și clasificare.
Aspecte cheie
- Clasificatorii generativi modelează modul în care apar intrările și etichetele; clasificatorii discriminativi modelează eticheta dată intrării sau o frontieră.
- Presupunerile generative pot ajuta în cazul datelor etichetate limitate, dar pot fi și incorecte.
- Metodele discriminative se concentrează adesea pe sarcina de predicție și pot atinge o eroare de clasificare asimptotică mai bună.
- GAN‑urile, VAE‑urile și modelele de limbaj sunt sisteme generative, dar „generativ” nu înseamnă că fiecare componentă este un clasificator generativ.
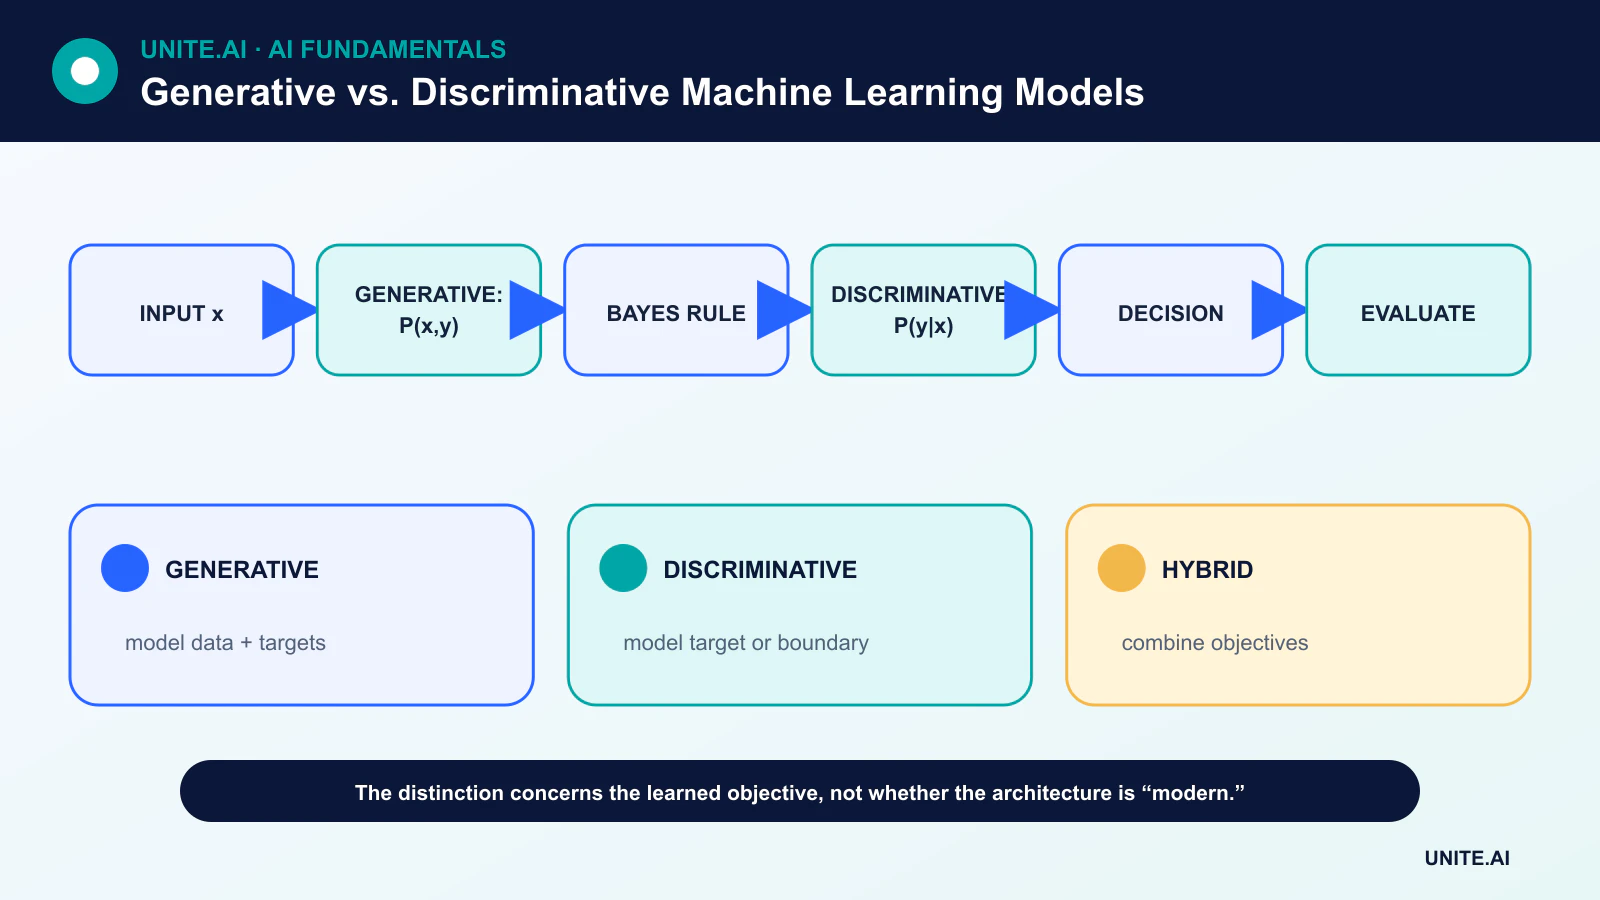
Factorizarea probabilistică
Un clasificator generativ poate estima P(x|y) și P(y), apoi folosește teorema lui Bayes pentru a deduce P(y|x). Naive Bayes este un exemplu clasic. Un clasificator discriminativ, cum ar fi regresia logistică, estimează direct P(y|x); un SVM învață o frontieră de separare.
Modelarea lui P(x,y) este o sarcină mai largă decât prezicerea lui y din x. Această structură suplimentară poate susține eșantionarea sau raționamentul cu date lipsă, dar necesită și presupuneri despre distribuția intrărilor.
Eficiența datelor și comportamentul asimptotic
Compararea realizată de Ng și Jordan între Naive Bayes și regresia logistică a arătat un compromis util: în condițiile lor, modelul generativ poate atinge performanța limită cu mai puține exemple, în timp ce modelul discriminativ poate ajunge la o eroare asimptotică mai mică.
Acesta nu este un clasament universal. Rezultatele depind de potrivirea familiei de modele cu datele, de dimensiune, de regularizare, de optimizare și de calitatea etichetelor. O comparație empirică pe un design de validare reprezentativ rămâne esențială.
Familii de modele reprezentative
Modelele generative includ distribuții condiționate pe clasă, modele Markov ascunse, modele de amestec, autoencodere variationale, modele de limbaj autoregresive, modele de difuzie și GAN‑uri.
Modelele discriminative includ regresia logistică, arbori de decizie, câmpuri aleatorii condiționate, mașini cu vectori de susținere și clasificatori neuronali. Același nucleu neuronal poate participa în oricare dintre categorii în funcție de obiectivul de antrenament și de ieșire.
Sisteme hibride și auto‑supervizate
Un model de limbaj sau de vedere pre‑antrenat poate învăța din date neetichetate cu un obiectiv generativ sau auto‑supervizat, apoi poate primi o „cap” discriminativ pentru sarcina țintă. Metodele semi‑supervizate pot optimiza simultan clasificarea etichetată și un obiectiv pentru date neetichetate.
Hibridizarea face ca etichetele arhitecturii să fie mai puțin informative decât întregul pipeline de antrenament. Documentația ar trebui să indice obiectivul, datele, ieșirile și inferența dorită – nu doar să numească modelul „generativ”.
Alegerea între abordări
Folosiți sarcina pentru a decide. Dacă scopul este o frontieră calibrată cu etichete abundente, un model discriminativ este o bază naturală. Dacă eșantionarea, estimarea densității, structura datelor lipsă sau datele neetichetate sunt esențiale, un component generativ poate ajuta.
Comparați robustețea, eficiența eșantionării, costul computațional, verosimilitatea sau calibrul, după caz. Un eșantion generat bun nu dovedește un bun clasificator, iar un clasificator cu acuratețe ridicată nu implică un model realist al distribuției de intrare.
Direcții de probabilitate și obiective de modelare
Un model discriminativ învață o frontieră sau o distribuție condiționată P(y|x): date caracteristicile x, prezice eticheta y. Regresia logistică, mașinile cu vectori de susținere, câmpurile aleatorii condiționate și mulți alți clasificatori sunt discriminativi. Un model generativ învață o distribuție comună P(x,y), o distribuție condiționată pe clasă P(x|y) sau o distribuție de date necondiționată, permițând eșantionarea sau sarcini legate de verosimilitate. Naive Bayes și analiza discriminantă liniară sunt clasificatori generativi; GAN‑urile, autoencoderele variationale, modelele de difuzie și cele autoregresive generează date prin obiective diferite.
Distincția se referă la ce distribuție sau regulă de decizie este modelată, nu la utilizarea unei rețele neuronale. Un model de limbaj generativ poate fi solicitat să clasifice, în timp ce un re‑ranker discriminativ poate ghida generarea. Presupunerile generative pot îmbunătăți eficiența datelor sau pot gestiona variabile lipsă, dar introduc riscul de specificare greșită a modelului. Metodele discriminative excelează adesea cu date etichetate abundente, deoarece se concentrează direct pe frontieră. Comparați familiile sub condiții egale de caracteristici, date, reglare și calcul, în loc să tratați o categorie ca superioară universal.
Antrenarea și evaluarea în funcție de caz de utilizare
Evaluarea clasificării folosește precizia, recall‑ul, calibrul, robustețea și costul erorii. Evaluarea generativă trebuie să abordeze fidelitatea, diversitatea, acoperirea, verosimilitatea sau utilitatea sarcinii, memorarea și siguranța. Un model poate produce eșantioane atrăgătoare în timp ce pierde moduri, sau poate obține o verosimilitate bună cu un rezultat perceptual slab. Utilitatea datelor sintetice ar trebui testată prin antrenarea și evaluarea modelelor ulterioare pe date reale independente, inclusiv grupuri rare. Păstrați datele de test în afara prompturilor de generare și a selecției.
În învățarea semi‑supervizată, un model generativ poate exploata structura neetichetată; în detectarea anomaliilor, verosimilitatea poate eșua când datele din afara distribuției primesc o densitate ridicată din motive irelevante. În generarea augmentată prin recuperare, un model de răspuns generativ și un recuperator sau re‑ranker discriminativ formează un hibrid. Diagnosticați etapele separat pentru ca ieșirea fluentă să nu ascundă eșecul de recuperare. Alegeți descompunerea care face dovezile și controlul observabile.
Implementare și guvernanță
Sistemele generative adaugă riscuri de proveniență a conținutului, proprietate intelectuală, impersonare, injecție de prompt și moderare a ieșirii; sistemele discriminative adaugă riscuri de prag, refuz și erori inegale. Ambele necesită drepturi asupra datelor, artefacte securizate, versionare, teste reprezentative, monitorizare și autoritate umană proporțională cu consecințele. Înregistrați obiectivul precis și semantica ieșirii în documentație. Generativ versus discriminativ este o distincție statistică utilă, dar sistemele reale le combină frecvent, iar fiabilitatea depinde de întregul pipeline de date și decizii.
Exemplu practic: clasificarea și generarea răspunsurilor de suport
O platformă de suport folosește un clasificator discriminativ pentru a identifica tipul problemei și urgența și un model generativ pentru a redacta un răspuns pe baza politicilor aprobate. Clasificatorul este evaluat cu recall specific clasei și calibrul; recuperatorul cu recall al dovezilor; generatorul cu fundamentare, corectitudine și refuz. Fiecare etapă are un rezultat necunoscut, iar modelul generativ nu poate modifica clasificarea sau dreptul clientului prin text persuasiv.
Operatorii văd ruta prezisă, sursele și schița și aprobă sau corectează înainte de trimitere. Filtrele de permisiune se aplică înainte de recuperare, iar injecția de prompt în textul clientului nu poate autoriza instrumente. Monitorizarea separă erorile de rutare, golurile de recuperare, afirmațiile nesusținute și editările operatorilor. O modificare a politicii actualizează sursele imediat și declanșează teste de regresie; reglarea este rezervată pentru comportament stabil. Designul hibrid folosește punctele forte discriminative și generative, păstrând dovezile și autoritatea umană.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație reușită. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o bază reproducibilă și un set de evaluare versionat înainte de reglare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi de dependență, utilizări greșite și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag pentru ca un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru lansare, excepții, modificări, revenire și retragere. Utilizați o implementare etapizată, păstrați un fallback sigur și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevalueați ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se modifică. Un sistem menținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și retenție, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Este discriminatorul unui GAN un model discriminativ?
Acesta efectuează discriminare în timpul antrenamentului, dar GAN‑ul în ansamblu este un cadru generativ al cărui output este produs de generator.
Învățarea discriminativă este întotdeauna supervizată?
Nu. Termenul descrie relația sau frontiera modelată, în timp ce supervizarea descrie semnalul de antrenament. Obiectivele moderne pot estompa categoriile.
Referințe principale












