
Interviuri
Denise Muyco, cofondatoare și directoare generală a RAVEL – Seria de interviuri

 Adaugă Unite.AI la sursele tale preferate pe Google
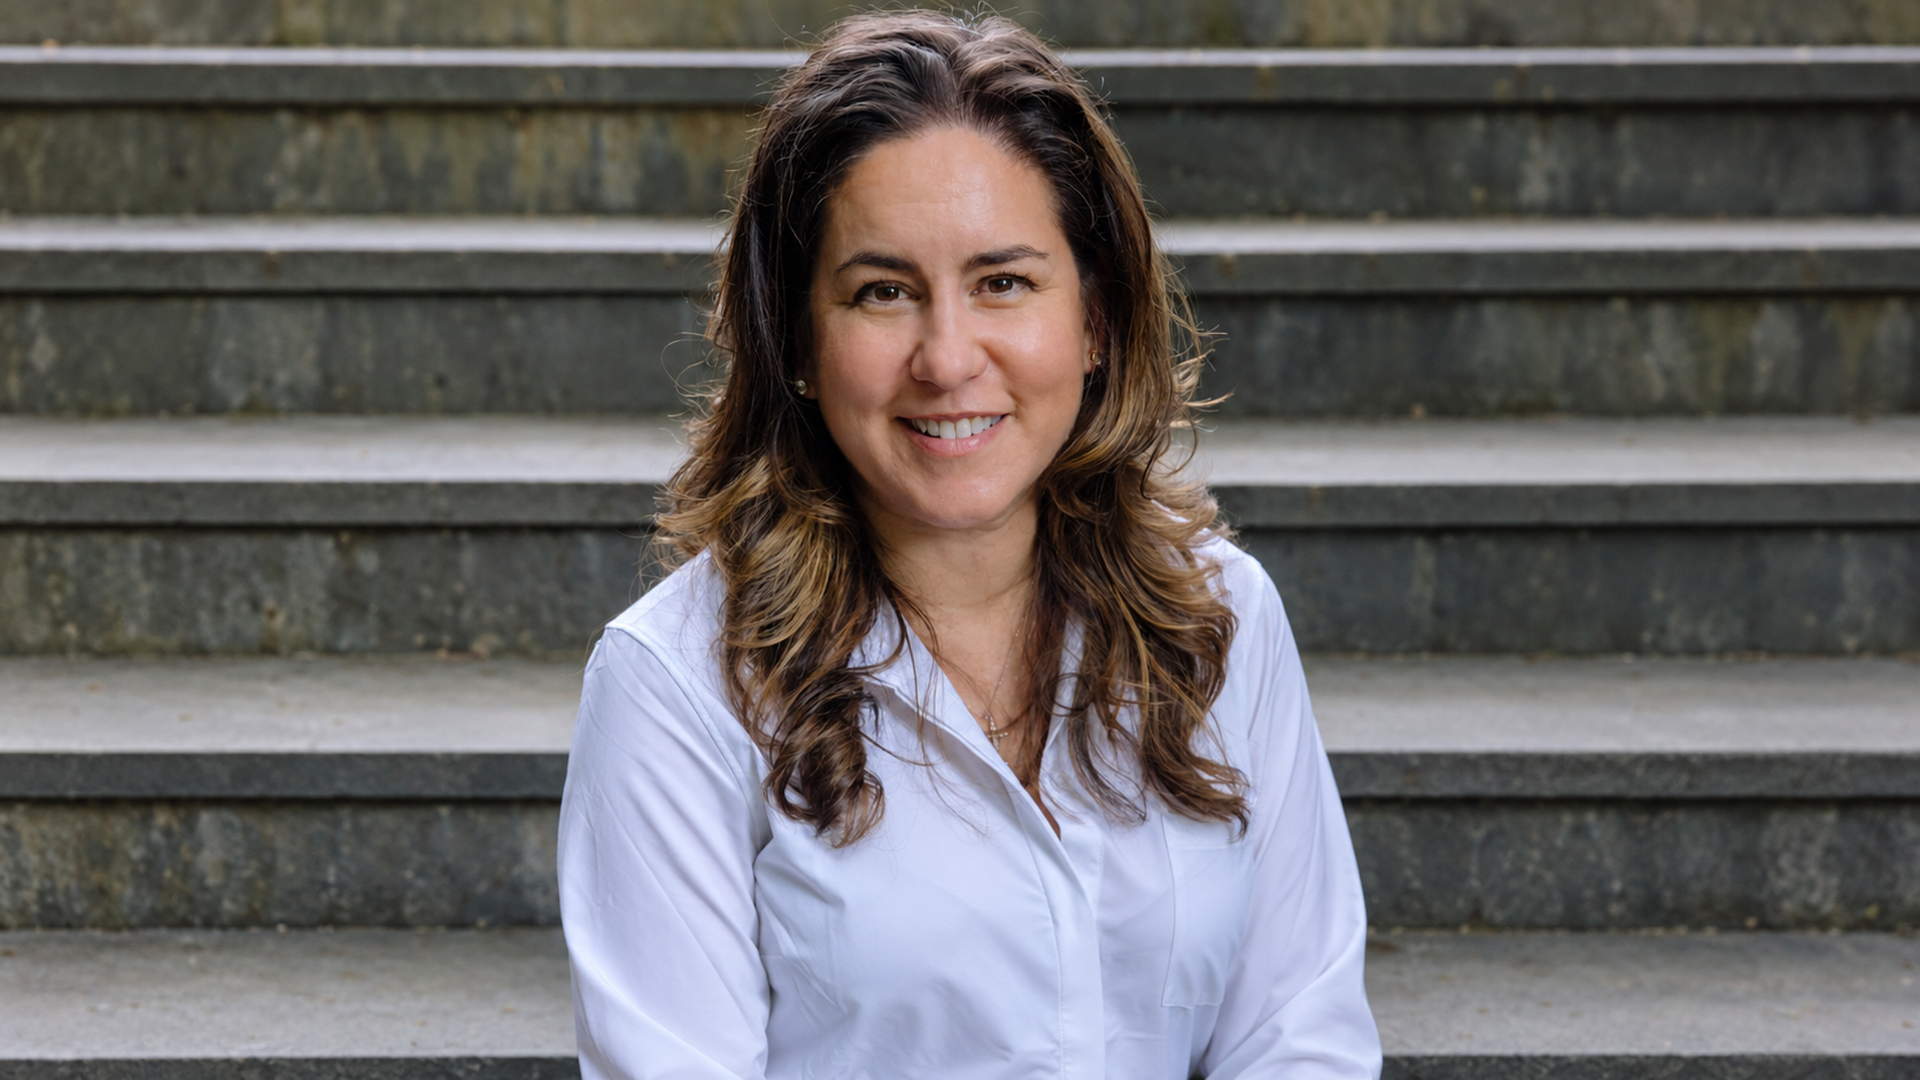
Denise Muyco este cofondatoarea și directoarea generală a RAVEL, unde coordonează dezvoltarea de software de orchestrare pentru infrastructuri complexe de calcul și inteligență artificială. Ingineră de formație, și-a desfășurat cariera în domeniul infrastructurii energetice, al optimizării proceselor, al mediilor digitale, al centrelor de date și al studiourilor virtuale. Înainte să se concentreze asupra inteligenței artificiale, a contribuit la dezvoltarea unei infrastructuri comune de calcul de înaltă performanță pentru comunitatea de efecte vizuale din Vancouver, oferind acces la resurse de calcul și conectivitate securizată pentru aproximativ 30 de studiouri. Această experiență i-a modelat abordarea în ceea ce privește coordonarea resurselor costisitoare și limitate. La RAVEL, aplică o perspectivă de inginerie a sistemelor în gestionarea plasării sarcinilor de lucru, utilizării infrastructurii și interoperabilității, precum și a cerințelor tot mai mari ale mediilor distribuite și suverane de inteligență artificială.
RAVEL dezvoltă software care ajută organizațiile să implementeze, să gestioneze și să extindă sarcini de lucru de calcul și inteligență artificială în infrastructuri cloud, locale și hibride. Produsele sale includ RAVEL Orchestrate pentru stații de lucru virtuale de înaltă performanță, RAVEL Orchestrate AI pentru automatizarea și optimizarea sarcinilor de lucru și Boost pentru licențierea software-ului și telemetrie. Instrumentele companiei conectează infrastructura, aplicațiile, virtualizarea și securitatea, oferind totodată controale centralizate și vizibilitate operațională. RAVEL deservește centre de date, furnizori de servicii, echipe IT din companii, grupuri de cercetare în domeniul inteligenței artificiale și studiouri creative. Bazându-se pe rădăcinile sale din domeniul creării de conținut digital, compania urmărește să simplifice mediile complexe și să ajute echipele să folosească mai eficient infrastructura de care dispun.
Ai fondat RAVEL după ani de activitate la intersecția dintre inginerie, infrastructura media și calculul distribuit. Ce te-a determinat, în cele din urmă, să înființezi compania și cum a evoluat misiunea RAVEL pe măsură ce inteligența artificială generativă a crescut dramatic cererea de resurse de calcul?
Sunt ingineră de formație și am lucrat la intersecția dintre energie, calcul și infrastructură cu mult înainte de boomul actual al inteligenței artificiale. La începutul carierei, am făcut un stagiu la o centrală nucleară, iar mai târziu, activitatea mea din domeniul media și al efectelor vizuale mi-a oferit ocazia să lucrez cu GPU-uri, să mă confrunt cu cerințe mari de calcul și să văd limitele infrastructurii fizice.
În urmă cu aproximativ 16 ani, industria efectelor vizuale din Vancouver, aflată în plină dezvoltare, se confrunta direct cu aceste constrângeri. Studiourile aveau nevoie de volume enorme de resurse de calcul de înaltă performanță pentru a procesa (sau a randa) conținut cinematografic și de televiziune tot mai complex, destinat unor proiecte cu miză ridicată, însă puține își puteau justifica investiția în suficientă infrastructură dedicată pentru a acoperi cererea maximă într-un mediu securizat. Energia devenea, de asemenea, o constrângere. Am dezvoltat o infrastructură comună care le-a oferit aproximativ 30 de studiouri acces la calcul de înaltă performanță și la conectivitate securizată, cu lățime de bandă mare.
Partajarea infrastructurii a rezolvat o problemă, dar a creat alta: cum poți aloca eficient resurse costisitoare și limitate între organizații și sarcini de lucru? Această experiență a dus, în cele din urmă, la abordarea RAVEL privind orchestrarea inteligentă a infrastructurii.
Inteligența artificială reprezintă o versiune mult mai amplă a aceleiași provocări fundamentale, cu o complexitate și un capital mult mai mari în joc. Sarcinile de lucru și infrastructura s-au schimbat, însă nevoia de a face ca resursele costisitoare și limitate să funcționeze eficient împreună a devenit și mai importantă.
Înainte de RAVEL, ai contribuit la crearea unui consorțiu format din aproximativ 30 de studiouri, scene de filmare, companii de producție și case de efecte vizuale din Vancouver, care puteau partaja accesul la infrastructura de calcul de înaltă performanță. Ce te-a învățat această experiență despre calculul distribuit și ce paralele vezi între provocările de atunci ale randării la Hollywood și provocările actuale ale industriei inteligenței artificiale în materie de infrastructură?
Activitatea mea în industria efectelor vizuale m-a învățat că dezvoltarea și configurarea infrastructurii reprezentau doar jumătate din problemă. Resursele de calcul costisitoare trebuiau partajate în siguranță și folosite eficient, iar infrastructura mai largă — inclusiv o rețea securizată, capabilă să transfere fișiere uriașe — trebuia să funcționeze ca un tot unitar. Sarcinile de lucru trebuiau programate, capacitatea trebuia alocată, iar volume enorme de date trebuiau transferate, în timp ce echipele de producție urmăreau să obțină rezultate tot mai ambițioase, respectând bugete și termene stricte. Infrastructura trebuia optimizată continuu pentru a-i îmbunătăți gradul de utilizare și performanța.
Inteligența artificială reprezintă o versiune mult mai amplă a aceleiași provocări fundamentale. Organizațiile investesc masiv în infrastructură, însă simpla creștere a capacității nu garantează utilizarea eficientă a resurselor costisitoare. Infrastructura de inteligență artificială devine, de asemenea, tot mai distribuită între locații, furnizori și medii, ca urmare a cerințelor legate de energie, capacitate, securitate, economie, geografie, reglementare și suveranitate. Randarea și inteligența artificială pot presupune sarcini de lucru foarte diferite, dar au în comun o provocare importantă la nivelul infrastructurii și al ecosistemului: ambele depind de funcționarea eficientă, împreună, a resurselor de calcul de înaltă performanță, a rețelelor, a securității și a stocării.
Pe măsură ce infrastructura de inteligență artificială devine mai complexă, simpla adăugare de resurse de calcul nu rezolvă provocarea operațională de a folosi eficient capacitatea disponibilă. Aici devin esențiale orchestrarea și politicile care guvernează ecosistemul mai larg al infrastructurii. Împreună, acestea ajută organizațiile să utilizeze mai bine resursele costisitoare și limitate, coordonând totodată sarcinile de lucru în medii din ce în ce mai distribuite.
RAVEL se descrie drept un strat de orchestrare pentru fabrici AI distribuite. Ce înseamnă pentru dumneavoastră o „fabrică AI” și ce lipsește astăzi din stiva de infrastructură, făcând necesar un strat de orchestrare?
Din perspectiva mea, o fabrică AI înseamnă mai mult decât GPU-uri și clustere de înaltă performanță; este un ecosistem integrat de infrastructură, care reunește resurse de calcul, rețelistică, stocare, securitate, energie, răcire și straturile operaționale necesare pentru rularea sarcinilor de lucru AI. Fabricile AI evoluează de la clustere izolate la ecosisteme de resurse interconectate, extinse în mai multe locații și regiuni. Această complexitate devine tot mai dificil de gestionat manual sau cu soluții punctuale disparate. Un strat de orchestrare răspunde acestei provocări coordonând componentele diverse și complexe ale stivei și abstractizând o parte din complexitatea de bază, ceea ce le ușurează operatorilor gestionarea infrastructurii ca sistem coordonat.
Pe măsură ce organizațiile își adaptează centrele de date existente pentru AI, multe dintre aceste facilități nu au fost proiectate inițial pentru cerințele sarcinilor de lucru AI de astăzi. În prezent, AI se confruntă cu o nepotrivire structurală, care se manifestă prin trei probleme principale. Prima este energia: găsirea unei locații cu suficientă energie fiabilă pentru a rula sarcini de lucru la scară largă. A doua este fragmentarea ecosistemului, deoarece stivele AI sunt adesea împărțite între medii izolate și nu sunt proiectate să funcționeze împreună. A treia este vizibilitatea limitată asupra costului total de operare și de deținere, care poate ascunde costul real al infrastructurii AI. Drept urmare, sarcinile de lucru pot rămâne neoptimizate, hardware-ul poate fi utilizat insuficient, iar costurile operaționale neprevăzute pot majora costul total de deținere, contribuind, în cele din urmă, la creșterea costurilor per token.
Infrastructura AI este tot mai răspândită în clouduri hyperscale, centre de date private, sisteme instalate local și rețele de furnizori specializați de GPU-uri. Care sunt cele mai mari provocări cu care se confruntă organizațiile atunci când încearcă să gestioneze sarcini de lucru AI în aceste medii diferite?
În ultimii câțiva ani, cursa pentru infrastructura AI a fost definită de o presupunere simplă: să construim mai mult. Centre de date mai mari. Clustere mai mari. Mai multe GPU-uri. Mai multă capacitate. Însă modelul „să construim mai mult” se lovește tot mai des de constrângeri fizice, economice și de reglementare.
Energia este limitată. Accesul la rețeaua electrică necesită timp. Factorii economici, geografici și de suveranitate dictează tot mai mult unde poate și ar trebui construită infrastructura. Noua provocare nu constă doar în a construi mai multă infrastructură AI, ci în a construi infrastructura potrivită în locurile potrivite și în a face ca toate aceste medii să funcționeze ca un sistem coordonat. Acest lucru devine deosebit de dificil atunci când capacitatea este distribuită între clouduri hyperscale, centre de date private, infrastructură instalată la sediu și furnizori specializați, care nu au fost neapărat proiectați să funcționeze împreună.
Energia este cea mai stringentă dintre aceste constrângeri. Disponibilitatea energiei determină tot mai mult unde este construită infrastructura AI, încă de la început.
Aici devine esențială federarea. Aceasta conectează infrastructura din diferite medii într-un mediu operațional comun. Orchestrarea inteligentă stabilește apoi unde ar trebui rulate sarcinile de lucru, în funcție de capacitate, energie, performanță, cost, politici, reziliență și suveranitate.
Pe măsură ce infrastructura AI se extinde, fie în mai multe locații, fie la mai mulți furnizori, avantajul competitiv nu va veni pur și simplu din deținerea unei capacități mai mari. Va veni din capacitatea de a face ca toate aceste resurse să funcționeze împreună. Federarea oferă modelul de infrastructură adecvat acestei noi realități, iar orchestrarea inteligentă permite funcționarea acestui model la scară largă.
Acesta este modelul pe care îl urmărește unul dintre clienții noștri, RT-One, dezvoltatorul celor mai mari parcuri tehnologice AI și centre de date din America Latină, în timp ce planifică o infrastructură federată în Americi: conectarea capacității distribuite, astfel încât aceasta să poată fi gestionată, în cele din urmă, ca un mediu coordonat.
Lipsa GPU-urilor a primit multă atenție, însă simpla adăugare a mai multor acceleratoare nu se traduce neapărat într-o capacitate de calcul AI mai mare și mai utilă. Unde vedeți cele mai mari surse de ineficiență în infrastructura AI de astăzi și câtă capacitate suplimentară ar putea debloca firmele printr-o orchestrare mai bună?
Cursa pentru infrastructura AI s-a concentrat în mare măsură pe numărul de gigawați de capacitate nouă planificați și pe capitalul alocat construirii acesteia. Este tentant să considerăm că problema infrastructurii AI se reduce la o penurie de GPU-uri sau de capacitate, însă această perspectivă nu surprinde unde se află, de fapt, ineficiența. Este important de reținut că o capacitate planificată nu este același lucru cu o capacitate utilizabilă.
Clusterele de GPU-uri pot părea ocupate la capacitate maximă, însă GPU-urile costisitoare pot rămâne nefolosite atunci când apar blocaje de performanță în alte componente ale stivei. Printre acestea se numără debitul sistemelor de stocare, fluxurile de date, congestia rețelei, ineficiențele în programarea sarcinilor, cerințele de securitate și neconcordanțele dintre arhitectură, aplicații, drivere și dependențe. Adăugarea de GPU-uri nu se traduce întotdeauna într-o capacitate de calcul utilizabilă mai mare.
Adăugarea unei cantități mai mari de infrastructură nu sporește automat eficiența. În multe cazuri, creează mai multe silozuri și, totodată, majorează costurile.
Organizațiile au nevoie de mai multă vizibilitate și control pentru a îmbunătăți gradul de utilizare a resurselor, a automatiza deciziile privind infrastructura și a alinia mai bine sarcinile de lucru la resursele disponibile și la prioritățile de business. O vizibilitate și un control mai bune pot transforma un ansamblu de resurse de infrastructură într-un mediu operațional mai bine coordonat. Nu există o valoare exactă sau universală care să indice câtă capacitate ar putea fi deblocată prin orchestrare; fiecare sarcină de lucru are cerințe specifice. Un lucru este însă clar: soluția pentru capacitatea neutilizată sau insuficient utilizată nu constă pur și simplu în a cumpăra sau a construi mai mult.
RAVEL a pus accentul pe interoperabilitatea dintre infrastructură, tehnologiile de virtualizare, sistemele de gestionare a identității și aplicații. De ce devine interoperabilitatea deosebit de importantă pe măsură ce sarcinile de lucru de inteligență artificială devin mai complexe și mai distribuite?
Pe măsură ce infrastructura devine mai eterogenă, organizațiile au nevoie de flexibilitatea de a utiliza tehnologii și medii diferite fără a crea noi silozuri de infrastructură izolate. Interoperabilitatea permite componentelor de calcul, stocare și rețea, precum și aplicațiilor provenite de la furnizori și din medii diferite, să funcționeze împreună, păstrând libertatea de alegere pe măsură ce infrastructura evoluează. Interoperabilitatea, de una singură, nu stabilește însă cum ar trebui utilizate aceste resurse.
Aici intervine orchestrarea — coordonarea locului în care rulează sarcinile de lucru, a modului în care se deplasează și a aplicării politicilor în diferite medii. Pe măsură ce infrastructura pentru inteligența artificială devine tot mai distribuită și federată, interoperabilitatea oferă flexibilitatea de a opera cu tehnologii diferite, iar orchestrarea transformă aceste resurse într-un mediu operațional coordonat.
RAVEL Orchestrate AI oferă un nivel comun de orchestrare pentru tehnologiile de calcul, stocare, rețea și alte tehnologii de infrastructură, coordonând sarcinile de lucru de inteligență artificială în medii cloud, locale și hibride.
Suveranitatea datelor devine un considerent major pentru guvernele și companiile care implementează soluții de inteligență artificială. Cum schimbă dezvoltarea infrastructurii suverane pentru inteligența artificială modul în care organizațiile trebuie să abordeze plasarea sarcinilor de lucru, transferul datelor, securitatea și orchestrarea?
Inteligența artificială suverană este acum o prioritate strategică. Odată cu ea apare o întrebare mai fundamentală: ce înseamnă, de fapt, să fii suveran? Discuțiile s-au concentrat în mare măsură asupra rezidenței datelor, dar consider că această definiție este prea limitată.
Definesc inteligența artificială suverană drept capacitatea unei națiuni, a unei companii, a unei agenții guvernamentale sau a unei alte organizații de a menține controlul asupra sarcinilor sale de lucru de inteligență artificială, control definit prin politici și care include datele, modelele, infrastructura de calcul, accesul, securitatea, operațiunile și jurisdicția care le guvernează. Suveranitatea nu înseamnă neapărat că fiecare sarcină de lucru trebuie să rămână într-un singur centru de date sau chiar pe o infrastructură deținută de o singură organizație. Înseamnă, mai degrabă, că organizația stabilește unde este permis să ruleze o sarcină de lucru, unde pot fi stocate sau transferate datele acesteia, cine le poate accesa, ce infrastructură o poate executa și ce politici de securitate, reglementare, geografice, operaționale și de business trebuie respectate în permanență. Această definiție centrată pe sarcinile de lucru se înscrie în tendința mai amplă din industrie de a considera suveranitatea drept control asupra întregului mediu de inteligență artificială, nu doar asupra rezidenței datelor.
Abordarea RAVEL se distinge în mod deosebit la intersecția dintre inteligența artificială suverană și federație. RAVEL Orchestrate AI poate trata cerințele de suveranitate drept constrângeri la nivelul orchestrației și al politicilor: o sarcină de lucru poate fi eligibilă să ruleze într-o federație de locații, medii cloud, centre de date, locații edge sau alte infrastructuri, dar numai pe resurse care respectă politicile de suveranitate aplicabile sarcinii respective. În limitele aprobate, RAVEL poate apoi determina infrastructura potrivită în funcție de factori precum consumul de energie, costul, performanța, capacitatea, gradul de utilizare, caracteristicile rețelei, locația și prioritatea. Federația nu elimină suveranitatea; dimpotrivă, poate funcționa în limitele stabilite de aceasta. De exemplu, o sarcină de lucru guvernamentală sensibilă ar putea rămâne în întregime în unități din SUA aprobate, fiind totodată orchestrată dinamic între mai multe locații autorizate. Rezultatul este un model care le permite organizațiilor să beneficieze de avantajele de utilizare și reziliență ale infrastructurii distribuite pentru inteligența artificială, fără a pierde controlul asupra locului și modului în care funcționează cele mai sensibile sarcini de lucru.
RAVEL a luat naștere în industrii precum media, divertismentul, jocurile video și designul, unde sarcinile de lucru pot necesita resurse de calcul extrem de mari. Cum au schimbat cerințele inteligenței artificiale generative platforma, în comparație cu provocările de infrastructură pe care încercați inițial să le rezolvați pentru profesioniștii din domeniile creative?
RAVEL a apărut pentru a rezolva probleme de infrastructură cu care se confruntau artiștii și inginerii, care executau deja sarcini masive de randare, simulare și creare de conținut, folosind resurse costisitoare de calcul, stocare și rețea. Provocarea fundamentală era să facă infrastructura eterogenă mai ușor de accesat, de partajat și de orchestrată, maximizând în același timp gradul de utilizare și performanța.
Inteligența artificială generativă a amplificat dramatic amploarea și complexitatea aceleiași probleme. În loc să orchestrăm în principal aplicații și sarcini de randare, trebuie acum să ținem cont de modelele, motoarele și agenții de inteligență artificială, de sarcinile de lucru de antrenare și inferență, de diferitele arhitecturi GPU, de stivele software aflate în schimbare rapidă, de transferurile masive de date și de constrângerile mult mai mari legate de consumul de energie, cost, securitate și disponibilitate.
Prin urmare, RAVEL a evoluat de la coordonarea în principal a resurselor de calcul la furnizarea unui nivel inteligent de control și optimizare pentru infrastructura AI. Orchestrate AI folosește telemetria și politicile pentru a stabili nu doar dacă infrastructura este disponibilă, ci și unde și cum ar trebui să ruleze o sarcină de lucru, ținând cont de factori precum costul, viteza, consumul de energie, performanța, gradul de utilizare, locația și cerințele de suveranitate.
Federarea a devenit, de asemenea, tot mai importantă, deoarece infrastructura AI nu mai poate fi tratată ca o colecție de centre de date izolate; organizațiile au nevoie de capacitatea de a utiliza în mod inteligent resursele disponibile în mai multe locații, menținând în același timp guvernanța și securitatea. În multe privințe, AI-ul generativ nu a schimbat problema fundamentală pe care RAVEL și-a propus să o rezolve — a făcut-o mult mai amplă și mai complexă, sporind importanța coordonării, optimizării și federării inteligente.
Cariera ta te-a purtat de la inginerie mecanică și optimizarea proceselor la Starbucks la media digitală, centre de date, studiouri virtuale și, acum, infrastructura AI. Cum ți-a influențat pregătirea inginerească modul în care abordezi construirea companiilor și rezolvarea problemelor de infrastructură?
Pregătirea mea inginerească a influențat, probabil, aproape totul în felul în care construiesc companii. Ingineria mecanică te învață să privești un sistem — nu doar o componentă izolată — și să te întrebi unde sunt constrângerile, unde se irosesc energia sau resursele și cum poate funcționa mai bine întregul sistem. La Starbucks, am aplicat acest mod de gândire la optimizarea proceselor; mai târziu, în media digitală și efectele vizuale, sistemul a ajuns să includă resurse de calcul, stocare, rețelistică, aplicații și, în cele din urmă, centre de date întregi. Tehnologia s-a schimbat, dar modul în care abordam problema, de fapt, nu. Mă întreb mereu: Unde este blocajul? Ce resurse sunt insuficient utilizate? Ce putem simplifica? Și cum putem face întregul sistem să funcționeze mai bine, în loc să optimizăm doar o singură componentă?
Așa am construit, în mare măsură, RAVEL. Nu cred că problema infrastructurii AI se rezumă la obținerea unui număr mai mare de GPU-uri sau la construirea mai multor centre de date. Este o problemă de inginerie a sistemelor, care implică resurse de calcul, energie, stocare, rețelistică, software, sarcini de lucru, oameni și, tot mai mult, geografie și suveranitate. Poți avea cel mai rapid GPU din lume, dar, dacă restul sistemului nu este optimizat, ai creat pur și simplu un blocaj foarte costisitor. De aceea, abordarea noastră la RAVEL este să facem infrastructura însăși mai inteligentă — folosind telemetria, politicile, coordonarea și federarea pentru a stabili în permanență cum și unde ar trebui să ruleze sarcinile de lucru. Mi-am început cariera optimizând sisteme fizice; astăzi aplicăm aceeași rigoare inginerească pentru a optimiza infrastructura care susține AI-ul.
Privind spre viitor, cum crezi că va evolua infrastructura AI pe măsură ce modelele, agenții și aplicațiile vor necesita cantități tot mai mari de resurse de calcul distribuite? Crezi că fabricile AI vor deveni un nivel standard al infrastructurii întreprinderilor, la fel cum s-a întâmplat cu cloud computingul în ultimul deceniu?
Cred cu tărie că fabricile AI vor deveni un nivel fundamental al infrastructurii întreprinderilor, la fel cum s-a întâmplat cu cloud computingul — dar nu cred că vor lua forma unui singur centru de date standardizat sau a unui singur serviciu cloud. Pe măsură ce modelele, agenții și aplicațiile vor consuma cantități tot mai mari de resurse de calcul, întreprinderile vor folosi o combinație eterogenă de GPU-uri, CPU-uri, infrastructură privată, neoclouduri, furnizori de cloud la scară foarte mare, medii edge și sisteme AI specializate.
Disponibilitatea energiei, costul, suveranitatea, performanța și locația vor deveni la fel de importante ca disponibilitatea resurselor de calcul. Adevărata provocare nu va fi doar construirea unei infrastructuri suplimentare, ci și să facem ca toată această infrastructură distribuită să funcționeze ca un singur sistem inteligent. Fabrica AI a viitorului nu va fi o singură clădire — va fi un mediu de infrastructură federat, care va cuprinde resurse de calcul, energie, date și resursele necesare pentru a rula sarcini de lucru AI acolo unde este cel mai potrivit.
Cred că aici se conturează următorul nivel major al infrastructurii. Cloud computingul a abstractizat serverele și a facilitat accesul la resursele de calcul; următorul pas este abstractizarea complexității întregului ansamblu de infrastructură AI. Întreprinderile nu ar trebui să fie nevoite să stabilească manual ce GPU, centru de date, serviciu cloud, sursă de energie sau zonă geografică ar trebui să ruleze fiecare model sau agent. Infrastructura ar trebui să ia tot mai mult aceste decizii în mod autonom, folosind telemetria și politicile pentru a optimiza costul, viteza, consumul de energie, performanța, disponibilitatea și suveranitatea. Acesta este viitorul pe care îl construim la RAVEL: un nivel inteligent de coordonare, care permite sarcinilor de lucru să se deplaseze între componentele unei infrastructuri AI federate, păstrând totodată politicile și mecanismele de control ale organizației. Cloud computingul a făcut ca resursele de calcul să fie disponibile la cerere. Cred că următoarea generație de infrastructură AI va face disponibilă la cerere și optimizarea.
Vă mulțumesc pentru interviul excelent. Cititorii care doresc să afle mai multe despre coordonarea sarcinilor de lucru AI în infrastructuri distribuite pot vizita RAVEL.



