
Prompt engineering
ChatGPT și Ingineria Avansată a Prompturilor: Impulsionează Evoluția Inteligenței Artificiale

 Adaugă Unite.AI la sursele tale preferate pe Google

OpenAI a fost instrumental în dezvoltarea de instrumente revoluționare, cum ar fi OpenAI Gym, destinat antrenării algoritmilor de întărire, și modelele GPT-n. Atenția se îndreaptă și către DALL-E, un model de inteligență artificială care creează imagini din intrări textuale. Un astfel de model care a atras o atenție considerabilă este ChatGPT al OpenAI, un exemplar strălucit în domeniul Modelelor de Limbaj Mare.
GPT-4: Ingineria Prompturilor
ChatGPT a transformat peisajul chatbot-urilor, oferind răspunsuri similare celor umane la intrările utilizatorilor și extinzându-și aplicațiile în diverse domenii – de la dezvoltarea și testarea software-ului la comunicarea în afaceri și chiar crearea de poezie.
În mâinile afacerilor și ale indivizilor, GPT-4, de exemplu, ar putea servi ca o sursă inepuizabilă de cunoștințe, competentă în subiecte care variază de la Matematică și Biologie la Studii Juridice. Astfel de modele de inteligență artificială sofisticate și accesibile sunt pe cale să redefină viitorul muncii, al învățării și al creativității.

Modelele generative, cum ar fi GPT-4, pot produce date noi pe baza intrărilor existente. Această trăsătură distinctivă le permite să efectueze diverse sarcini, inclusiv generarea de text, imagini, muzică și videoclipuri.
În contextul ChatGPT și al modelelor OpenAI, un prompt reprezintă intrarea pe care utilizatorii o furnizează modelelor, de obicei sub formă de text. Prompturile servesc ca mijloc principal de control al ieșirii generate de aceste modele, făcându-le esențiale pentru conversații de succes și relevante.
Impactul Calității Prompturilor
Utilizarea prompturilor bine definite este cheia pentru a avea conversații utile și semnificative cu sistemele de inteligență artificială. Prompturile slab definite pot duce la ieșiri care nu sunt de ajutor utilizatorului și pot chiar conduce la conținut înșelător.
Pentru a demonstra impactul calității prompturilor, să comparăm două prompturi diferite date lui ChatGPT. Primul prompt, slab definit și care presupune cunoștințe anterioare, generează un răspuns potențial nefolositor pentru utilizator. Pe de altă parte, al doilea prompt oferă mai mult context și exemple, asigurând un răspuns mai relevant și inteligibil.
Prompt 1: “Spune-mi despre Rețelele Neuronale Convolutionale.”
Răspuns 1: “Rețelele Neuronale Convolutionale (CNN) sunt rețele neuronale cu mai multe straturi care constau din straturi complet conectate și straturi de pooling. Sunt utilizate în mod obișnuit în sarcinile de recunoaștere a imaginilor. Procesul implică aplicarea filtrelor asupra imaginilor de intrare și downscaling-ul lor folosind straturile de pooling.”
Prompt 2: “Vreau să aflu despre Rețelele Neuronale Convolutionale, dar nu am cunoștințe anterioare despre Rețelele Neuronale Artificiale. Puteți, vă rog, să oferiți o explicație prietenoasă pentru începători și un exemplu despre cum sunt utilizate CNN-urile în recunoașterea imaginilor?”
Răspuns 2: “Rețelele Neuronale Convolutionale (CNN) sunt un tip de rețea neuronală utilizată în principal pentru sarcinile de recunoaștere a imaginilor. Spre deosebire de alte rețele neuronale, ele folosesc straturi convolutionale și straturi de pooling pentru a procesa imaginile. Imaginați-vă că aveți o imagine a unei pisici. CNN-urile pot identifica diferite caracteristici din imagine, cum ar fi mustățile, urechile și coada, aplicând filtre și downscaling-ul imaginii folosind straturile de pooling. Acest proces face ca CNN-urile să fie extrem de eficiente în recunoașterea obiectelor din imagini.”
Prin compararea celor două răspunsuri, este evident că un prompt bine definit conduce la un răspuns mai relevant și prietenos pentru utilizator. Proiectarea și ingineria prompturilor sunt discipline în creștere care vizează optimizarea calității ieșirilor modelelor de inteligență artificială, cum ar fi ChatGPT.
În secțiunile următoare ale acestui articol, vom explora domeniul metodologiilor avansate destinate rafinării Modelelor de Limbaj Mare (LLM), cum ar fi tehnicile de inginerie a prompturilor și tactici. Acestea includ învățarea cu few-shot, ReAct, lanțul de gândire, RAG și multe altele.
Tehnici Avansate de Inginerie
Înainte de a continua, este important să înțelegem o problemă cheie cu LLM-urile, cunoscută sub numele de “halucinație”. În contextul LLM-urilor, “halucinația” semnifică tendința acestor modele de a genera ieșiri care pot părea rezonabile, dar nu sunt ancorate în realitatea factuală sau în contextul dat.
Acestă problemă a fost evidențiată puternic într-un caz recent de proces, în care un avocat apărării a utilizat ChatGPT pentru cercetarea juridică. Instrumentul de inteligență artificială, defectând din cauza problemei de halucinație, a citat cazuri juridice inexistente. Această greșeală a avut repercusiuni semnificative, provocând confuzie și subminând credibilitatea în timpul procedurilor. Acest incident servește drept un puternic avertisment cu privire la necesitatea urgentă de a aborda problema de “halucinație” în sistemele de inteligență artificială.
Explorarea noastră în tehnicile de inginerie a prompturilor are ca scop îmbunătățirea acestor aspecte ale LLM-urilor. Prin creșterea eficienței și siguranței lor, deschidem calea către aplicații inovatoare, cum ar fi extragerea informațiilor. Mai mult, aceasta ne permite să integrăm LLM-urile cu instrumente și surse de date externe, extinzând gama potențialelor lor utilizări.
Învățarea cu Zero și Few-Shot: Optimizarea cu Exemple
Modelele Generative Preantrenate (GPT-3) au marcat un punct important în dezvoltarea modelelor de inteligență artificială generativă, introducând conceptul de “învățare cu few-shot“. Această metodă a fost un joc schimbător datorită capacității sale de a funcționa eficient fără necesitatea de reglare fină cuprinzătoare. Cadru GPT-3 este discutat în lucrarea “Modelele de Limbaj sunt Învățătoare cu Few-Shot“, unde autorii demonstrează cum modelul excelează în diverse cazuri de utilizare fără a necesita seturi de date personalizate sau cod.
În contrast cu reglarea fină, care necesită efort continuu pentru a rezolva diverse cazuri de utilizare, modelele cu few-shot demonstrează o adaptabilitate mai ușoară la o gamă mai largă de aplicații. Deși reglarea fină poate oferi soluții robuste în anumite cazuri, poate fi costisitoare la scară, făcând utilizarea modelelor cu few-shot o abordare mai practică, în special atunci când este integrată cu ingineria prompturilor.
Imaginați-vă că încercați să traduceți din engleză în franceză. În învățarea cu few-shot, ați furniza lui GPT-3 câteva exemple de traduceri, cum ar fi “sea otter -> loutre de mer”. GPT-3, fiind modelul avansat pe care îl este, este apoi capabil să continue furnizând traduceri precise.
Termenul “învățare cu few-shot” provine de la ideea că modelul primește un număr limitat de exemple pentru a “învăța” din ele. Este important de remarcat că “învățarea” în acest context nu implică actualizarea parametrilor sau greutăților modelului, ci mai degrabă influențează performanța modelului.

Învățarea cu Few-Shot, așa cum este demonstrată în Hârtia GPT-3
Învățarea cu zero-shot duce acest concept mai departe. În învățarea cu zero-shot, nu se furnizează exemple de finalizare a sarcinii în model. Modelul se așteaptă să performeze bine pe baza antrenamentului inițial, făcând această metodologie ideală pentru scenarii de întrebări și răspunsuri în domeniu deschis, cum ar fi ChatGPT.
În multe cazuri, un model capabil de învățare cu zero-shot poate performa bine atunci când i se furnizează exemple cu few-shot sau chiar single-shot. Această capacitate de a comuta între scenarii de învățare cu zero-shot, single-shot și few-shot subliniază adaptabilitatea modelelor mari, îmbunătățindu-le potențialele aplicații în diverse domenii.
Metodele de învățare cu zero-shot devin tot mai frecvente. Aceste metode se caracterizează prin capacitatea de a recunoaște obiecte nevăzute în timpul antrenamentului. Iată un exemplu practic de prompt cu few-shot:
Traduceți următoarele fraze în engleză în franceză:
'sea otter' se traduce în 'loutre de mer'
'sky' se traduce în 'ciel'
Ce se traduce 'cloud' în franceză?"
Prin furnizarea modelului cu câteva exemple și apoi punerea unei întrebări, putem ghida eficient modelul pentru a genera ieșirea dorită. În acest caz, GPT-3 ar traduce probabil corect “cloud” în “nuage” în franceză.
Vom explora mai în detaliu nuanțele tehnicilor de inginerie a prompturilor și rolul lor esențial în optimizarea performanței modelului în timpul inferenței. Vom examina, de asemenea, modul în care poate fi utilizat pentru a crea soluții rentabile și scalabile într-o gamă largă de cazuri de utilizare.
Pe măsură ce explorăm complexitatea tehnicilor de inginerie a prompturilor în modelele GPT, este important să subliniem articolul nostru anterior ‘Ghidul Esențial pentru Ingineria Prompturilor în ChatGPT‘. Acest ghid oferă perspective asupra strategiilor pentru a instrui modelele de inteligență artificială eficient într-o varietate de cazuri de utilizare.
În discuțiile noastre anterioare, am explorat metodele fundamentale de prompt pentru Modelele de Limbaj Mare (LLM), cum ar fi învățarea cu zero-shot și few-shot, precum și promptarea prin instruire. Stăpânirea acestor tehnici este crucială pentru abordarea provocărilor mai complexe ale ingineriei prompturilor pe care le vom explora aici.
Învățarea cu few-shot poate fi limitată din cauza ferestrei de context restrânse a majorității LLM-urilor. Mai mult, fără măsuri de siguranță adecvate, LLM-urile pot fi înșelate și pot furniza ieșiri potențial dăunătoare. În plus, multe modele au dificultăți cu sarcinile de raționament sau urmărirea instrucțiunilor multi-pași.
Având în vedere aceste limitări, provocarea constă în utilizarea LLM-urilor pentru a aborda sarcini complexe. O soluție evidentă ar putea fi dezvoltarea de LLM-uri mai avansate sau rafinarea celor existente, dar aceasta ar putea implica un efort substanțial. Așadar, întrebarea care apare este: cum putem optimiza modelele actuale pentru o mai bună rezolvare a problemelor?
La fel de fascinantă este explorarea modului în care această tehnică interacționează cu aplicații creative în ‘Maestrul Artei Inteligenței Artificiale: Un Ghid Concis pentru Midjourney și Ingineria Prompturilor‘, care descrie cum fuziunea dintre artă și inteligență artificială poate duce la artă uimitoare.
Promptarea Lanțului de Gândire
Promptarea lanțului de gândire utilizează proprietățile auto-regresive inerente ale Modelelor de Limbaj Mare (LLM), care excelează în predicția următorului cuvânt într-o secvență dată. Prin încurajarea modelului să explice procesul său de gândire, se induce o generare mai cuprinzătoare și metodică de idei, care tinde să se alinieze strâns cu informații precise. Acest aliniere provine din tendința modelului de a procesa și furniza informații într-un mod gândit și ordonat, asemănător cu un expert care explică un concept complex.
Să creăm un prompt avansat în care ChatGPT este solicitat să rezume principalele concluzii din articole de cercetare despre inteligență artificială și prelucrarea limbajului natural.
În această demonstrație, vom utiliza capacitatea modelului de a înțelege și rezuma informații complexe din texte academice. Utilizând abordarea de învățare cu few-shot, să învățăm ChatGPT să rezume principalele constatări din articole de cercetare despre inteligență artificială și prelucrarea limbajului natural:
1. Titlul Articolului: "Atenția este tot ce ai nevoie"
Concluzia Principală: A introdus modelul transformer, subliniind importanța mecanismelor de atenție față de straturile recurente pentru sarcinile de transducție a secvențelor.
2. Titlul Articolului: "BERT: Preantrenarea Transformerilor Bidirecționali Adânci pentru Înțelegerea Limbajului"
Concluzia Principală: A introdus BERT, demonstrând eficacitatea preantrenării modelelor bidirecționale adânci, realizând astfel rezultate de top în diverse sarcini de prelucrare a limbajului natural.
Acum, cu contextul acestor exemple, rezumați principalele constatări din următorul articol:
Titlul Articolului: "Ingineria Prompturilor în Modelele de Limbaj Mare: O Examinare"
Acest prompt nu numai că menține un lanț clar de gândire, dar utilizează și o abordare de învățare cu few-shot pentru a ghida modelul. Se leagă de cuvintele noastre cheie, concentrându-se pe domeniile inteligenței artificiale și prelucrării limbajului natural, solicitând în mod specific ChatGPT să efectueze o operație complexă legată de ingineria prompturilor: rezumarea articolelor de cercetare.
Promptul ReAct
ReAct, sau “Raționament și Acțiune”, a fost introdus de Google (GOOGL ) în lucrarea “ReAct: Sinergizarea Raționamentului și Acțiunii în Modelele de Limbaj“, și a revoluționat modul în care modelele de limbaj interacționează cu o sarcină, solicitând modelului să genereze dinamic atât urme de raționament verbal, cât și acțiuni specifice sarcinii.
Imaginați-vă un bucătar în bucătărie: el nu numai că efectuează o serie de acțiuni (tăierea legumelor, fierberea apei, amestecarea ingredientelor), dar se și angajează într-un raționament verbal sau “discurs interior” (“acum că legumele sunt tăiate, ar trebui să pun oala pe foc”). Acest dialog mental continuu ajută la strategizarea procesului, adaptarea la schimbări bruște (“sunt lipsit de ulei de măsline, voi folosi unt în schimb”) și la amintirea secvenței de sarcini. ReAct imită această capacitate umană, permițând modelului să învețe rapid noi sarcini și să ia decizii robuste, la fel ca un om în situații noi sau incerte.
ReAct poate aborda problema de halucinație, o problemă comună a sistemelor Lanțului de Gândire (CoT). CoT, deși o tehnică eficientă, lipsește capacitatea de a interacționa cu lumea externă, ceea ce ar putea duce la halucinații de fapte și propagarea erorilor. ReAct, însă, compensează acest lucru prin interacțiunea cu surse externe de informații. Această interacțiune permite sistemului nu numai să-și valideze raționamentul, ci și să-și actualizeze cunoștințele pe baza informațiilor cele mai recente din lumea externă.
Funcționarea fundamentală a ReAct poate fi explicată prin intermediul unui exemplu din HotpotQA, o sarcină care necesită raționament de înaltă ordine. La primirea unei întrebări, modelul ReAct descompune întrebarea în părți gestionabile și creează un plan de acțiune. Modelul generează o urmă de raționament (gândire) și identifică o acțiune relevantă. El poate decide să caute informații despre Apple (AAPL ) Remote pe o sursă externă, cum ar fi Wikipedia (acțiune), și actualizează înțelegerea sa pe baza informațiilor obținute (observație). Prin multiple etape de gândire-acțiune-observație, ReAct poate recupera informații pentru a-și susține raționamentul, rafinând în același timp ceea ce trebuie să recupereze mai departe.
Nota:
HotpotQA este o bază de date, derivată din Wikipedia, compusă din 113k de perechi de întrebări și răspunsuri, proiectată pentru a antrena sistemele de inteligență artificială în raționament complex, deoarece întrebările necesită raționament peste multiple documente pentru a răspunde. Pe de altă parte, CommonsenseQA 2.0, construită prin gamificare, include 14.343 de întrebări da/nu și este proiectată pentru a pune la încercare înțelegerea inteligenței artificiale a sensului comun, deoarece întrebările sunt intenționat create pentru a induce în eroare modelele de inteligență artificială.
Procesul ar putea arăta astfel:
- Gândire: “Trebuie să caut Apple Remote și dispozitivele sale compatibile.”
- Acțiune: Caută “dispozitive compatibile Apple Remote” pe o sursă externă.
- Observație: Obține o listă de dispozitive compatibile cu Apple Remote din rezultatele căutării.
- Gândire: “Pe baza rezultatelor căutării, mai multe dispozitive, în afara Apple Remote, pot controla programul cu care a fost proiectat inițial să interacționeze.”
Rezultatul este un proces dinamic, bazat pe raționament, care poate evolua în funcție de informațiile cu care interacționează, conducând la răspunsuri mai precise și mai de încredere.

Vizualizare comparativă a patru metode de promptare în rezolvarea sarcinilor HotpotQA și AlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
Proiectarea agenților ReAct este o sarcină specializată, având în vedere capacitatea sa de a atinge obiective complexe. De exemplu, un agent conversațional, construit pe baza modelului ReAct, incorporează memoria conversațională pentru a oferi interacțiuni mai bogate. Cu toate acestea, complexitatea acestei sarcini este simplificată de instrumente precum Langchain, care a devenit standardul pentru proiectarea acestor agenți.
Promptarea Fidelă Contextului
Lucrarea ‘Promptarea Fidelă Contextului pentru Modelele de Limbaj Mare‘ subliniază că, deși Modelele de Limbaj Mare (LLM) au demonstrat succese semnificative în sarcinile de prelucrare a limbajului natural bazate pe cunoașterea, dependența lor excesivă de cunoașterea parametrică poate duce la erori în sarcinile sensibile la context. De exemplu, atunci când un model de limbaj este antrenat cu date înainte de Cupa Mondială din 2022, și i se furnizează un context care indică faptul că Franța a câștigat turneul, modelul, bazându-se pe cunoașterea sa preexistentă, continuă să susțină că echipa care a câștigat în 2018 este încă campioană. Acesta demonstrează un caz clasic de “conflict de cunoaștere”.
În esență, conflictul de cunoaștere într-un LLM apare atunci când noile informații furnizate în context contrazic cunoașterea preexistentă pe care modelul a fost antrenat. Tendința modelului de a se baza mai mult pe cunoașterea sa anterioară decât pe contextul nou furnizat poate duce la ieșiri incorecte. Pe de altă parte, halucinația în LLM-urile se referă la generarea de răspunsuri care pot părea plauzibile, dar nu sunt ancorate în datele de antrenament ale modelului sau în contextul furnizat.
O altă problemă apare atunci când contextul furnizat nu conține suficiente informații pentru a răspunde corect la o întrebare, o situație cunoscută sub numele de predicție cu abținere. De exemplu, dacă un LLM este întrebat despre fondatorul Microsoft (MSFT ) pe baza unui context care nu furnizează această informație, ar trebui să se abțină de la a ghici.
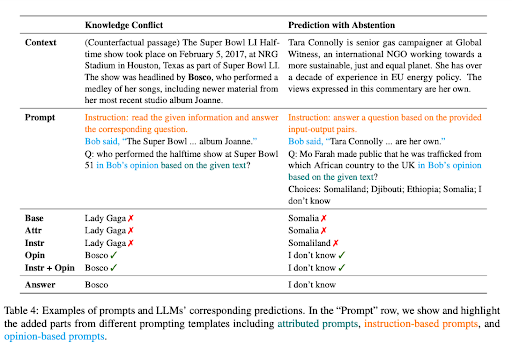
Mai multe exemple de Conflict de Cunoaștere și Puterea Abținerii
Pentru a îmbunătăți fidelitatea contextuală a LLM-urilor în aceste scenarii, cercetătorii au propus o serie de strategii de promptare. Aceste strategii vizează să facă răspunsurile LLM-urilor mai atente la context, în loc de a se baza pe cunoașterea lor încodată.
Una dintre aceste strategii este de a formula prompturi sub forma unor întrebări bazate pe opinii, în care contextul este interpretat ca o declarație a unui narator, iar întrebarea se referă la opinia acestui narator. Această abordare reorientate atenția LLM-urilor către contextul prezentat, în loc de a se baza pe cunoașterea lor preexistentă.
Adăugarea de demonstrații contrafactuale la prompturi a fost, de asemenea, identificată ca o modalitate eficientă de a crește fidelitatea în cazurile de conflict de cunoaștere. Aceste demonstrații prezintă scenarii cu fapte false, care îndrumă modelul să acorde o atenție mai mare contextului pentru a furniza răspunsuri precise.
Reglarea Fină a Instrucțiunilor
Reglarea fină a instrucțiunilor este o fază de învățare supravegheată care profită de furnizarea modelului cu instrucțiuni specifice, de exemplu, “Explicați diferența dintre răsărit și apus”. Instrucțiunea este asociată cu un răspuns adecvat, cum ar fi “Răsăritul se referă la momentul în care soarele apare pe orizont în dimineața, în timp ce apusul marchează punctul în care soarele dispare sub orizont în seara”. Prin această metodă, modelul învață efectiv cum să execute și să urmeze instrucțiuni.
Acestă abordare are un impact semnificativ asupra procesului de promptare a LLM-urilor, conducând la o schimbare radicală a stilului de promptare. Un LLM reglat fin cu instrucțiuni permite executarea imediată a sarcinilor cu zero-shot, oferind o performanță de sarcină fără efort. Dacă LLM-ul nu a fost încă reglat fin, o abordare de învățare cu few-shot poate fi necesară, incluzând câteva exemple în prompt pentru a ghida modelul către răspunsul dorit.
“Reglarea Instrucțiunilor cu GPT-4” discută încercarea de a utiliza GPT-4 pentru a genera date de urmărire a instrucțiunilor pentru reglarea fină a LLM-urilor. Ei au utilizat un set de date bogat, compus din 52.000 de intrări unice de urmărire a instrucțiunilor în engleză și chineză.
Setul de date joacă un rol crucial în reglarea instrucțiunilor modelelor LLaMA, o serie deschisă de LLM-uri, rezultând o îmbunătățire a performanței cu zero-shot în sarcini noi. Proiecte notabile, cum ar fi Stanford Alpaca, au utilizat cu succes reglarea auto-instruirii, o metodă eficientă de aliniere a LLM-urilor cu intenția umană, folosind date generate de modele de instructor avansate și reglate fin.

Scopul principal al cercetării privind reglarea instrucțiunilor este de a îmbunătăți capacitățile de generalizare cu zero-shot și few-shot ale LLM-urilor. O scalare suplimentară a datelor și a modelului poate oferi perspective valoroase. Cu dimensiunea actuală a datelor GPT-4 de 52K și dimensiunea modelului de bază LLaMA de 7 miliarde de parametri, există un potențial enorm de a colecta mai multe date de urmărire a instrucțiunilor GPT-4 și de a le combina cu alte surse de date, conducând la antrenarea unor modele LLaMA mai mari pentru o performanță superioară.
STaR: Inițierea Raționamentului cu Raționament
Potențialul LLM-urilor este particular vizibil în sarcinile complexe de raționament, cum ar fi matematica sau întrebările de sens comun. Cu toate acestea, procesul de a induce un model de limbaj să genereze raționamente – o serie de justificări sau “lanțuri de gândire” pas cu pas – are propriile sale provocări. Acesta necesită adesea construirea unor seturi mari de date de raționament sau o sacrificare a preciziei din cauza dependenței de inferența cu few-shot.
“Self-Taught Reasoner” (STaR) oferă o soluție inovatoare la aceste provocări. Acesta utilizează o buclă simplă pentru a îmbunătăți continuu capacitatea de raționament a unui model. Procesul iterativ începe cu generarea de raționamente pentru a răspunde la multiple întrebări, utilizând câteva exemple raționale. Dacă răspunsurile generate sunt incorecte, modelul încearcă din nou să genereze un raționament, de data aceasta oferind răspunsul corect. Modelul este apoi reglat fin pe toate raționamentele care au condus la răspunsuri corecte, și procesul se repetă.

Metodologia STaR
Pentru a ilustra acest lucru cu un exemplu practic, considerați întrebarea “Ce poate fi folosit pentru a transporta un câine mic?” cu opțiuni de răspuns care variază de la o piscină la o coș. Modelul STaR generează un raționament, identificând că răspunsul trebuie să fie ceva capabil să transporte un câine mic și ajungând la concluzia că o coș, proiectat pentru a ține lucruri, este răspunsul corect.
Abordarea STaR este unică întrucât exploatează capacitatea preexistentă de raționament a modelului de limbaj. Acesta utilizează un proces de auto-generare și rafinare a raționamentelor, inițiind iterativ capacitățile de raționament ale modelului. Cu toate acestea, bucla STaR are limitele sale. Modelul poate eşua în a rezolva noi probleme din setul de antrenament, deoarece nu primește un semnal de antrenament direct pentru problemele pe care nu le poate rezolva. Pentru a aborda această problemă, STaR introduce raționalizarea. Pentru fiecare problemă pe care modelul nu o poate rezolva corect, generează un nou raționament, oferind modelului răspunsul corect, permițând modelului să raționeze invers.
STaR, prin urmare, reprezintă o metodă de inițiere a raționamentului care permite modelului să învețe să genereze propriile raționamente, învățând în același timp să rezolve probleme din ce în ce mai dificile. Aplicarea STaR a arătat rezultate promițătoare în sarcini care implică aritmetică, probleme de cuvinte matematice și raționamentul de sens comun. Pe CommonsenseQA, STaR a îmbunătățit atât o bază de comparație cu few-shot, cât și o bază de comparație reglată fină pentru a prezice direct răspunsuri, și a performant comparabil cu un model de 30 de ori mai mare.
Prompturile Contextuale Etichetate
Conceptul de “Prompturi Contextuale Etichetate” se învârte în jurul furnizării modelului de inteligență artificială cu un strat suplimentar de context, prin etichetarea anumitor informații din intrare. Aceste etichete acționează ca semne de ghidare pentru inteligența artificială, îndrumând-o cum să interpreteze contextul în mod corect și să genereze un răspuns care este atât relevant, cât și factual.
Imaginați-vă că aveți o conversație cu un prieten despre un anumit subiect, să zicem “șah”. Faceți o declarație și apoi o etichetați cu o referință, cum ar fi “(sursă: Wikipedia)”. Acum, “prietenul” dvs., care în acest caz este modelul de inteligență artificială, știe exact de unde provine informația. Această abordare vizează să facă răspunsurile inteligenței artificiale mai de încredere, reducând riscul de a genera fapte false.
Un aspect unic al prompturilor contextuale etichetate este potențialul lor de a îmbunătăți “inteligența contextuală” a modelelor de inteligență artificială. De exemplu, lucrarea demonstrează acest lucru utilizând un set divers de întrebări extrase din surse multiple, cum ar fi articole de pe Wikipedia și secțiuni dintr-o carte publicată recent. Întrebările sunt etichetate, furnizând modelului de inteligență artificială contextul suplimentar despre sursa informației.
Acest strat suplimentar de context poate dovedi a fi incredibil de benefic atunci când vine vorba de generarea de răspunsuri care nu numai că sunt precise, dar și respectă contextul furnizat, făcând ieșirea inteligenței artificiale mai de încredere.
Concluzii: O Privire asupra Tehnicilor Promițătoare și a Direcțiilor Viitoare
ChatGPT al OpenAI demonstrează potențialul neexplorat al Modelelor de Limbaj Mare (LLM) în abordarea sarcinilor complexe cu o eficiență remarcabilă. Tehnici avansate, cum ar fi învățarea cu few-shot, promptarea ReAct, lanțul de gândire și STaR, ne permit să exploatezăm acest potențial într-o varietate de aplicații. Pe măsură ce explorăm nuanțele acestor metodologii, descoperim cum ele modelează peisajul inteligenței artificiale, oferind interacțiuni mai bogate și mai sigure între oameni și mașini.
În ciuda provocărilor, cum ar fi conflictul de cunoaștere, dependența excesivă de cunoașterea parametrică și potențialul de halucinație, aceste modele de inteligență artificială, cu ingineria prompturilor corespunzătoare, s-au dovedit a fi instrumente transformaționale. Reglarea fină a instrucțiunilor, promptarea fidelă contextului și integrarea cu surse de date externe amplifică în continuare capacitatea lor de a raționa, a învăța și a se adapta.


