
Interviuri
Ben Koska, Fondator și CEO al SF Tensor – Seria de Interviuri

 Adaugă Unite.AI la sursele tale preferate pe Google
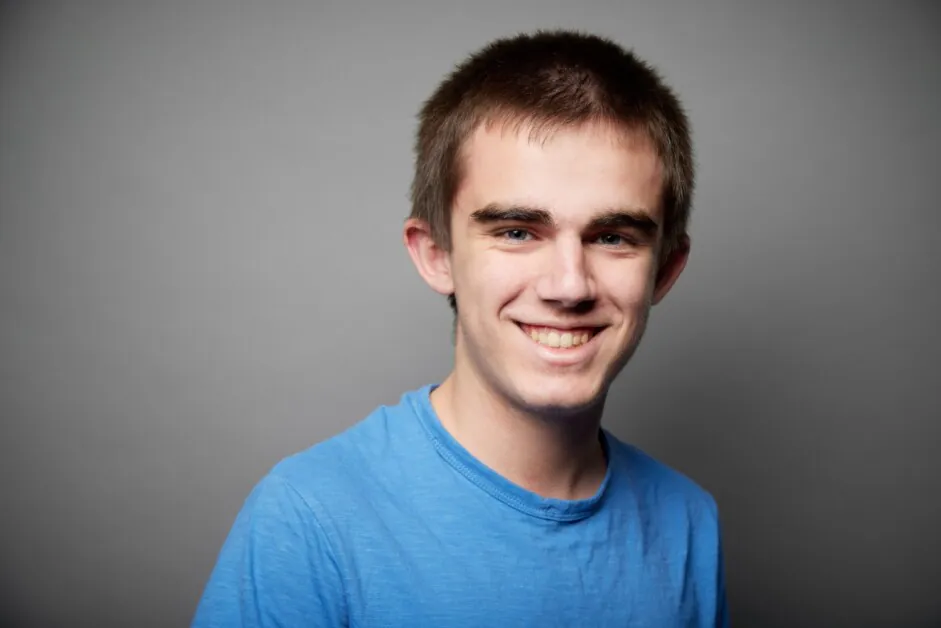
Ben Koska, Fondator și CEO al SF Tensor, este un cercetător în domeniul inteligenței artificiale și inginer sistemist, cunoscut pentru munca sa în domeniul calculului de înaltă performanță, optimizării kernel-ului și antrenării eficiente a modelelor. Experiența sa cuprinde dezvoltarea de infrastructuri de inteligență artificială de nivel scăzut, îmbunătățirea debitului de antrenare și proiectarea unor instrumente care fac dezvoltarea avansată a modelelor accesibilă fără a necesita o inginerie greoaie. El se concentrează pe construirea unor sisteme care împing limitele vitezei, portabilității și fiabilității pe hardware eterogen.
SF Tensor este compania pe care o conduce pentru a transforma această filozofie într-o platformă practică. Ea introduce un model de programare unificat, un optimizator de kernel și un strat de orchestrare inter-cloud conceput pentru a elimina complexitatea sarcinilor de lucru distribuite de inteligență artificială. Platforma își propune să ofere inginerilor un mediu curat, independent de hardware, în care pot scrie odată și să deployeze oriunde, atingând în mod automat o performanță ridicată. Misiunea SF Tensor este de a face calculul de inteligență artificială dramatic mai rapid, mai ușor de gestionat și liber de blocajele furnizorilor.
Ați fondat SF Tensor la doar 19 ani, după ce ați condus deja echipe de ingineri în mai multe startup-uri. Ce v-a inspirat să acceptați provocarea de a reinventa infrastructura de inteligență artificială atât de devreme în cariera dvs.?
Problema pe care o rezolvăm este una pentru care eu am o profundă apreciere, deoarece este una cu care m-am confruntat și eu. Când am dezvoltat ceea ce este acum stiva centrală a SF Tensor, nu lucram la un proiect comercial, ci la unul academic. Am primit o subvenție pentru a efectua o cercetare interesantă, dar am petrecut cea mai mare parte a timpului nostru luptându-ne cu infrastructura și optimizările, în loc să facem cercetare. Am descoperit că oamenii erau mult mai interesați de tehnologia noastră de infrastructură decât de proiectul nostru de cercetare.
SF Tensor abordează una dintre cele mai dificile probleme din domeniul inteligenței artificiale — înlăturarea dominanței NVIDIA CUDA. Cum ați abordat proiectarea unui sistem care să poată atinge o portabilitate reală a hardware-ului fără a compromite performanța?
La sfârșitul zilei, toată inteligența artificială se reduce la simple matematică. Fiecare model este esențialmente un set de operații matematice pe care trebuie să le calculăm pentru a obține rezultatele. Tratând această problemă în primul rând ca pe una matematică și nu ca pe una de știință a calculatoarelor, putem identifica cel mai mic set de constrângeri asupra calculelor, apoi genera milioane sau miliarde de moduri diferite de a transforma aceste calcule în cod de mașină, găsind cel mai rapid. Acest lucru este mai ușor de spus decât de făcut, deoarece nu putem rula cu adevărat miliarde de programe diferite pentru a găsi cel mai rapid, așa că pentru a reduce spațiul nostru de căutare, am trebuit să concepem un model matematic precis pentru a estima viteza unui anumit program pentru un anumit hardware, ceea ce este una dintre inovațiile cheie care fac posibil ceea ce facem astăzi.
Blogul companiei subliniază inovațiile din jurul optimizării compilatorului și orchestrării inter-cloud. Cum se diferențiază abordarea SF Tensor de cadrele existente, cum ar fi PyTorch sau JAX?
De fapt, nu am scris încă un blog tehnic despre acest subiect, dar suportăm cadre precum PyTorch și JAX, permițând codului scris în acestea să fie optimizat de stiva noastră. Există câteva decizii arhitecturale pe care JAX și PyTorch le-au luat și care le diferențiază de stiva noastră, dar cea mai semnificativă este că tratăm întregul model ca o singură calculare care trebuie rezolvată, și nu ca module individuale care trebuie optimizate individual și apoi împreună. În acest sens, în loc să aplicăm tehnici tradiționale de optimizare a compilatorului și să încercăm să aplicăm fiecare optimizare individuală, creăm un spațiu de căutare de milioane sau uneori miliarde de kerneluri potențiale și susținem că niciun om nu poate concepe o set de reguli pentru a transforma orice cod în cel mai rapid, așa că în schimb, trebuie pur și simplu să creăm toate combinațiile și apoi să identificăm cel mai rapid.
Multi startup-uri se concentrează pe eficiența antrenării, dar dvs. ați subliniat „taxa de infrastructură” — timpul pe care cercetătorii îl pierd gestionând calculul în loc de a inova. Cum abordează SF Tensor acest dezechilibru?
Credem că ambele probleme trebuie abordate, și o parte semnificativă a muncii noastre se concentrează pe eficiența antrenării, dar problema cea mai acută pe care o putem rezolva în acest moment, fără a fi condiționați de inovații viitoare, este taxa de infrastructură, deoarece este o problemă pe care am rezolvat-o deja pentru noi înșine.
Ați menționat reduceri de până la 80% în costurile de antrenare. Care sunt optimizările sau inovațiile arhitecturale specifice care fac posibil acest lucru?
Întreaga noastră stivă de software se bazează pe ideea că un compilator bazat pe căutare va bate întotdeauna regulile create de oameni. Până acum, cea mai mare constrângere pentru acești compilatori a fost faptul că nu este posibil să se testeze și să se clasifice miliarde sau chiar milioane de kerneluri. A fost, prin urmare, necesar pentru noi să creăm un model matematic al calculului care să poată estima cu acuratețe timpul necesar pentru a efectua o anumită calculare sau un set de calcule pe un anumit hardware. Prin aceasta, putem extinde spațiul nostru de căutare și apoi să-l reducem, ceea ce este o necesitate dacă dorim să găsim kernelurile cele mai rapide în mod constant.
Cum influențează experiența dvs. în construirea limbajului de programare Emma arhitectura și filozofia SF Tensor în ceea ce privește performanța și abstractizarea?
Nu spuneți investitorilor mei, dar în inimă, eu sunt încă un inginer de compilatoare. Am fost întotdeauna interesat de găsirea unor modalități de a face lucrurile chiar și numai puțin mai rapide. Dezvoltând Emma, am aruncat întregul compilator de 4 sau 5 ori; am început de la zero, de fiecare dată, deoarece am dat peste o optimizare pe care nu o puteam implementa având în vedere constrângerile actuale, ceea ce ne-a forțat să reinginerizăm sistemul pentru a fi și mai general, permițându-ne să coborâm la nivelul cel mai de jos de optimizare atunci când a fost necesar, adesea mergând împotriva principiilor comune de proiectare a compilatoarelor și limbajelor. Aceste învățăminte și arhitectura rezultată, combinând aproape doi ani de ceea ce părea multora o optimizare minoră și pariuri greșite, s-au transformat într-un sistem care ne permite acum să iterăm mai rapid și să optimizăm mai bine decât orice sistem care a urmat principiile comune, deoarece aceste principii sunt fundamental concepute pentru procesoare, nu pentru unități de procesare grafică și modele de inteligență artificială.
Ați lucrat la rulări de antrenare la scară largă pe peste 4.000 de unități de procesare grafică — care au fost cele mai importante lecții învățate din gestionarea calculului la această scară?
O lecție importantă este că defectarea hardware-ului este mult mai frecventă și mai problematică decât s-ar putea crede. Având în vedere timpul petrecut lucrând cu programe tradiționale și compilatoare, în general, un calculator face exact ce i se spune, și dacă ceva merge prost, este aproape întotdeauna vina persoanei care a scris codul. Cu unitățile de procesare grafică, pe de altă parte, defectarea hardware-ului este o apariție obișnuită, mai ales în rulările de antrenare distribuite pe clusteruri extrem de mari. În același timp, pe lângă aceasta, se află faptul că, spre deosebire de procesoarele care, în general, acționează într-un mod determinist și previzibil, unitățile de procesare grafică pot uneori să facă lucruri inexplicabile, cum ar fi reducerea vitezei ceasului fără niciun motiv aparent, încetinind întregul proces de antrenare, deoarece un singur cip rulează mai lent.
Y Combinator a sprijinit unele dintre cele mai transformaționale companii de infrastructură din tehnologie. Cum a influențat această experiență abordarea dvs. de a scala produsul și viziunea SF Tensor?
Înainte de a intra în Y Combinator, credeam că pariuul pe care îl voiam să îl facem atunci era ambițios. După doar câteva săptămâni, definiția noastră pentru ambiție s-a schimbat drastic, și am dublat pariul pe unul și mai mare. În plus, sentimentul de comunitate și învățare pe care îl pot obține, putând să sun sau să trimit un e-mail către aproape orice companie sau persoană de acolo și să primesc un răspuns și sfaturi într-un termen de câteva ore sau zile, a schimbat modul în care gândim despre abordarea problemelor și adoptarea unei abordări mult mai colaborative.
Privind înainte, ați exprimat interes pentru modele non-LLM, robotică și date sintetice. Cum se potrivesc aceste domenii în viziunea dvs. pe termen lung pentru companie?
Modelele LLM sunt, într-adevăr, o tehnologie interesantă și vor juca un rol integrant în modul în care va arăta lumea în viitor, dar motivul pentru care sunt atât de mult mai avansate decât orice alt domeniu al inteligenței artificiale provine în principal din faptul că există multă bani investiți în dezvoltarea lor, și există suficient de multe persoane care colaborează la această problemă, astfel încât au devenit destul de optimizate. Dacă putem reduce bariera de intrare, permițând cercetătorilor din întreaga țară și de pe planetă, chiar și celor cu resurse limitate și cunoștințe minime în optimizări, să-și desfășoare cercetarea în mod cât mai ieftin și eficient posibil, cred că vom vedea o nouă generație de modele care vor aborda probleme pentru care modelele LLM nu sunt potrivite, fie pentru că interacționează cu lumea fizică, fie pentru că sunt probleme care nu pot fi exprimate corespunzător în limbaj.
Ce credeți că va arăta stiva de infrastructură de inteligență artificială peste cinci ani — și unde vedeți rolul SF Tensor în cadrul acesteia?
Peste cinci ani, sper că multe alte companii vor fi dezvoltat și lansat propriile lor cipuri specializate, și că cercetătorii vor putea să le valorifice și să le utilizeze fără a trebui să scrie cod special pentru ele, ideal fără a fi nevoie să știe măcar că există. Acesta este viitorul pe care lucrăm să îl creăm și în care cred că vom juca un rol semnificativ în modelarea lui.
Mulțumim pentru acest interviu minunat; cititorii care doresc să afle mai multe pot vizita SF Tensor.


