
Unghiul lui Anderson
Un sistem de învățare automată pentru a rescrie un articol în timp ce îl citești

 Adaugă Unite.AI la sursele tale preferate pe Google
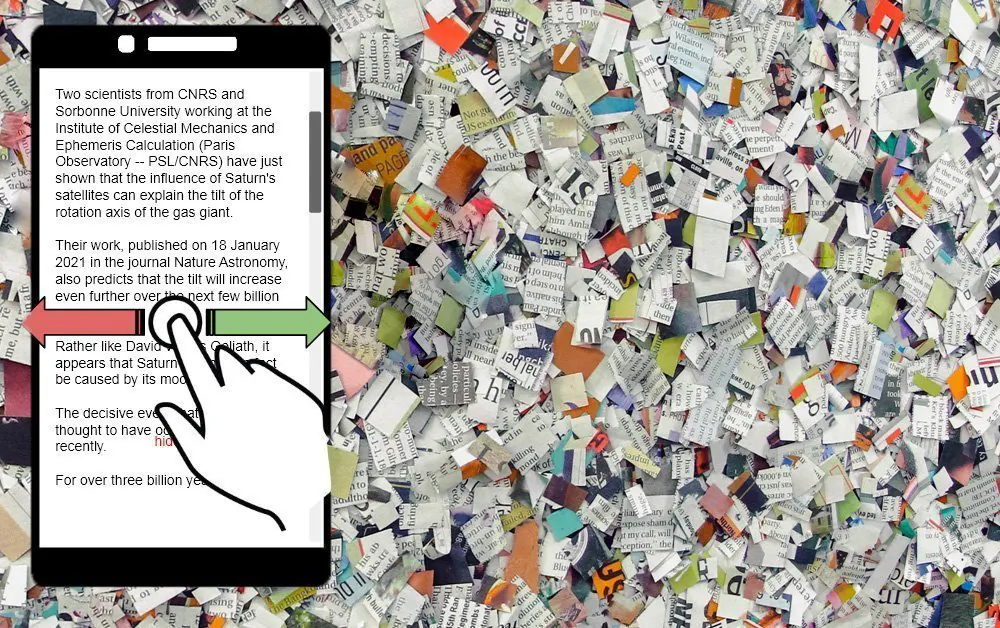
Noi cercetări din Canada propun o metodă pentru a rescrie automat un articol în timp ce îl citești, pe baza unui sistem de “swiping” similar cu cel de la Tinder, sau pe baza observării pasive a interacțiunii cititorului cu diversele tipuri de conținut din articol.
Sistemul, intitulat Hone As You Read (HARE), este prezentat într-un articol de la Universitatea Western din Ontario, Canada, cu codul Python corespunzător pe GitHub.
Idea centrală a proiectului este că un articol poate conține diverse tipuri de conținut, evoluând (similar cu acesta) de la titlu la detalii suplimentare. Părțile ulterioare ale unui articol pot conține diverse materiale de susținere, cazuri de utilizare sau ipoteze sau conjecturi despre ramificațiile știrilor.
Sub HARE, dacă nu vă place acest tip de material, puteți vota împotriva lui pe baza unui paragraf, în timp ce sistemul învață preferințele dvs., astfel încât, atunci când ajungeți la partea de jos, conținutul similar cu materialul pe care l-ați “downvotat” a fost deja eliminat sau rescris. Dacă nu doriți să participați activ la antrenarea sistemului, HARE poate deduce alegerile dvs. prin observarea interacțiunii dvs. pasive cu documentul.
Votarea în stil Tinder pentru propoziții neplăcute
În imaginea de mai jos, vedem trei tipuri posibile de categorizare inferată pentru HARE, pe baza comportamentului explicit sau implicit al utilizatorului. În primul caz (stânga), utilizatorul “swipează” activ spre stânga (sau spre dreapta), într-un gest de votare în stil Tinder, care exprimă aprobarea sau dezaprobarea conținutului paragrafului sau propoziției, sau a stilului, complexității sau tonului acestuia.

Sursă: https://arxiv.org/pdf/2105.02923.pdf
În al doilea caz (centru), sistemul utilizează timpul de ședere ca o metrică a interesului utilizatorului, pe baza poziționării și duratei pauzei de scroll.
În al treilea caz (dreapta), HARE utilizează camera smartphone-ului pentru a estima traseul și timpul de ședere al poziției privirii utilizatorului pe paragrafele documentului vizibil.
Cercetătorii susțin că o creștere a timpului de ședere pe orice paragraf poate indica un interes crescut al utilizatorului, deși logic acest lucru nu poate fi întotdeauna cazul în care utilizatorul încearcă să asimileze textul care poate fi complicat sau prost scris.

Feedback-ul utilizatorului editează, rescrie sau șterge porțiuni ale articolului care nu au fost încă vizualizate.
Pre-procesarea conținutului în funcție de preferințele utilizatorului
Articolul tratează experiența utilizatorului HARE pe baza unui articol, dar în mod evident, interacțiunea istorică a utilizatorului cu documentele permite personalizarea experienței de citire viitoare, prin recunoașterea consistentă a tipurilor de conținut și aplicarea preferințelor utilizatorului modelate la noi articole, astfel încât nevoia de interacțiune scade pe măsură ce utilizatorul vede din ce în ce mai puțin “conținut nedorit”.
HARE este caracterizat ca un algoritm de rezumat, care permite conținutul nevăzut de mai jos pe pagină să fie rescris în termeni de stil sau concizie înainte ca utilizatorul să ajungă la el; dar articolul face clar că poate să elimine și conținutul în mod preventiv pe baza feedback-ului utilizatorului.
Pentru testare, sistemul a utilizat un corpus de 11.222 de articole de la ziarul Daily Mail din Regatul Unit și a fost evaluat prin intermediul unei implementări de test pe aplicația de chat Telegram. Articolele cu mai puțin de zece paragrafe au fost eliminate în scopul testării.

Aplicația Telegram HARE într-o fază de testare cu utilizatori.
Metodologia cercetătorilor utilizează K-Means clustering pe SBERT încorporări de propoziții în articole, cu greutăți inițiale aleatorii pentru conceptele abordate.
Printre o gamă largă de algoritmi și abordări, HARE prezintă trei modele de comparație, primul dintre ele (ORACLEGREEDY) având acces la preferințele anterioare ale utilizatorului, indicând intenția ca algoritmul să poată pre-procesa articolele la încărcare, în loc de a interacționa în mod interactiv.
Celelalte modele, ORACLESORTED și ORACLEUNIFORM, selectează propoziții pe baza nivelului de interes sau aleatoriu în întregul articol, respectiv.
Eliminarea și rescrierea conținutului
Surprinzător, ORACLEUNIFORM a depășit setul de control, chiar dacă nu are acces la interesele anterioare ale utilizatorului. Cercetătorii susțin că acest lucru se datorează faptului că acesta se ocupă de întregul articol într-o singură operațiune, “alegând doar propozițiile cele mai interesante”. Cercetătorii admit că acest lucru poate restricționa conținutul disponibil la propoziții care se ocupă numai de conceptul cel mai important, eliminând logic alte texte care se pot ocupa de ramificații sau evaluări ale conceptului.
Rezumatorii extractivi utilizați în HARE sunt LexRank, SumBasic și TextRank.
HARE a fost testat pe 13 voluntari pe parcursul a 70 de încercări și abordări algoritmice diferite și a putut actualiza rezumatele (text rescris/eliminat) la un interval cuprins între 1,3 milisecunde și 100 ms pe un laptop de consum, în funcție de modelul testat. Rezultatele au arătat că modelele care au eliminat cel mai mult text nu au performant bine, în principal pentru că acest lucru poate afecta coerența textului rămas.
Implicații etice ale rescrierii dinamice a articolelor
Cercetătorii recunosc preocupările etice legate de tehnologii de acest tip:
‘Sarcina HARE este destinată proiectării de aplicații viitoare cu interfață utilizator. Prin proiectare, aceste aplicații au capacitatea de a controla ce citește un utilizator dintr-un anumit articol. Este posibil ca, atunci când sunt implementate fără îngrijire suficientă, aceste instrumente să exacerbeze efectul de “cameră de ecou” deja produs de fluxurile de știri automate, rezultatele căutării și comunitățile online.’
Cu toate acestea, ei notează și că un astfel de sistem ar putea fi utilizat în aplicații viitoare pentru a mitigă efectul de cameră de ecou prin injectarea de texte care propun puncte de vedere alternative care nu ar fi fost inițial prezente în articol. Ei observă: ‘Greutatea acestui factor poate fi reglată pentru a oferi atât o experiență de citire plăcută, cât și expunerea la o diversitate de idei.’
Cei care sunt probabil să beneficieze de un astfel de sistem, conform cercetătorilor, sunt cititorii care doresc să economisească timp în asimilarea informațiilor și editorii de conținut.
în articol. Ei observă: ‘Greutatea acestui factor poate fi reglată pentru a oferi atât o experiență de citire plăcută, cât și expunerea la o diversitate de idei.’
Cei care sunt probabil să beneficieze de un astfel de sistem, conform cercetătorilor, sunt cititorii care doresc să economisească timp în asimilarea informațiilor și editorii de conținut.


