
AGI e IA do futuro
O que é o Teste de Turing e Por que Ele Importa?

 Adicione Unite.AI às suas fontes preferidas no Google
O teste de Turing surgiu do artigo de 1950 de Alan Turing “Computing Machinery and Intelligence”. Em vez de tentar definir o pensamento, Turing propôs um jogo de imitação: um interrogador humano troca mensagens escritas com participantes invisíveis e julga qual é humano e qual é máquina.
O teste continua influente porque transforma uma questão filosófica abstrata em uma interação observável. Também tem limitações: parecer humano em uma conversa não é o mesmo que ser veraz, conhecedor, seguro, consciente ou geralmente inteligente.
Principais conclusões
- O jogo de imitação original de Turing é um teste comportamental baseado em texto, não uma lista de verificação de propriedades cognitivas internas.
- Os resultados dependem do avaliador, do prompt, da duração, das instruções dos participantes e da regra de pontuação.
- Um modelo pode imitar a conversa humana enquanto alucina fatos ou falha em testes simples de robustez.
- A avaliação moderna necessita de métricas de tarefa, testes adversariais, revisão humana e evidências específicas de risco, além da conversa.
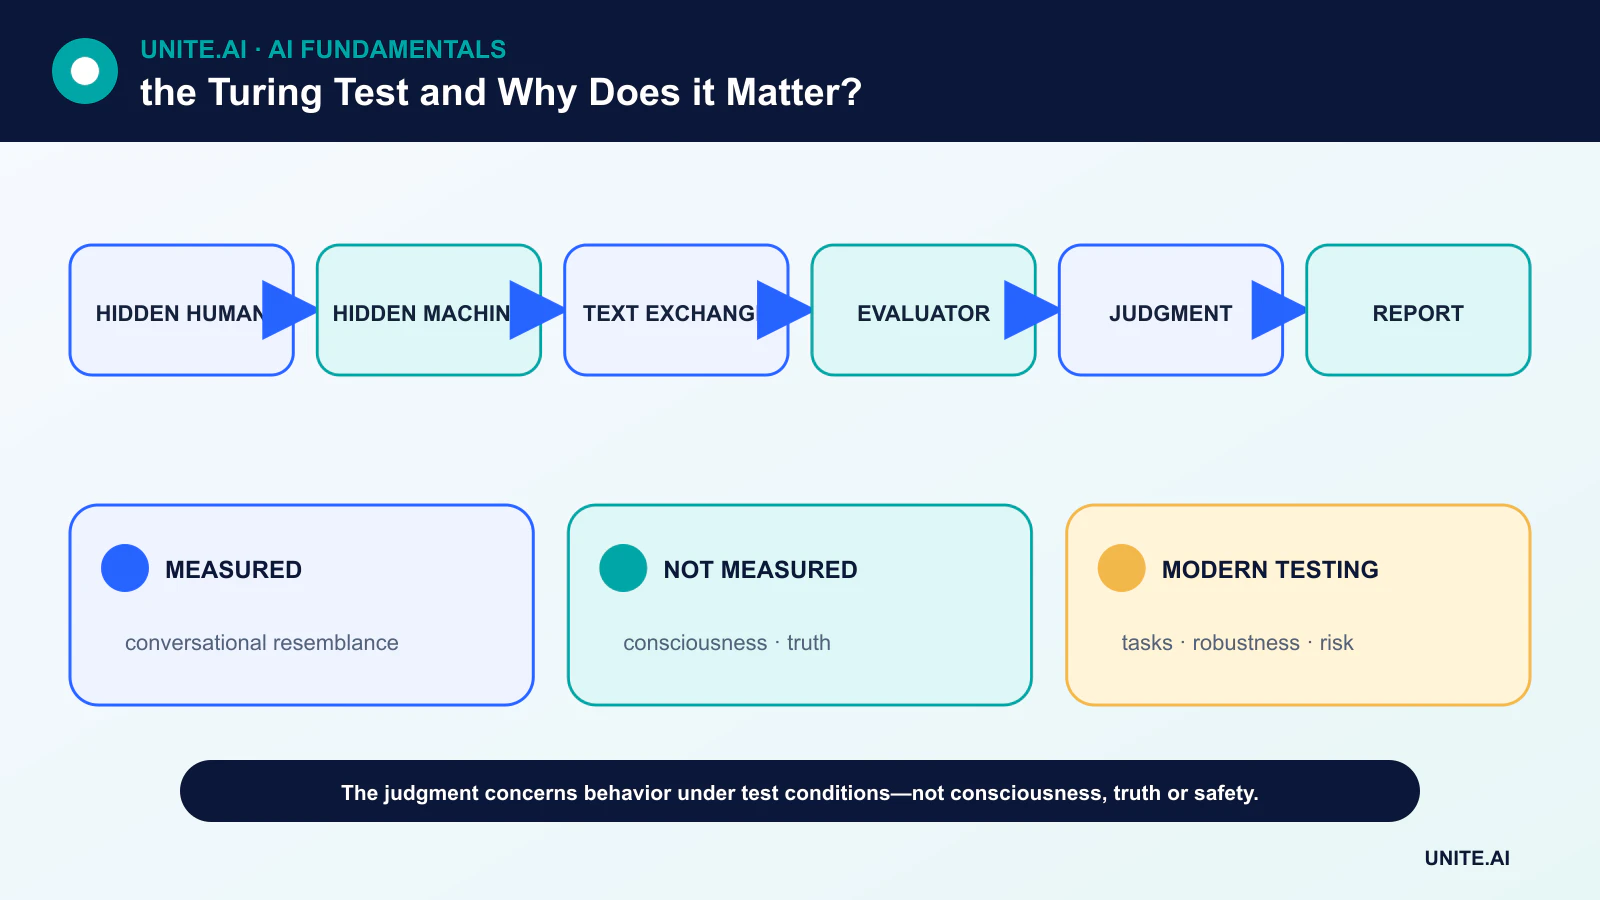
Jogo de imitação de Turing
Na configuração original, um interrogador comunicava-se à distância para que voz e aparência não revelassem a identidade. Turing questionou se uma máquina poderia desempenhar suficientemente bem no jogo a ponto de um avaliador não conseguir distingui‑la de uma pessoa de forma confiável.
Essa formulação operacional evitou a necessidade de definir o que é pensar. Não afirmava que toda troca convincente prova inteligência, nem especificava um limite universal de aprovação aplicável a qualquer demonstração posterior de chatbot.
O que um resultado realmente mede
Um teste mede a indistinguibilidade comportamental sob condições definidas. Conversas curtas, juízes inexperientes ou prompts escolhidos pelo desenvolvedor do sistema podem facilitar a tarefa. Um relatório rigoroso deve divulgar a seleção de transcrições, o número e o histórico dos juízes, os humanos de comparação, o limite de tempo e o método estatístico.
Um sistema também pode explorar expectativas: evasividade, humor, erros tipográficos e interpretação de papéis podem parecer humanos sem demonstrar raciocínio confiável. Por outro lado, uma resposta humana incomumente formal pode ser classificada erroneamente como gerada por máquina.
O que o teste de Turing não estabelece
O teste não mede diretamente a consciência, a experiência subjetiva, a precisão factual, a compreensão causal ou a agência moral. Não revela os dados de treinamento, a arquitetura do modelo ou os modos de falha fora da conversa. Também diz pouco sobre inteligência não linguística, como manipulação física.
Os sistemas de linguagem modernos são construídos com redes neurais transformer e aprendizado profundo, mas suas respostas fluentes ainda podem ser geradas a partir de estruturas estatísticas aprendidas, em vez de um modelo de mundo verificado.
Como a avaliação moderna de IA expande a questão
A avaliação contemporânea utiliza conjuntos de tarefas reservados, incerteza calibrada, testes de robustez, red teaming, verificações de factualidade e estudos de preferência humana. Uma métrica de classificação de texto pode testar um comportamento definido, enquanto a avaliação baseada em cenários pode verificar se um sistema segue a política sob pressão.
Nenhum benchmark único captura todas as implantações. A contaminação de testes pode inflar pontuações, e benchmarks estáticos incentivam overfitting. A avaliação deve ser repetida à medida que modelos, dados, prompts, ferramentas e populações de usuários mudam.
Por que o teste ainda importa
O teste de Turing antecipou uma lição central da avaliação de IA: avaliar a capacidade observável em vez de confiar em afirmações sobre uma essência interna. Também nos obriga a questionar quais comportamentos humanos contam como evidência e como um arranjo experimental molda uma conclusão.
Seu melhor uso moderno é como referência histórica e conceitual. Passar em um jogo de imitação pode ser interessante, mas decisões de implantação exigem evidências vinculadas à tarefa real, aos usuários afetados e aos danos previsíveis.
O que o Teste de Turing mede
O jogo de imitação de Alan Turing perguntou se um interrogador que se comunica por texto poderia distinguir de forma confiável uma máquina de uma pessoa. Reenquadrou um debate abstrato sobre se máquinas pensam em um experimento conversacional observável. O teste depende de participantes, duração, protocolo, tópicos e regra de julgamento; não há uma pontuação universal única. Passar significa produzir respostas semelhantes às humanas sob essa configuração. Não mede diretamente a precisão factual, o raciocínio, a consciência, a autonomia, a percepção, a incorporação, a confiabilidade ou o comportamento benéfico no mundo real.
A imitação humana pode recompensar evasão, persona, erros, humor ou manipulação. Um juiz pode confundir um humano com uma máquina ou ser influenciado por expectativas, idioma e contexto cultural. Conversas curtas permitem truques que falham em interações prolongadas. Por outro lado, um sistema altamente útil para matemática, tradução ou modelagem de proteínas pode falhar porque não finge ser humano. Portanto, o teste mede uma capacidade social e linguística moldada pelo avaliador, não uma classificação completa de inteligência.
Modelos de linguagem modernos e avaliação mais robusta
Modelos de linguagem de grande porte podem manter diálogos fluentes ao prever sequências a partir de amplos dados de treinamento e ajuste posterior, mas a fluência é evidência fraca de verdade ou compreensão. Padrões memorizados, acesso a ferramentas, prompts ocultos, latência e configurações de amostragem afetam os resultados. Avaliações controladas devem divulgar o modelo e o protocolo, prevenir vazamento de informações, incluir perguntas adversariais e de domínio, e pontuar incerteza e citação. Uma demonstração selecionada entre conversas bem‑sucedidas não pode estimar a confiabilidade em toda a distribuição de uso.
A avaliação moderna é multidimensional: precisão de tarefa, calibração, robustez, consistência a longo prazo, segurança, viés, privacidade, segurança, eficiência e resultados humanos. Testes comportamentais devem ser complementados por evidências de processo, red teaming, benchmarks reproduzíveis e monitoramento no mundo real. Benchmarks podem saturar ou entrar nos dados de treinamento, portanto são necessários conjuntos de teste privados e atualizados. Para sistemas que atuam, avalie permissões de ferramentas, recuperação e consequências separadamente da qualidade da conversa.
Por que o teste ainda importa
O Teste de Turing continua historicamente importante porque centra-se no comportamento e na dificuldade de definir inteligência. Também suscita questões contínuas sobre antropomorfismo e engano. As interfaces devem identificar agentes sintéticos em vez de tratar a identidade equivocada como sucesso, especialmente em contextos críticos. Use o teste como uma lente filosófica e como uma avaliação conversacional, não como certificação de inteligência geral ou personalidade. A questão crucial de implantação é o que o sistema pode fazer de forma confiável, com que evidências e limites, e quem é responsável quando falha.
Exemplo prático: uma avaliação conversacional controlada
Os avaliadores comparam humanos e vários sistemas de IA em conversas de texto com duração, tópicos, idioma e identidades ocultas fixos. Os juízes registram se acreditam que cada participante é humano e também pontuam factualidade, consistência, utilidade, incerteza e manipulação. Vários juízes e conversas estimam a variação, e o protocolo impede que desenvolvedores de modelos selecionem transcrições favoráveis. A classificação errônea de humanos fornece uma linha de base necessária para interpretar o resultado.
Um sistema que engana os juízes mas inventa fatos não é declarado geralmente inteligente, enquanto um modelo especializado claramente divulgado pode ser altamente útil apesar de falhar na imitação. Os resultados incluem prompt, modelo, sampler, acesso a ferramentas e características do juiz. O experimento é enquadrado como um teste de conversa semelhante à humana. Decisões de implantação utilizam evidências separadas para correção da tarefa, segurança, privacidade e recuperação, e a interface identifica o agente em vez de transformar o engano no objetivo do produto.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, interrupção de dependências, uso indevido e os grupos ou ambientes mais propensos a ficarem desatendidos. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversões e aposentadoria. Use um lançamento em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, o comportamento da saída, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e os resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, então revise as evidências do mundo real após a implantação em vez de supor que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Alguma IA passou definitivamente no teste de Turing?
Não existe uma autoridade oficial única de teste ou um protocolo universalmente aceito. Demonstrações públicas utilizam regras diferentes, portanto as alegações de “passou” não são diretamente comparáveis.
Falhar no teste prova que um sistema é não inteligente?
Não. Um sistema especializado pode ser altamente capaz sem imitar o estilo de conversa humano.
Referências principais












