
AGI e IA do futuro
O Papel dos Bancos de Dados Vetoriais em Aplicações de Inteligência Artificial Gerativa Modernas

 Adicione Unite.AI às suas fontes preferidas no Google

Pontos-chaveOs bancos de dados vetoriais permitem buscas rápidas por similaridade em dados de alta…
Ver mais
- Os bancos de dados vetoriais permitem buscas rápidas por similaridade em dados de alta dimensão, como embeddings, um requisito fundamental para aplicações eficazes de IA Generativa.
- Grandes empresas de tecnologia, como Microsoft e Oracle, estão investindo em capacidades de banco de dados vetoriais para alimentar ferramentas de IA e Geração Aumentada por Recuperação (RAG).
- Os bancos de dados vetoriais transformam a busca de correspondência por palavras-chave em recuperação semântica, compreendendo a intenção do usuário em texto, imagens e áudio.
Para que as aplicações de Inteligência Artificial Gerativa em larga escala funcionem efetivamente, é necessário um bom sistema para lidar com uma grande quantidade de dados. Um desses sistemas importantes é o banco de dados vetorial. O que distingue esse banco de dados é sua capacidade de lidar com muitos tipos de dados, como texto, som, imagens e vídeos, em forma de número/vetor.
O que são Bancos de Dados Vetoriais?
O banco de dados vetorial é um sistema de armazenamento especializado projetado para lidar com vetores de alta dimensionalidade de forma eficiente. Esses vetores, que podem ser pensados como pontos em um espaço multi-dimensional, frequentemente representam embeddings ou representações comprimidas de dados mais complexos, como imagens, texto ou som.
Os bancos de dados vetoriais permitem buscas de similaridade rápidas entre esses vetores, permitindo a recuperação rápida dos itens mais semelhantes de um vasto conjunto de dados.
Bancos de Dados Tradicionais vs. Bancos de Dados Vetoriais
Bancos de Dados Vetoriais:
- Lidar com Dados de Alta Dimensionalidade: Os bancos de dados vetoriais são projetados para gerenciar e armazenar dados em espaços de alta dimensionalidade. Isso é particularmente útil para aplicações como aprendizado de máquina, onde os pontos de dados (como imagens ou texto) podem ser representados como vetores em espaços multi-dimensionais.
- Otimizados para Busca de Similaridade: Uma das características mais destacadas dos bancos de dados vetoriais é sua capacidade de realizar buscas de similaridade. Em vez de consultar dados com base em correspondências exatas, esses bancos de dados permitem que os usuários recuperem dados que são “semelhantes” a uma consulta dada, tornando-os inestimáveis para tarefas como recuperação de imagens ou texto.
- Escalabilidade para Conjuntos de Dados Grandes: À medida que as aplicações de Inteligência Artificial e aprendizado de máquina continuam a crescer, também cresce a quantidade de dados que elas processam. Os bancos de dados vetoriais são projetados para escalar, garantindo que eles possam lidar com vastas quantidades de dados sem comprometer o desempenho.
Bancos de Dados Tradicionais:
- Armazenamento de Dados Estruturados: Os bancos de dados tradicionais, como os bancos de dados relacionais, são projetados para armazenar dados estruturados. Isso significa que os dados são organizados em tabelas, linhas e colunas pré-definidas, garantindo a integridade e consistência dos dados.
- Otimizados para Operações CRUD: Os bancos de dados tradicionais são primariamente otimizados para operações CRUD (criar, ler, atualizar e excluir). Isso significa que eles são projetados para criar, ler, atualizar e excluir entradas de dados de forma eficiente, tornando-os adequados para uma ampla gama de aplicações, desde serviços web até software empresarial.
- Esquema Fixo: Uma das características definidoras de muitos bancos de dados tradicionais é seu esquema fixo. Uma vez que a estrutura do banco de dados é definida, fazer alterações pode ser complexo e demorado. Essa rigidez garante a consistência dos dados, mas pode ser menos flexível do que a natureza sem esquema ou dinâmica de alguns bancos de dados modernos.
Os bancos de dados tradicionais frequentemente têm dificuldade para lidar com a complexidade dos embeddings, um desafio que os bancos de dados vetoriais conseguem resolver.
Representações vetoriais
A base do funcionamento dos bancos de dados vetoriais é a representação de diferentes formas de dados por meio de vetores numéricos. Uma foto de um gato, por exemplo, pode parecer apenas uma imagem de um felino para nós, mas, para uma máquina, pode ser transformada em um vetor único de 512 dimensões, como:
[0.23, 0.54, 0.32, …, 0.12, 0.45, 0.90]
Com bancos de dados vetoriais, aplicações de IA generativa podem encontrar informações com base no significado e conservar informações por longos períodos. Isso não se limita a imagens: dados textuais com significado contextual e semântico também podem ser representados por vetores.
Inteligência Artificial Gerativa e a Necessidade de Bancos de Dados Vetoriais
A Inteligência Artificial Gerativa frequentemente envolve embeddings. Por exemplo, embeddings de palavras em processamento de linguagem natural (NLP). As palavras ou frases são transformadas em vetores que capturam o significado semântico. Ao gerar texto semelhante ao produzido por humanos, os modelos precisam comparar e recuperar rapidamente embeddings relevantes, garantindo que o texto gerado mantenha significados contextuais.
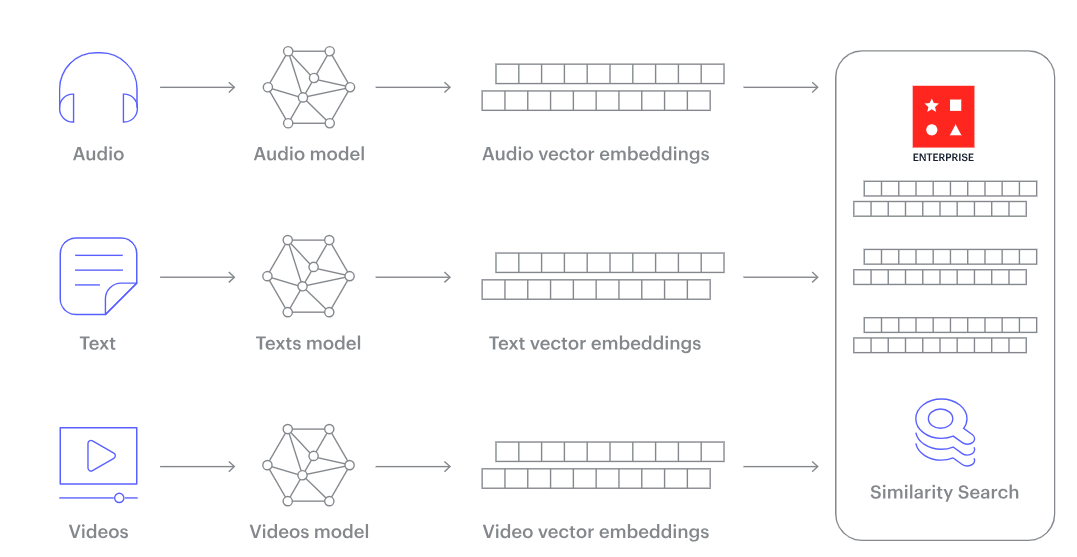
Da mesma forma, na geração de imagens ou sons, os embeddings desempenham um papel essencial na codificação de padrões e características. Para funcionar de maneira ideal, esses modelos precisam de um banco de dados que permita recuperar instantaneamente vetores semelhantes. Por isso, os bancos de dados vetoriais são um componente importante da IA generativa.
A criação de embeddings para linguagem natural geralmente utiliza modelos pré-treinados, como:
- GPT-3 e GPT-4: O GPT-3 da OpenAI (Generative Pre-trained Transformer 3), com 175 bilhões de parâmetros, marcou a área de processamento de linguagem natural. O artigo apresenta o GPT-4, seu sucessor, como um modelo ainda maior que amplia as possibilidades de gerar embeddings de alta qualidade. Esses modelos são treinados em conjuntos de dados variados, permitindo representar muitas nuances linguísticas.
- BERT e suas variantes: O BERT (Bidirectional Encoder Representations from Transformers), do Google, é outro modelo importante, com variantes como RoBERTa e DistilBERT. Seu treinamento bidirecional considera o texto nas duas direções, sendo especialmente útil para entender o contexto de uma palavra.
- ELECTRA: Modelo mais recente e eficiente, descrito no artigo como comparável a modelos maiores, como GPT-3 e BERT, com menor necessidade de recursos computacionais. O ELECTRA distingue dados reais de dados substituídos durante o pré-treinamento, contribuindo para representações mais refinadas.

O processo funciona assim: primeiro, um modelo transforma o conteúdo desejado em embeddings vetoriais. Eles são armazenados em um banco de dados vetorial, mantendo uma referência ao conteúdo original para facilitar sua rastreabilidade e relevância.
Quando um usuário ou sistema faz uma pergunta à aplicação, o mesmo modelo converte a consulta em embeddings. Esses vetores são usados para buscar representações semelhantes no banco de dados. Como os resultados mantêm uma ligação com o conteúdo original, a aplicação pode fornecer informações relevantes e precisas.
Crescimento dos investimentos em novas empresas de bancos de dados vetoriais
Com a popularidade crescente da IA, muitas empresas investem mais em bancos de dados vetoriais para melhorar e acelerar seus algoritmos. Isso aparece nos investimentos em startups como Pinecone, Chroma DB e Weaviate.

Grandes empresas, como a Microsoft (MSFT ), também possuem ferramentas próprias. O Azure Cognitive Search, por exemplo, permite que empresas criem ferramentas de IA usando bancos de dados vetoriais.
A Oracle (ORCL ) também anunciou novos recursos para seu Database 23c, introduzindo um banco de dados vetorial integrado. A função AI Vector Search prevê um novo tipo de dados, índices e ferramentas para armazenar e pesquisar documentos e imagens usando vetores. Ela oferece suporte à geração aumentada por recuperação (RAG), que combina grandes modelos de linguagem com dados empresariais para responder melhor às perguntas sem compartilhar dados privados.
Considerações Principais dos Bancos de Dados Vetoriais
Métricas de Distância
A eficácia de uma busca de similaridade depende da métrica de distância escolhida. Métricas comuns incluem distância euclidiana e similaridade cosseno, cada uma atendendo a diferentes tipos de distribuições de vetores.
Indexação
Dada a alta dimensionalidade dos vetores, os métodos de indexação tradicionais não são suficientes. Os bancos de dados vetoriais usam técnicas como grafos HNSW (Hierarchical Navigable Small World) ou árvores Annoy, permitindo a partição eficiente do espaço vetorial e buscas de vizinhos mais próximos rápidas.

Árvore Annoy (Fonte)
O Annoy utiliza árvores binárias de busca. Ele divide o espaço de dados várias vezes e examina apenas uma parte dele para encontrar vizinhos próximos.
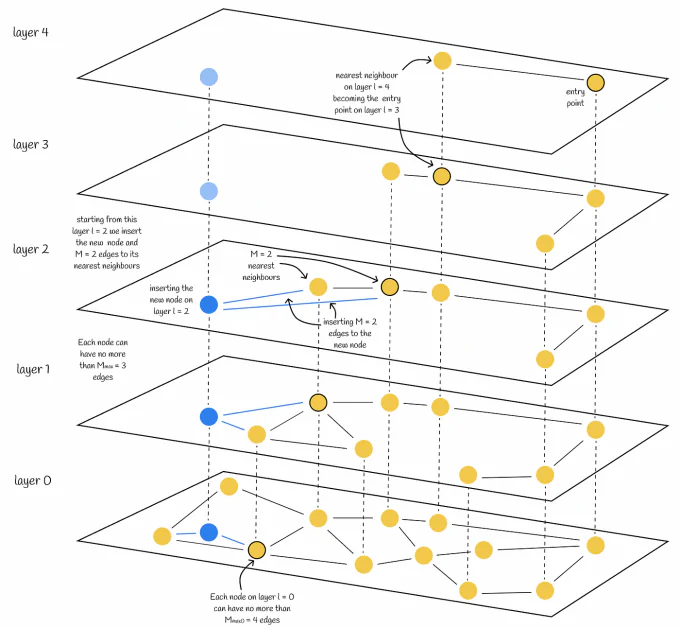
Grafos Hierarchical Navigable Small World (HNSW) (Fonte)
Os grafos HNSW, por sua vez, se assemelham a redes. Eles conectam pontos de dados de uma maneira específica para acelerar as buscas e localizar rapidamente pontos próximos.
Escalabilidade
À medida que os conjuntos de dados crescem, também cresce o desafio de manter tempos de recuperação rápidos. Sistemas distribuídos, aceleração por GPU e gerenciamento de memória otimizado são algumas das maneiras pelas quais os bancos de dados vetoriais lidam com a escalabilidade.
Papel dos Bancos de Dados Vetoriais: Implicações e Oportunidades
1. Dados de treinamento para modelos avançados de IA generativa: Os modelos de Inteligência Artificial Gerativa, como DALL-E e GPT-3, são treinados usando vastas quantidades de dados. Esses dados frequentemente consistem em vetores extraídos de uma miríade de fontes, incluindo imagens, textos, código e outros domínios. Os bancos de dados vetoriais selecionam cuidadosamente e gerenciam esses conjuntos de dados, permitindo que os modelos de Inteligência Artificial assimilem e analisem o conhecimento do mundo, identificando padrões e relações dentro desses vetores.
2. Avanço no aprendizado com poucos exemplos: O aprendizado de poucos exemplos é uma técnica de treinamento de Inteligência Artificial onde os modelos são treinados com dados limitados. Os bancos de dados vetoriais ampliam essa abordagem, mantendo um índice de vetores robusto. Quando um modelo é exposto a apenas alguns vetores – digamos, algumas imagens de pássaros – ele pode rapidamente extrapolar o conceito mais amplo de pássaros, reconhecendo similaridades e relações entre esses vetores.
3. Melhoria dos Sistemas de Recomendação: Os sistemas de recomendação usam bancos de dados vetoriais para sugerir conteúdo alinhado com as preferências do usuário. Analisando o comportamento, perfil e consultas do usuário, os vetores indicativos de seus interesses são extraídos. O sistema então varre o banco de dados vetorial para encontrar vetores de conteúdo que se assemelham a esses vetores de interesse, garantindo recomendações precisas.
4. Recuperação semântica de informações: Os métodos de busca tradicionais dependem de correspondências exatas de palavras-chave. No entanto, os bancos de dados vetoriais permitem que os sistemas entendam e recuperem conteúdo com base na similaridade semântica. Isso significa que as buscas se tornam mais intuitivas, focando no significado subjacente da consulta, e não apenas na combinação de palavras. Por exemplo, o vetor de uma consulta é comparado com os vetores do banco de dados para encontrar conteúdo que corresponda à intenção do usuário, e não somente à sua formulação.
5. Busca multimodal: A busca multimodal é uma técnica emergente que integra dados de múltiplas fontes, como texto, imagens, áudio e vídeo. Os bancos de dados vetoriais servem como a espinha dorsal dessa abordagem, permitindo a análise combinada de vetores de diferentes modalidades. Isso resulta em uma experiência de busca holística, onde os usuários podem recuperar informações de uma variedade de fontes com base em uma única consulta, levando a insights mais ricos e resultados mais abrangentes.
Conclusão
O mundo da Inteligência Artificial está mudando rapidamente. Está tocando muitas indústrias, trazendo benefícios e novos desafios. Os avanços rápidos na Inteligência Artificial Gerativa destacam o papel vital dos bancos de dados vetoriais no gerenciamento e análise de dados multi-dimensionais.
Esses sistemas especializados de armazenamento, capazes de lidar com vetores de alta dimensionalidade derivados de imagens, texto ou som, são fundamentais para o funcionamento eficiente das aplicações modernas de IA, especialmente na busca por similaridade.
Sua importância crescente também é demonstrada pelos investimentos no setor, com startups como a Pinecone e gigantes como a Microsoft contribuindo ativamente para os avanços.


