
Entrevistas
Ben Koska, Fundador e CEO da SF Tensor – Série de Entrevistas

 Adicione Unite.AI às suas fontes preferidas no Google
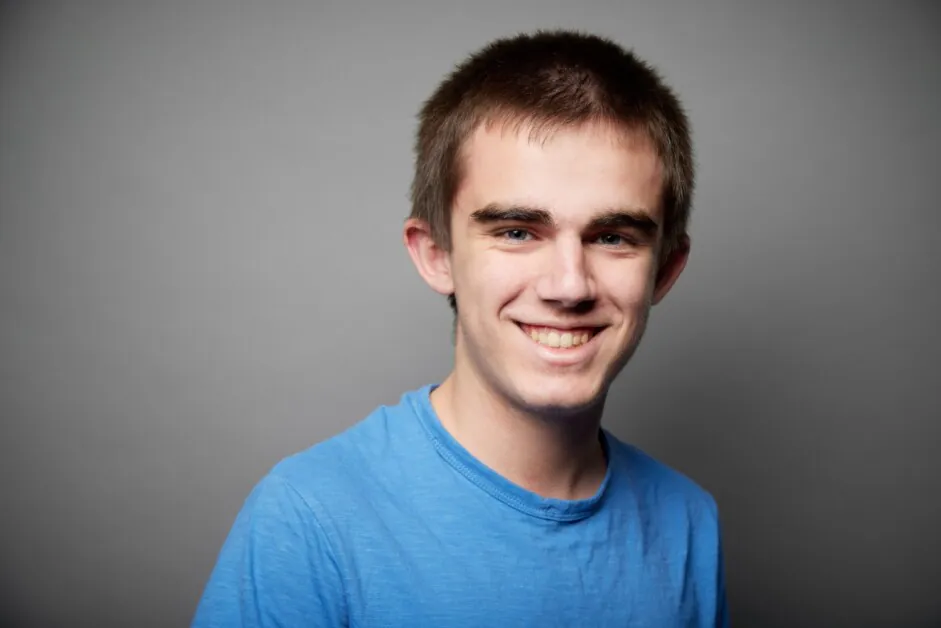
Ben Koska, Fundador e CEO da SF Tensor, é um pesquisador de IA e engenheiro de sistemas conhecido por seu trabalho em computação de alto desempenho, otimização de kernel e treinamento de modelos eficientes. Sua formação abrange o desenvolvimento de infraestrutura de IA de baixo nível, melhoria do throughput de treinamento e design de ferramentas que tornam o desenvolvimento de modelos avançados acessível sem sobrecarga de engenharia pesada. Ele se concentra em construir sistemas que impulsionam os limites de velocidade, portabilidade e confiabilidade em hardware heterogêneo.
SF Tensor é a empresa que ele lidera para transformar essa filosofia em uma plataforma prática. Ela introduz um modelo de programação unificado, um otimizador de kernel e uma camada de orquestração de nuvem cruzada projetada para remover a complexidade de cargas de trabalho de IA distribuída. A plataforma tem como objetivo fornecer aos engenheiros um ambiente limpo e independente de hardware, onde eles possam escrever uma vez, implantar em qualquer lugar e alcançar automaticamente um alto desempenho. A missão da SF Tensor é tornar o cálculo de IA dramaticamente mais rápido, mais fácil de gerenciar e livre de bloqueio de fornecedor.
Você fundou a SF Tensor com apenas 19 anos de idade, após liderar a engenharia em várias startups. O que o inspirou a enfrentar o desafio de reinventar a infraestrutura de IA tão cedo em sua carreira?
O problema que estamos resolvendo é um que eu me preocupo profundamente, porque é um que eu mesmo encontrei. Quando desenvolvemos o que agora é a pilha central da SF Tensor, não estávamos trabalhando em um projeto comercial, era um empreendimento acadêmico. Nós havíamos recebido uma bolsa para realizar uma pesquisa interessante, mas passamos a maior parte do tempo lidando com infraestrutura e otimizações, em vez de realizar a pesquisa. Descobrimos que as pessoas estavam universalmente mais interessadas em nossa tecnologia de infraestrutura, e não em nosso projeto de pesquisa.
A SF Tensor está lidando com um dos problemas mais difíceis em IA — romper a dominância da CUDA da NVIDIA. Como você abordou o design de um sistema que pudesse alcançar uma verdadeira portabilidade de hardware sem comprometer o desempenho?
No final do dia, toda a IA se resume a matemática simples. Cada modelo é essencialmente um conjunto de operações matemáticas que precisamos calcular os resultados. Ao tratá-lo principalmente como um problema matemático, em vez de um problema de ciência da computação, podemos identificar o menor conjunto de restrições nos cálculos, então gerar milhões a bilhões de diferentes maneiras de transformar esses cálculos em código de máquina, encontrando o mais rápido. Isso é mais fácil de dizer do que fazer, pois não podemos realmente executar bilhões de diferentes programas para encontrar o mais rápido, então para podar nosso espaço de busca, tivemos que criar um modelo matemático preciso para estimar a velocidade de um determinado programa para um determinado hardware, o que é uma das inovações principais que tornam o que fazemos possível hoje.
O blog da empresa destaca inovações em torno da otimização de compilador e orquestração de nuvem cruzada. Você pode explicar como a abordagem da SF Tensor difere de frameworks existentes como PyTorch ou JAX?
Nós ainda não escrevemos um blog técnico sobre isso, mas na verdade suportamos frameworks como PyTorch e JAX, permitindo que o código escrito neles seja otimizado por nossa pilha. Existem várias decisões arquitetônicas que JAX e PyTorch fizeram que os diferenciam de nossa pilha, mas a mais significativa é que tratamos o modelo inteiro como um único cálculo a ser resolvido, em vez de módulos individuais que devem ser otimizados individualmente e, em seguida, conjuntamente. Nesse sentido, em vez de aplicar técnicas tradicionais de otimização de compilador e tentar aplicar cada otimização individual, criamos um espaço de busca de milhões a, às vezes, bilhões de kernels potenciais e afirmamos que nenhum ser humano pode possivelmente criar um conjunto de regras para transformar qualquer código dado no mais rápido, então devemos, em vez disso, criar todas as combinações e, em seguida, identificar o mais rápido.
Muitas startups estão focadas na eficiência de treinamento, mas você enfatizou a “taxa de infraestrutura” — o tempo que os pesquisadores perdem gerenciando o cálculo em vez de inovar. Como a SF Tensor aborda esse desequilíbrio?
Acreditamos que ambos os problemas devem ser abordados, e muito do nosso trabalho vai para abordar a eficiência de treinamento, mas o problema mais agudo que podemos resolver agora, sem depender de inovações futuras, é a taxa de infraestrutura, pois é um problema que já resolvemos para nós mesmos.
Você mencionou alcançar reduções de até 80% nos custos de treinamento. Quais otimizações ou inovações arquitetônicas específicas tornam isso possível?
Nossa pilha de software inteira é baseada na ideia de que um compilador baseado em busca sempre superará regras criadas por humanos. Até agora, a maior restrição desses compiladores foi o fato de que não é possível benchmarkar e classificar bilhões ou mesmo milhões de kernels. Foi, portanto, necessário para nós criar um modelo matemático de cálculo que possa estimar com precisão o tempo que um determinado cálculo, ou conjunto de cálculos, levará em um determinado hardware. Ao fazer isso, podemos expandir nosso espaço de busca e, em seguida, reduzi-lo, o que é uma necessidade se você quiser encontrar os kernels mais rápidos consistentemente.
Como sua formação em construir a linguagem de programação Emma influencia a arquitetura e a filosofia da SF Tensor em relação ao desempenho e à abstração?
Não conte aos meus investidores, mas no fundo, eu ainda sou um engenheiro de compilador. Eu sempre estive interessado em encontrar maneiras diferentes de tornar as coisas apenas um pouco mais rápidas. Ao desenvolver Emma, jogamos fora o compilador inteiro 4 ou 5 vezes; começamos do zero, cada vez porque encontramos uma otimização que não podíamos implementar, dadas as restrições atuais, forçando-nos a reengenharia do sistema para ser ainda mais geral, enquanto ainda permitia que dropássemos para o nível mais baixo de otimização quando necessário, muitas vezes indo contra os princípios comuns de design de compilador e linguagem. Essas lições e a arquitetura resultante combinaram quase dois anos do que parecia para muitos como otimizações menores e apostas erradas, que se somaram a um sistema que agora nos permite iterar mais rápido e otimizar melhor do que qualquer um dos sistemas que seguiram os princípios comuns, porque esses princípios são fundamentalmente projetados para CPUs, não GPUs e modelos de IA.
Você trabalhou em execuções de treinamento em larga escala em mais de 4.000 GPUs — quais foram as principais lições aprendidas com a gestão do cálculo nessa escala?
Uma grande lição é que a falha de hardware é muito mais comum e problemática do que se pode supor. Tendo passado muito tempo trabalhando com programas tradicionais e compiladores, geralmente, um computador faz exatamente o que é dito, e se algo dá errado, é quase sempre culpa da pessoa que escreveu o código. Com GPUs, por outro lado, a falha de hardware é uma ocorrência comum, especialmente em treinamentos distribuídos em clusters extremamente grandes. Vai de mãos dadas com isso o fato de que, ao contrário das CPUs que geralmente agem de maneira determinística e previsível, as GPUs às vezes inexplicavelmente fazem coisas como reduzir as velocidades do relógio por nenhum motivo aparente, desacelerando todo o processo de treinamento porque um único chip está executando mais lentamente.
Y Combinator apoiou algumas das empresas de infraestrutura mais transformadoras da tecnologia. Como essa experiência moldou sua abordagem para escalar o produto e a visão da SF Tensor?
Antes de entrar no Y Combinator, pensei que a aposta que queríamos fazer na época era ambiciosa. Depois de apenas algumas semanas, nossa definição de ambicioso havia mudado drasticamente, e dobramos a aposta em uma aposta ainda maior. Além disso, o senso de comunidade e aprendizado que eu posso pegar o telefone ou enviar um e-mail para praticamente qualquer empresa ou pessoa lá fora e receber uma resposta e conselho dentro de um período de horas a dias, mudou a forma como pensamos em abordar problemas e adotar uma abordagem significativamente mais colaborativa.
Olhando para o futuro, você expressou interesse em modelos não LLM, robótica e dados sintéticos. Como essas áreas se encaixam em sua visão de longo prazo para a empresa?
Os LLMs são absolutamente uma tecnologia interessante e terão uma parte integral em como o mundo será no futuro, mas o motivo pelo qual eles estão tão mais avançados do que qualquer outra área de IA decorre principalmente do fato de que há muito dinheiro sendo investido em seu desenvolvimento, e há pessoas suficientes colaborando no problema para que tenham se tornado razoavelmente otimizados. Suponha que possamos reduzir a barreira de entrada, permitindo que os pesquisadores em todo o país e planeta, mesmo aqueles com recursos limitados e pouco ou nenhum conhecimento em otimizações, realizem suas pesquisas de forma barata e eficiente. Nesse caso, acredito que veremos uma nova geração de modelos surgir que abordarão problemas para os quais os LLMs não são adequados, seja porque interagem com o mundo físico ou porque são problemas que não podem ser expressos adequadamente em linguagem.
O que você acha que a pilha de infraestrutura de IA parecerá dentro de cinco anos — e onde você vê o papel da SF Tensor nela?
Daqui a cinco anos, espero que muitas mais empresas terão desenvolvido e lançado seus próprios chips especializados, e que os pesquisadores poderão aproveitar e utilizar sem precisar escrever código especificamente para eles, idealmente sem precisar saber que eles existem. Esse é o futuro que estamos trabalhando para alcançar e que acredito que teremos um papel significativo em moldar.
Obrigado pela ótima entrevista, leitores que desejam aprender mais devem visitar SF Tensor.


