
Ângulo de Anderson
Um ‘Detetive’ IA Pode Identificar Pessoas Obscuras a Partir de Múltiplas Fontes

 Adicione Unite.AI às suas fontes preferidas no Google

Pesquisadores da Universidade de Oxford desenvolveram um sistema habilitado por IA que pode identificar pessoas em vídeos de forma abrangente, realizando investigações multi-domínio, semelhantes às de um detetive, para descobrir quem elas podem ser, a partir do contexto e de uma variedade de fontes secundárias publicamente disponíveis, incluindo a correspondência de fontes de áudio com material visual da internet.
Embora a pesquisa se concentre na identificação de figuras públicas, como pessoas que aparecem em programas de televisão e filmes, o princípio de inferir a identidade a partir do contexto é teoricamente aplicável a qualquer pessoa cujo rosto, voz ou nome apareça em fontes online.
De fato, a publicação própria define a fama como não limitada a trabalhadores do show business, com os pesquisadores declarando ‘Denominamos pessoas com muitas imagens de si mesmas online como famosas‘.
Direto para o Vídeo
Os pesquisadores, do Grupo de Geometria Visual da Universidade de Oxford, no Departamento de Ciência de Engenharia, descrevem a abordagem de investigação humana que inspirou o trabalho:
‘Imagine que você está assistindo a um vídeo e encontra uma nova pessoa. Para identificá-la com confiança, você primeiro procuraria pistas de seu nome, seja no vídeo, como texto na tela, seu nome sendo mencionado em uma fala, ou em uma lista de membros do elenco de um arquivo da internet. Você poderia então encontrar alguma evidência para verificar que esse nome é correto, procurando a pessoa online.’
A metodologia proposta pelo artigo é completamente automatizada e elimina todas as marcações manuais adicionais (descontando qualquer uma que tenha sido realizada pelos fornecedores das fontes online). O sistema também foi comprovado para funcionar bem em três conjuntos de dados não relacionados sem a necessidade de adaptação de domínio.
Discutindo a aplicação do trabalho, os pesquisadores notam o crescimento exponencial de dados de vídeo não rotulados e opacos, e a necessidade de novos sistemas que possam derivar informações de identidade a partir deles sem anotações humanas caras:
‘[A] escala dos dados, combinada com a falta de metadados relevantes, torna a indexação, análise e navegação desse conteúdo uma tarefa cada vez mais difícil. Confiar em anotações manuais adicionais não é mais viável, e sem uma forma eficaz de navegar esses vídeos, esse banco de conhecimento é em grande parte inacessível.’
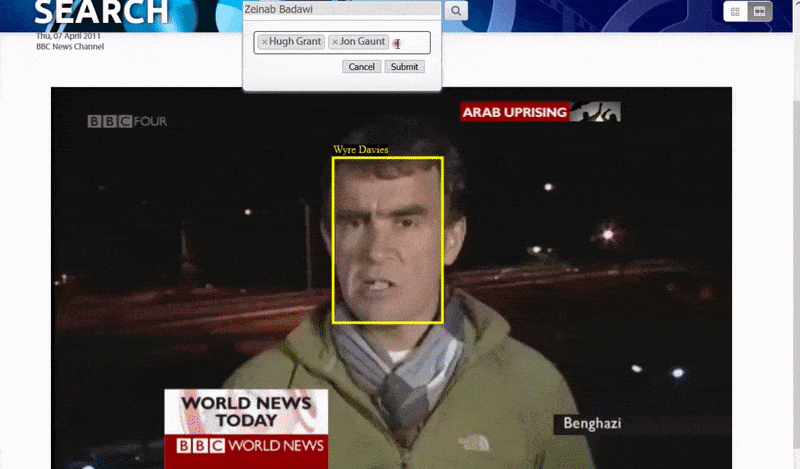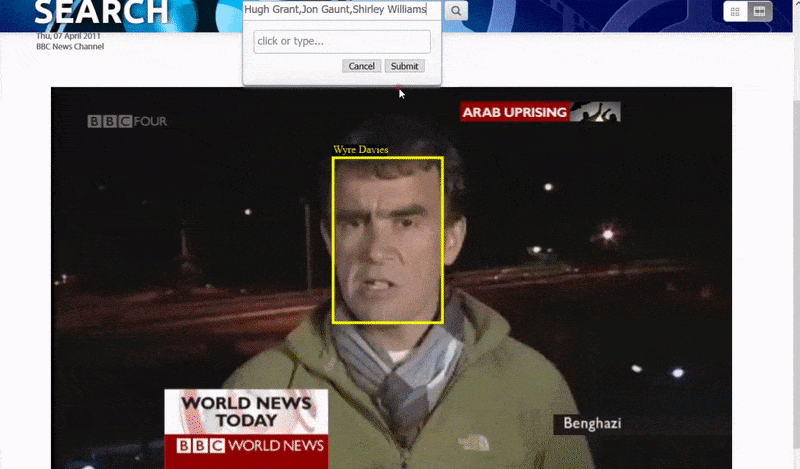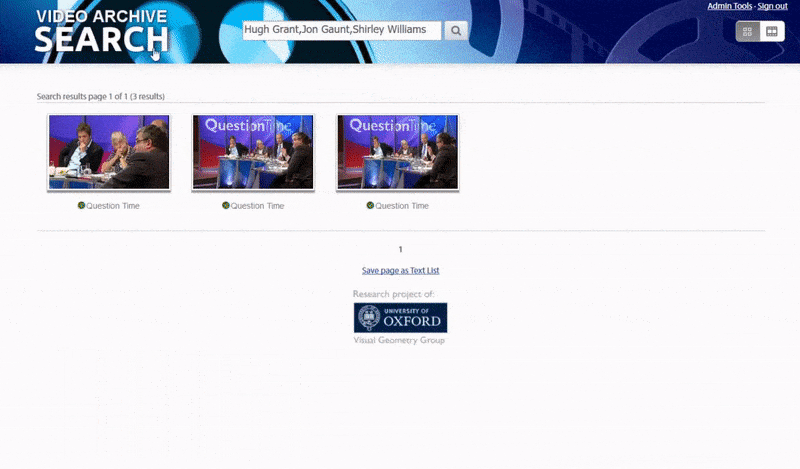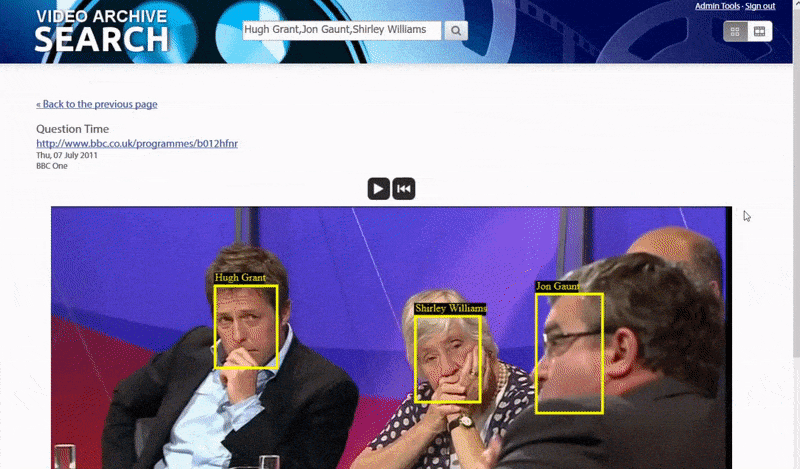
Um mecanismo de indexação desta natureza abre a possibilidade para hiperlinks de resultados de busca que chegam diretamente a um ponto no vídeo onde o assunto da busca aparece, como demonstrado na prova de conceito da busca na web fornecida pelo projeto.
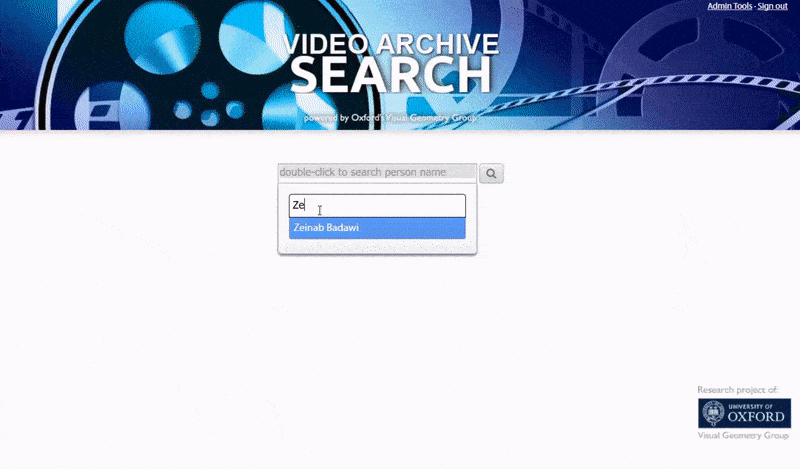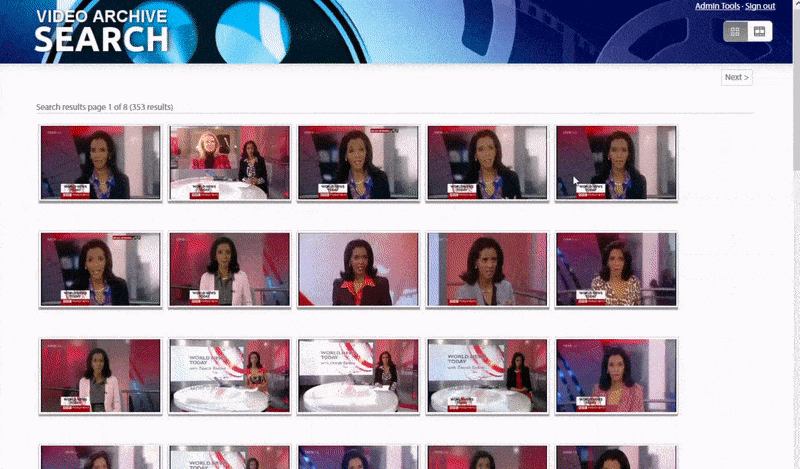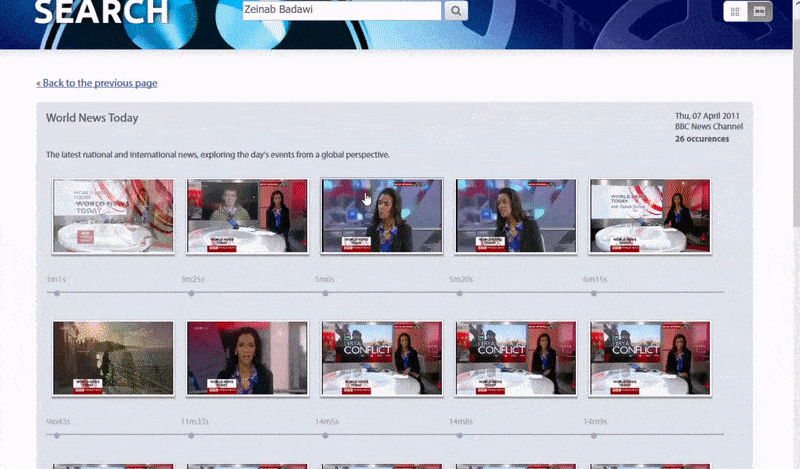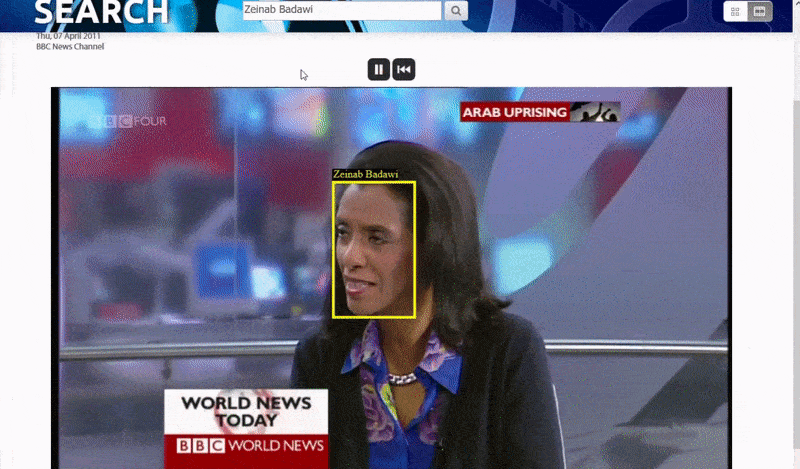
O sistema de Oxford permite uma busca por instâncias de uma pessoa identificada. O resultado da busca leva o visualizador diretamente para o ponto no vídeo onde a pessoa identificada aparece, e o vídeo pode então ser reproduzido a partir desse ponto. Fonte: https://www.robots.ox.ac.uk/~vgg/research/person_id_in_video/
Uma das maneiras pelas quais o sistema identifica pessoas ‘obscuras’ é pelo contexto de sua associação com outros.
Peixes Grandes e Pequenos
O sistema inicialmente aborda os ‘frutos fáceis’ – pessoas cujos rostos são tão bem indexados em recursos de rede pública que identificá-los é relativamente trivial, correspondendo metadados ou texto OCR’d em vídeos contra recursos de dados públicos, como listas do IMDB. O texto interpretado por IA em legendas de vídeo, créditos e outras formas de texto rasterizado em vídeo também é utilizado para fazer a identificação.

Nomes de candidatos para busca podem ser auto-descobertos pelo sistema, com base em reconhecimento óptico de caracteres (OCR) de texto rasterizado, ou de texto real em outras fontes, como listas de elenco. Assim, as pessoas podem ser indexadas automaticamente sem que os usuários finais individuais executem consultas anteriores em seus nomes, e sem participação prévia em redes sociais habilitadas por IA. Fonte: https://www.robots.ox.ac.uk/~vgg/publications/2021/Brown21/brown21.pdf
Onde imagens e vídeos na internet confirmam a identidade da pessoa de forma esmagadora, a investigação confirma uma identidade. Mas onde a pessoa é mais obscura, outros métodos são utilizados, incluindo áudio extraído de faixas de vídeo, que pode ser usado como confirmação corroboração de uma identidade. Embora não abordado no trabalho, logicamente não há nada que impeça um quadro desta natureza de também utilizar fontes de áudio puro, bem como componentes de áudio em vídeo.
Um Panteão de Identidade Auto-Propagante
Além de gerar nomes de candidatos a partir de texto rasterizado ou puro, tecnologias de reconhecimento de fala são usadas no projeto de Oxford para reconhecer nomes que são meramente pronunciados em conteúdo de áudio. Assim, uma identidade pode ser inicializada por uma ou duas pessoas que mencionam uma terceira pessoa que não está presente.
O mecanismo de segurança que o projeto de Oxford introduz é que o candidato deve aparecer no banco de dados do IMDB, mas remover essa estipulação arbitrária amplia consideravelmente o escopo potencial das capacidades do sistema, pois ele depende inteiramente de recursos extraíveis da web.
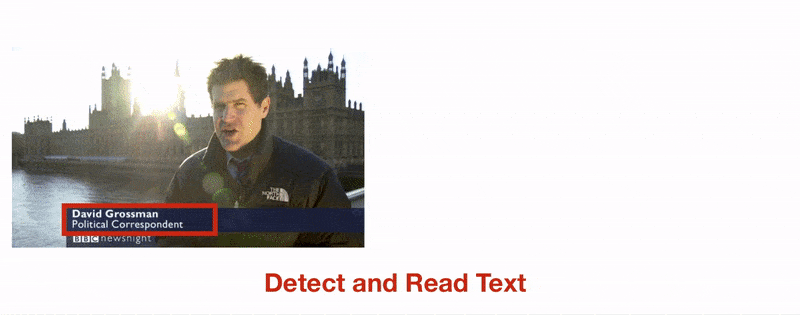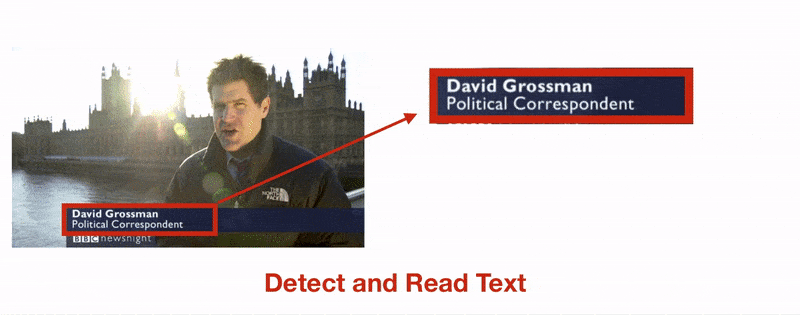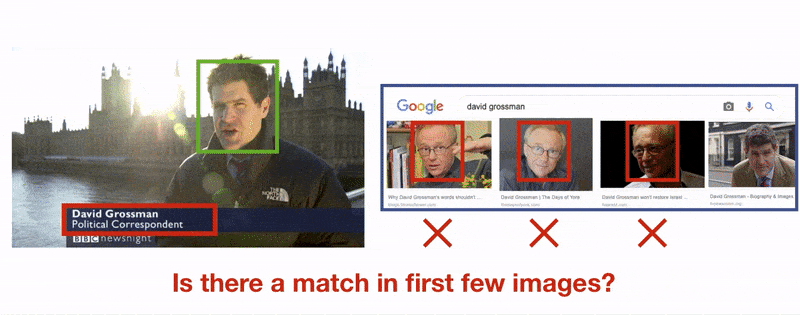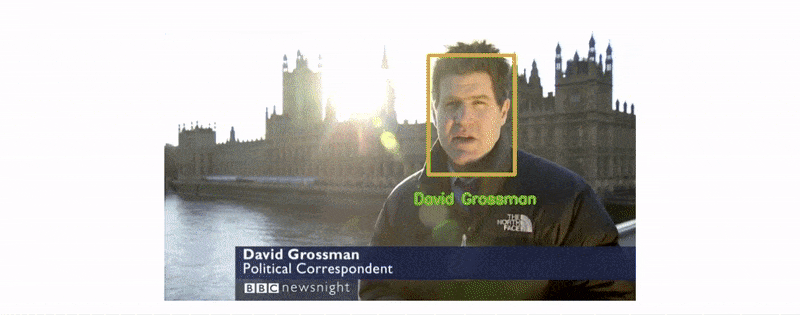
Portanto, com uma combinação de fontes, incluindo nomes derivados de texto rasterizado, texto real, menções baseadas em fala e material visual muito limitado, torna-se possível identificar indivíduos com uma presença visual de rede baixa.
Tecnicamente, também se torna possível construir um perfil de um indivíduo ao qual nenhuma imagem ou vídeo foi associado ainda, mas ao qual uma imagem ou vídeo pode ser eventualmente anexado quando outros fatores se correlacionam com uma nova fonte de vídeo.
Conjuntos de Dados de Teste
Os pesquisadores usaram três conjuntos de dados para avaliar a eficácia do sistema: MediaEval, que apresenta recursos de mídia social derivados de Creative Commons e capturados entre 2010-2015; o conjunto de dados Sherlock de 2017 do grupo de Oxford, que apresenta dados de vídeo anotados da adaptação moderna da BBC do personagem clássico de Conan Doyle; e um novo conjunto de dados de vídeos da BBC criado especificamente para o projeto, que usa notícias anotadas de várias fontes.

O sistema tem sucesso em uma ampla gama de ambientes de conjuntos de dados, incluindo ocasiões em que o rosto é ocultado por reflexos ou escuridão.
O processo também utiliza classificações de busca de imagens ao vivo.
Os resultados do sistema produziram alta precisão nos três modelos. No caso do conjunto de dados Sherlock, os pesquisadores ficaram surpresos ao descobrir que o novo sistema melhorou 3-6% sobre um método anterior que usava máquinas de vetores de suporte (SVMs) em um classificador multi-caminho, mesmo que o classificador de vizinho mais próximo usado no novo trabalho seja uma ferramenta menos poderosa.
Implicações
A maioria das restrições éticas ou práticas no projeto de Oxford são auto-impostas pelos pesquisadores, como definir ‘fama’ pelo requisito de que as identidades descobertas tenham uma presença no IMDB, e testar o sistema apenas contra conjuntos de dados acadêmicos estabelecidos que respeitam a licença Creative Commons.
No entanto, a arquitetura essencial do projeto descreve um método genérico para não apenas identificar ‘indivíduos obscuros’ que têm baixa ou zero presença visual na internet (já que uma mera menção de um nome pode gerar um token de identidade que pode ser desenvolvido com o tempo, conforme necessário), mas para criar uma matriz de indivíduos que é impulsionada por nada mais do que curiosidade recursiva e mecanicista, em vez de por demanda, ou pela presença explícita de dados rotulados (como uploads de fotos de mídia social que contêm metadados PII).
O projeto não usa dados de geolocalização, ou outras formas de metadados amplamente disponíveis que possam ser encontrados em documentos contribuintes, como informações de localização geográfica incorporadas por padrão em uploads para mídia social (onde esses não são removidos como uma preferência do usuário). No entanto, não há obstáculo aparente para usar essas dimensões adicionais de dados para fortalecer o processo corroboração.
Se as informações de identificação de outliers (identidades que têm quase zero presença, além de não estarem listadas no IMDB) são podadas de forma que é comum em projetos de aprendizado de máquina, essas informações mínimas podem, de fato, identificar uma pessoa desconhecida de forma mais eficaz do que se uma quantidade maior de informações representativas sobre ela estivesse disponível. Se os outliers são exatamente o que você está procurando (ou seja, indivíduos com pouca pegada na rede), dados escassos podem ser altamente indicativos.
Disponibilidade
Os pesquisadores de Oxford encapsularam a funcionalidade do projeto em um mecanismo de busca semelhante ao do Google que pode ser baixado e instalado em uma máquina local via Docker (embora as instruções de instalação para o artigo de maio de 2021 contenham informações desatualizadas para um requisito de Ferramentas Docker, o que pode dificultar o processo).

Apesar disso, não há uma versão online ao vivo que cubra a implementação do projeto em todos os três conjuntos de dados, embora os resultados para o conjunto de dados de notícias da BBC possam ser livremente interrogados em http://zeus.robots.ox.ac.uk/bbc_search/.


