
Liderzy opinii
Następne wąskie gardło mocy AI będzie w miastach

 Dodaj Unite.AI do preferowanych źródeł w Google
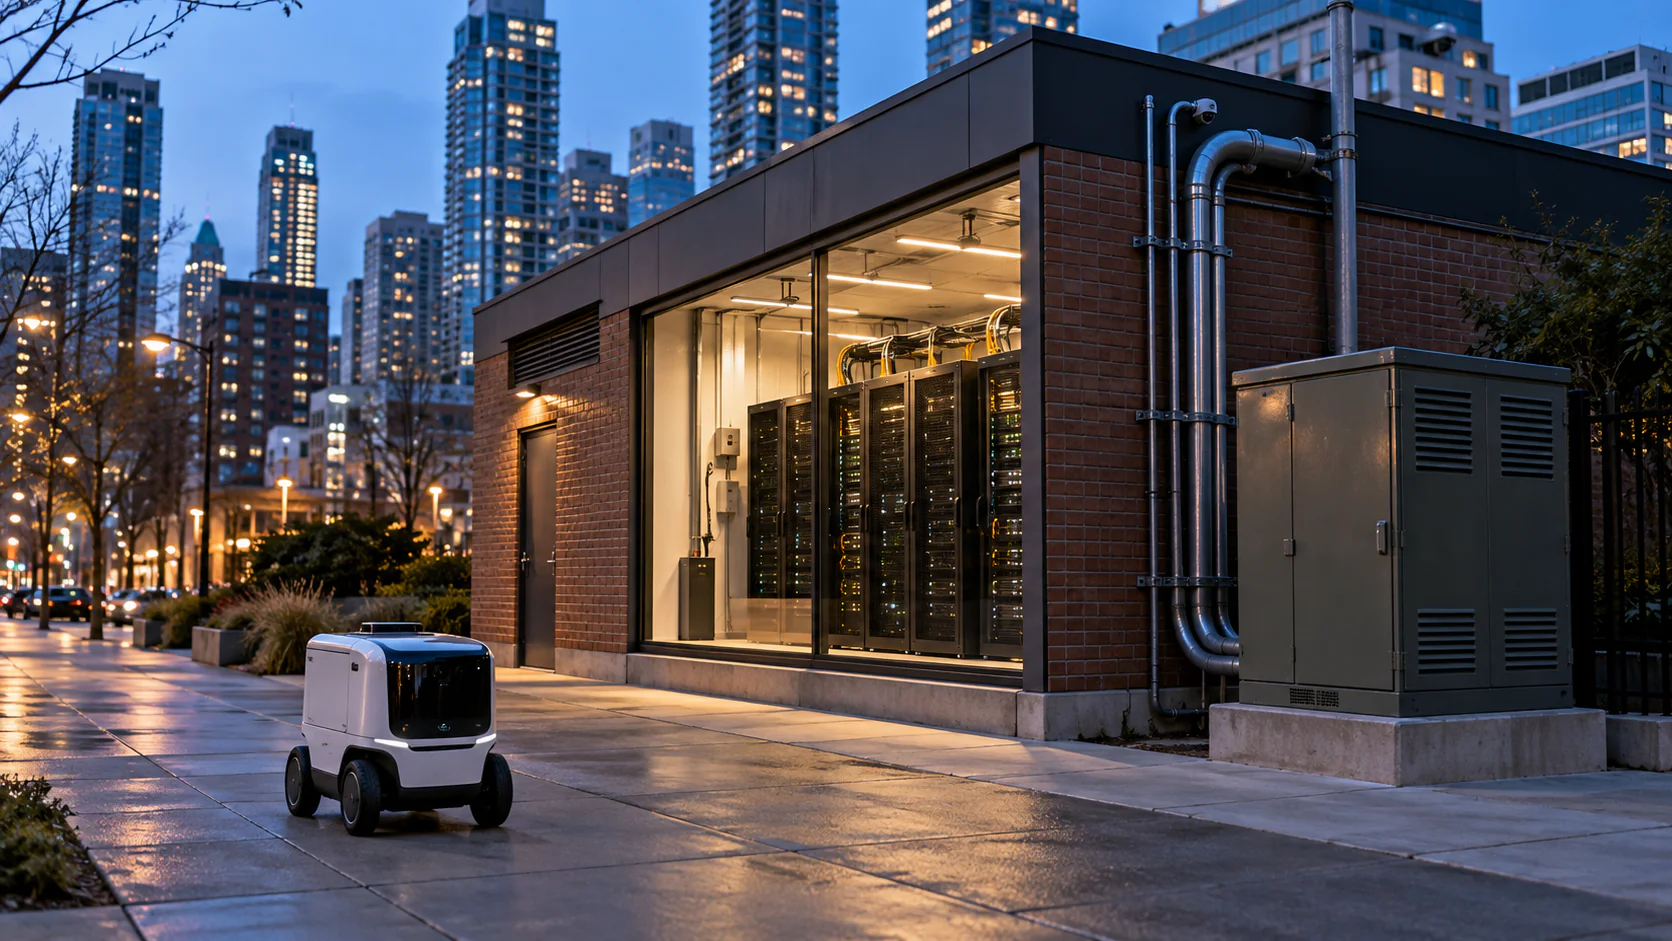
Na przestrzeni ostatnich kilku lat, a liczba ta wciąż rośnie, rynek infrastruktury AI poświęcił ogromną ilość czasu i pieniędzy (blisko $7 trillion inwestycji w centra danych do 2030 roku, według szacunków McKinsey) na naukę budowania dużych centrów danych tam, gdzie dostępna jest energia. „Gdziekolwiek” to kluczowe słowo, ponieważ lokalizacja nie była wtedy bardzo istotna. Klaster szkoleniowy potrzebuje jedynie dostępu do wystarczającej mocy. Jednak lokalizacja zaczyna nabierać coraz większego znaczenia, gdy użycie AI rośnie poza interfejsy czatowe, obejmując maszyny, systemy głosowe, wideo i aplikacje współdziałające z rzeczywistym światem. Takie operacje wymagają, aby moc obliczeniowa była bliżej centrów miejskich, w których zachodzą te interakcje, aby utrzymać niską latencję. Podczas gdy narzędzia takie jak chatboty mogą tolerować opóźnienie pół sekundy, zautomatyzowane aplikacje usługowe, takie jak zdalnie nadzorowane roboty dostawcze, asystenci głosowi w czasie rzeczywistym czy systemy automatycznego realizowania zamówień, mogą wymagać reakcji w ciągu kilku milisekund.
To nowe wyzwanie dla firm AI. Jak znaleźć mniejsze źródła niezawodnej energii w i wokół dużych obszarów metropolitalnych? A nawet po zlokalizowaniu odpowiednich miejsc, jak radzić sobie z reakcją negatywną, którą napotykają nawet zdalne centra danych?
Rosnące zapotrzebowanie na AI w centrach miejskich
W urbanistycznej sferze rośnie zapotrzebowanie na AI wykraczające poza osobiste korzystanie z chatbotów czy jakąkolwiek obsesję na punkcie robotów. raport roboczy IMF szacuje, że zużycie energii elektrycznej przez centra danych i AI już w 2023 roku osiągnęło 400–500 TWh na świecie, a zużycie napędzane przez AI może potencjalnie sięgnąć 1 500 TWh do 2030 roku. Automatyzacja niezbędna do zwiększenia efektywności prostych operacji — czy to przetwarzanie dokumentacji, czy archiwizacja wideo — wymaga dużej mocy na dużą skalę.
Miasta stoją na czele tego zjawiska, co pokazuje przegląd OECD obejmujący 250 miast w 78 krajach. Stwierdzono, że 56 % już aktywnie korzysta z AI, a kolejne 35 % prowadzi pilotaż lub planuje wdrożenia. Aby zilustrować prosty przypadek użycia, rozważmy kamery monitoringu w mieście. IHS Markit oszacował kilka lat temu, że liczba kamer monitoringu na świecie przekroczy miliard. Choć głównie służą do nagrywania, są teraz wykorzystywane również do bardziej wymagających obliczeniowo zadań, np. śledzenia obiektów w sieci lub przeszukiwania dużych archiwów wideo przy użyciu języka naturalnego. Takie procesy nie mogą odbywać się w każdej kamerze przy obecnym przetwarzaniu AI. Czy więc powinny być wysyłane poza miasto do odległego centrum danych w celu przetworzenia? Jest to niepraktyczne ze względu na regulacje dotyczące danych oraz koszty przesyłania tak dużych wolumenów ruchu.
Niedawny sondaż Gallupa pokazuje, że około 30 % pracowników sektora prywatnego i publicznego używa AI w swojej roli i liczba ta rośnie. Sektory te — czy to bankowość, szpitale czy organizacje sektora publicznego — napotykają te same problemy. Chcą infrastruktury AI w ramach własnej jurysdykcji i fizycznie wystarczająco blisko, aby ją kontrolować. Ich interaktywne systemy głosowe i aplikacje wideo pogarszają się wraz ze wzrostem opóźnień sieciowych. Nawet jeśli problem można początkowo obejść, pozostawiając operatora człowieka przy pierwszej generacji systemów autonomicznych, taka nadzór nie jest zbyt wyrozumiały wobec opóźnień. Na przykład roboty dostawcze i domowe nadzorowane przez połączenie wideo wymagają pełnej pętli komunikacyjnej, która musi pozostawać poniżej około 80 milisekund, według badania zdalnej teleoperacji robotów. Samochody autonomiczne, paradoksalnie, są wyjątkiem: prowadzenie pozostaje na pokładzie ze względów bezpieczeństwa, a zdalni operatorzy Waymo pracują przy opóźnieniu ćwierć sekundy, niektórzy z nich z innego kontynentu. To, co miasto dziedziczy po flotach autonomicznych, to ich dane, a nie kierownica.
Rynek centrów danych niedoszacowuje tego wzrostu popytu. Bank Światowy opublikował raport pokazujący, jak gminy w krajach takich jak Argentyna, Indie i Etiopia, oraz inne, wprowadziły AI w obszarach wymiaru sprawiedliwości, zwalczania korupcji, cel, administracji publicznej i poprawy usług. Nie jest to zjawisko lokalne. To globalna transformacja. W Teravolt szacujemy, że obszar metropolitalny liczący od 10 do 15 milionów mieszkańców może obsłużyć około 6‑13 MW ciągłego, wrażliwego na opóźnienia obciążenia AI do 2030 roku, zanim roboty ogólnego przeznaczenia zostaną masowo wdrożone. Można argumentować, że liczba ta nie jest duża w skali hyperskalowej, ale znalezienie jej w odpowiednim miejscu jest znacznie trudniejsze niż się wydaje. Do 2036 roku ten sam obszar metropolitalny przejdzie do 22‑50 MW wrażliwego na opóźnienia obciążenia — i do 60‑100 MW, jeśli przemysł samochodowy zacznie produkować roboty w skali motoryzacyjnej. Ekonomia popytu jest nieugięta w najlepszy sposób: kilkaset dolarów rocznie koszt serwera na maszynie, która zastępuje $30 000‑$60 000 pracy, to popyt, który nie negocjuje ceny.
Wprowadzenie czwartej warstwy w przetwarzaniu
Obecnie moc obliczeniowa dla AI istnieje na trzech poziomach. Górna warstwa składa się z gigafabryk używanych do trenowania modeli. Ich lokalizacja ma znaczenie dla deweloperów jedynie w zakresie zapewnienia dużych ilości energii po akceptowalnej cenie. Następnie występują regionalne obiekty AI, zazwyczaj od 20 do 200 MW, gdzie zachodzi większość regularnego zapotrzebowania na wnioskowanie w dużych operacjach chmurowych i przedsiębiorstwowych. Na końcu mamy moc obliczeniową wbudowaną bezpośrednio w urządzenie lub robota.
Wydaje się, że istnieje luka między ostatnimi dwoma warstwami, którą określam jako warstwę miejską — luka odpowiedzialna za problemy z opóźnieniami. Musiałyby one znajdować się wewnątrz lub bardzo blisko dużych miast. Ich moc powinna mieścić się w przedziale jednocyfrowych lub niskich dwucyfrowych megawatów, przy jednoczesnym położeniu w obszarach metropolitalnych i podłączeniu do wysokiej jakości światłowodu. Punktem wyjścia może być około 2 MW, jeśli lokalizacja ma zapewnioną moc. Aby zilustrować praktyczność, rozważmy robota dostawczego. Obsługuje on różne żądania i nie wszystkie mogą być przetworzone na samym urządzeniu. Choć jest szkolony w gigafabryce, bardziej zaawansowana pomoc w czasie rzeczywistym musiałaby być przetwarzana przez pobliską miejską placówkę zamiast za każdym razem wysyłać ją do regionalnego centrum.
Problem dwukierunkowego ruchu
Miejskie centra danych nie będą jedynie pośrednimi punktami odbierania danych z centrów szkoleniowych, ale także będą generować duże ilości danych, które będą odsyłane w górę łańcucha.
Każda autonomiczna maszyna i system bogaty w czujniki będzie gromadził informacje, które będą musiały zostać przetworzone i odsyłane w celu integracji z procesem szkolenia. Floty robotów wracających do swoich stacji ładowania po zmianie będą przesyłać ogromne, użyteczne informacje o przypadkach brzegowych i codziennej eksploatacji, których centra danych potrzebują, aby usprawniać funkcje. Wyobraźmy sobie, że cały ten ruch jest wysyłany jednocześnie w tym samym kierunku. Spowoduje to wąskie gardło. To właśnie tutaj przydatny jest miejski centrum danych, ponieważ może przetworzyć część obciążenia, zanim przytłoczy ono regionalne centrum obliczeniowe. Może ono identyfikować i odrzucać nieprawidłowe dane, jednocześnie kompresując i przekazując przydatne części.
Zasadniczo, miejski centrum danych zapewnia dodatkową warstwę filtrowania do dwóch poprzedzających go warstw, co sprawia, że przepływ danych jest jeszcze bardziej uporządkowany.
Czy przyszłość to serwer na każdym bloku?
Chociaż przedstawiam miejskie serwery jako rozwiązanie, jest to po prostu zbyt kosztowne, aby rozwiązać problemy z opóźnieniami przy nieograniczonej proliferacji. Niezależnie od rozmiaru, centrum danych nadal wymaga podłączenia do sieci, transformatorów, chłodzenia, zabezpieczeń, sieci oraz personelu. Te koszty nie zmniejszają się proporcjonalnie do obciążenia IT. Dla porównania, obiekt o mocy 0.5 MW nadal ponosi wiele tych samych kosztów stałych co znacznie większy obiekt.
W naszych projektach zauważyliśmy, że samodzielne miejskie centrum danych staje się opłacalne ekonomicznie przy około 5‑8 MW. Nawet przy założeniu, że kilka lokalizacji może współdzielić centrum operacji sieciowej, próg spada jedynie do 1.5‑3 MW. Dlatego ostateczny wynik pozostaje taki sam. Rozdzielenie 20 MW na dwadzieścia lokalizacji zamiast dwóch lub trzech prawie nie zmniejsza opóźnień w obszarze metropolitalnym — pierścień światłowodowy miasta ma zaledwie kilka milisekund — przy jednoczesnym mnożeniu kosztów kapitałowych i operacyjnych.
Dlatego uważam, że branża musi zmniejszyć skalę i budować to, co nazywam „stacjami podwyższającymi inteligencję”. Obecnie deweloperzy uczą się, jak budować regionalne obiekty w zakresie od 20 do 100 MW. Celem przyszłości jest zastosowanie tego do jeszcze mniejszych, miejskich lokalizacji, aby osiągnąć poziom 2 MW odpowiedni dla dużych miast.
Polityczna przeszkoda
Poza kwestią opłacalności ekonomicznej, wyzwanie polityczne nadal istnieje. Centra danych stały się coraz bardziej potępiane w mediach ze względu na ich negatywny wpływ na środowisko. Według badania Pew, ponad połowa Amerykanów uważa, że centra danych są szkodliwe dla środowiska i ma o nich negatywne opinie. Argument tworzenia miejsc pracy blednie w porównaniu z ilością wody, ziemi i energii elektrycznej zużywanej; a także hałasem i emisjami generowanymi. Uzyskanie zezwoleń nawet na mniejsze miejskie obiekty okazałoby się trudne.
Już obserwujemy przykłady konfliktów między deweloperami centrów danych a władzami miejskimi. W USA, zastosowanie turbin gazowych przez xAI w przyspieszeniu budowy w Memphis doprowadziło do sporów o pozwolenia, sprzeciwu społeczności i postępowań sądowych. Europa posunęła się dalej: Amsterdam wprowadził moratorium na obiekty powyżej 70 MW, Dublin dopuszcza nowe centra danych tylko wtedy, gdy przynoszą własną generację lub magazynowanie, a kluczowa podstacja korytarza West London nie zostanie wzmocniona przed wczesnymi latami 2030. Nawet poza takimi głośnymi przypadkami, będąc nowym obszarem sporu, wiele władz miejskich nie ma jasnego procesu zatwierdzania dodatkowych 10 MW infrastruktury AI wewnątrz obszaru miejskiego. Jak zauważono w raporcie National League of Cities, jednym z najczęstszych wyzwań dla miast jest to, że starsze lokalne przepisy zagospodarowania przestrzennego nie odnoszą się explicite do centrów danych, co prowadzi do rozpatrywania spraw indywidualnie. Takie niepewności prawne mogą opóźniać nawet technicznie wykonalne projekty.
Decyzje infrastrukturalne dzisiaj kształtują naszą zdolność na przyszłość
Wszystko to ma na celu podkreślenie, że musimy z wyprzedzeniem planować i budować infrastrukturę niezbędną dla przyszłych postępów w dziedzinie AI. Ponieważ modele rozwijają się szybko, moc potrzebna do ich uruchomienia zależy od rodzaju infrastruktury, której budowa wymaga czasu. Połączenia sieciowe mogą trwać lata, a w niektórych dużych rynkach centrów danych kolejki teraz rozciągają się od siedmiu do dziesięciu lat. Jeśli więc miasta będą zwiększać moc obliczeniową AI do 2030 roku, ta infrastruktura elektryczna musi zostać wdrożona już teraz. W Teravolt nasz model szacuje globalne zapotrzebowanie miejskiego AI na poziomie od 9 do 18 GW do 2036 roku. Oznacza to około 1000‑1500 znaczących miejskich i metropolitalnych obiektów na całym świecie, w zależności od średniej wielkości instalacji, a łącznie może to stanowić rynek o wartości około $500 billion do $1 trillion.
Jeśli nie przeprowadzimy niezbędnego planowania, utknąśmy z zaawansowaną pojemnością AI, której nie będziemy w stanie wykorzystać. Era telefonii komórkowej wymagała infrastruktury wież radiowych, aby zapewnić zasięg, w przeciwnym razie telefon komórkowy byłby niepotrzebny. Podobnie musimy dostrzec rozbieżność między rozwojem AI a wdrażaniem infrastruktury elektrycznej. Tam, gdzie era mobilna mierzyła zasięg w słupkach sygnału, era AI będzie mierzyć go w milisekundach i watach na mieszkańca — i nie będzie potrzebowała milionów wież, lecz raczej około tysiąca obiektów wielkości podstacji. Światłowód, milisekundy i megawaty są walutą w tej dziedzinie, a ci, którzy dostrzegą tę niedobór z wyprzedzeniem, będą lepiej przygotowani do kształtowania przyszłości.


