Kąt Andersona
“Bezsensowny język”, który może podważyć systemy moderacji syntezowania obrazów

 Dodaj Unite.AI do preferowanych źródeł w Google
Nowe badania z Uniwersytetu Columbia sugerują, że zabezpieczenia uniemożliwiające modelom syntezy obrazów, takim jak DALL-E 2, Imagen i Parti, tworzenie szkodliwych lub kontrowersyjnych obrazów są podatne na rodzaj ataku z użyciem wymyślonych słów.
Autor opracował dwie metody, które mogą obchodzić moderację treści w systemie syntezy obrazów. Okazały się one zaskakująco skuteczne także w różnych architekturach. Wskazuje to, że słabość nie jest wyłącznie cechą konkretnego systemu i może dotyczyć podstawowych zasad syntezy obrazów na podstawie tekstu.
Pierwsza i skuteczniejsza metoda to macaronic prompting. Termin „makaroniczny” pierwotnie oznacza mieszaninę kilku języków, jak w esperanto lub Unwinese. Być może najbardziej rozpowszechnionym kulturowo przykładem jest urdu z angielskim, forma mieszania języków powszechna w Pakistanie, swobodnie łącząca angielskie rzeczowniki z przyrostkami urdu.

Kompozycyjne stosowanie makaronicznych promptów w DALL-E 2. Źródło: https://arxiv.org/pdf/2208.04135.pdf
W niektórych powyższych przykładach sklejono fragmenty znaczących słów, używając angielskiego jako rusztowania. Inne przykłady w pracy wykorzystują wiele języków w jednym prompcie.
System odpowiada w semantycznie sensowny sposób z powodu stosunkowo niewielkiego stopnia selekcji i weryfikacji źródeł internetowych użytych do jego trenowania. Takie źródła często zawierają wielojęzyczne etykiety, na przykład w zbiorach danych nieprzeznaczonych specjalnie do syntezy obrazów. Każde przyswojone słowo, niezależnie od języka, staje się tokenem. Również części słów stają się podsłowami lub fragmentami tokenów. W przetwarzaniu języka naturalnego (NLP) takie sprowadzanie do rdzeni pomaga odróżniać etymologię dłuższych słów pochodnych, które mogą powstawać w wyniku przekształceń. Tworzy jednak także ogromny leksykalny zestaw Lego, który można wykorzystać do kreatywnego konstruowania promptów.
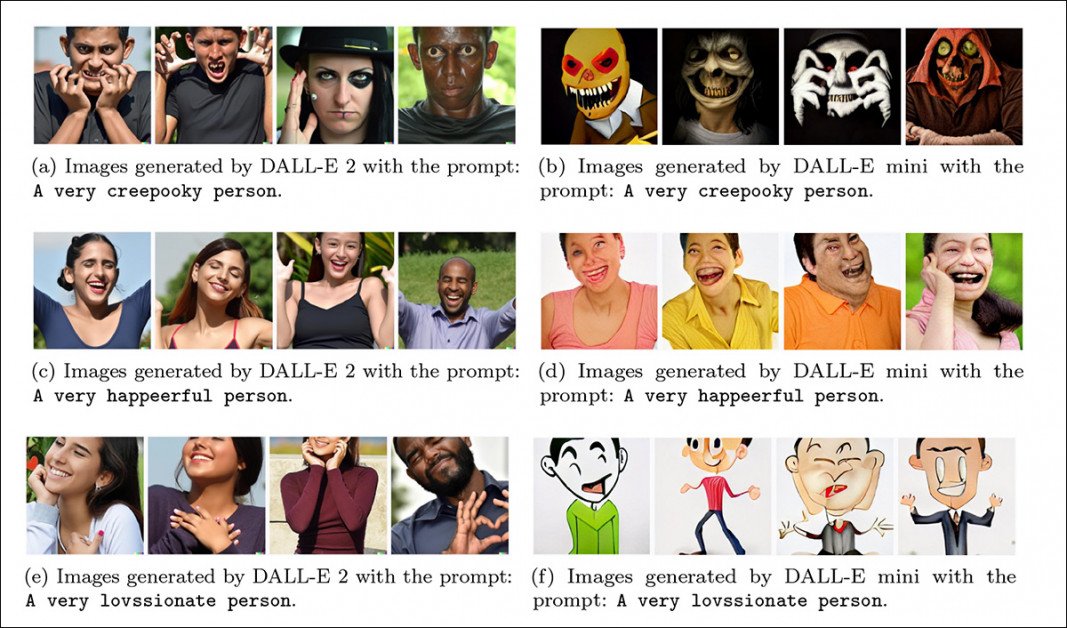
Jednojęzyczne kontaminacje słowne również skutecznie pozwalają uzyskać obrazy za pomocą języka pośredniego lub odbiegającego od zwykłej prozy. Bardzo podobne wyniki można często otrzymać w różnych architekturach, takich jak DALL-E 2 i DALL-E Mini (Craiyon).
W drugiej metodzie, zwanej evocative prompting, niektóre połączone słowa przypominają bardziej dziecinną odmianę żartobliwej łaciny szkolnej przedstawioną w Żywocie Briana Monty Pythona (1979).

To nie żart: sztuczna łacina często wywołuje znaczącą odpowiedź DALL-E 2.
Autor stwierdza:
„Oczywistą obawą związaną z tą metodą jest obchodzenie filtrów treści opartych na listach zabronionych promptów. Zasadniczo macaronic prompting może zapewniać łatwy i pozornie niezawodny sposób ich omijania w celu generowania treści szkodliwych, obraźliwych, nielegalnych lub w inny sposób wrażliwych. Dotyczy to obrazów przedstawiających przemoc, nienawiść, rasizm, seksizm lub pornografię, a być może także obrazów naruszających własność intelektualną lub przedstawiających prawdziwe osoby.
„Firmy świadczące usługi generowania obrazów bardzo starannie zapobiegają powstawaniu takich wyników zgodnie ze swoją polityką treści. Dlatego macaronic prompting należy systematycznie badać jako zagrożenie dla protokołów bezpieczeństwa wykorzystywanych w komercyjnym generowaniu obrazów”.
Autor proponuje kilka środków zaradczych i przyznaje, że niektóre mogą być uznane za nadmiernie restrykcyjne.
Pierwsze możliwe rozwiązanie jest najdroższe: staranniejsza selekcja i weryfikacja źródłowych obrazów treningowych przy większym nadzorze ludzi i mniejszym udziale algorytmów. Autor przyznaje jednak, że nie zapobiegłoby to tworzeniu obraźliwych połączeń dwóch koncepcji obrazowych, które osobno mogą być nieszkodliwe.
Po drugie, praca sugeruje przepuszczanie faktycznych wyników systemów syntezy obrazów przez filtr, który przechwytywałby problematyczne skojarzenia przed pokazaniem ich użytkownikowi. DALL-E 2 być może już korzysta z takiego filtra, choć OpenAI nie ujawniło dokładnie, jak działa jego moderacja treści.
Na koniec autor rozważa słownikową listę dozwolonych słów. Tylko sprawdzone i zatwierdzone słowa mogłyby przywoływać pojęcia i tworzyć ich obrazy. Przyznaje jednak, że mogłoby to nadmiernie ograniczyć użyteczność systemu.
Choć badacz eksperymentował z układaniem promptów jedynie w pięciu językach — angielskim, niemieckim, francuskim, hiszpańskim i włoskim — sądzi, że zwiększenie liczby języków mogłoby uczynić ten rodzaj ataku jeszcze bardziej zagadkowym i trudniejszym do powstrzymania. Modele ogromnej skali, takie jak DALL-E 2, są trenowane w wielu językach, ponieważ łatwiej użyć danych lekko filtrowanych lub surowych niż ponosić ogromne koszty ich selekcji, a dodatkowa wymiarowość prawdopodobnie zwiększa użyteczność systemu.
Praca nosi tytuł Adversarial Attacks on Image Generation With Made-Up Words, a jej autorem jest Raphaël Millière z Uniwersytetu Columbia.
Zagadkowy język w DALL-E 2
Już wcześniej sugerowano, że bełkot generowany przez DALL-E 2 podczas prób przedstawiania języka pisanego może sam w sobie stanowić „ukryty słownik”. Wcześniejsze badania nad tym tajemniczym językiem nie dostarczyły jednak sposobu opracowania wymyślonych ciągów znaków przywołujących określone obrazy.
O wcześniejszej pracy autor pisze:
„Nie oferuje ona niezawodnej metody znajdowania wymyślonych ciągów znaków wywołujących określone obrazy. Większość bełkotliwego tekstu umieszczanego przez DALL-E 2 na obrazach nie wydaje się niezawodnie powiązana z konkretnymi pojęciami wizualnymi po przepisaniu i użyciu jako prompt. Ogranicza to przydatność tej metody do obchodzenia moderacji szkodliwych lub obraźliwych treści. Nie stanowi więc ona szczególnie niepokojącego zagrożenia nadużywania modeli generujących obrazy na podstawie tekstu”.
Natomiast dwie metody autora wyjaśniają, jak bezsensowny tekst może przywoływać powiązane i znaczące obrazy, omijając konwencjonalne zasady, które obecnie rozwijają się w inżynierię promptów.
Przykładowo autor rozważa słowo „ptaki” w pięciu językach objętych pracą: Vögel po niemiecku, uccelli po włosku, oiseaux po francusku i pájaros po hiszpańsku.
Za pomocą kodowania par bajtów (BPE), czyli tokenizacji stosowanej w implementacji CLIP, która jest zintegrowana z DALL-E 2, słowa są tokenizowane do angielskiego bez znaków diakrytycznych. Można je kreatywnie łączyć w wymyślone słowa, które dla nas brzmią jak bełkot, ale zachowują sklejone znaczenie dla DALL-E 2, umożliwiając systemowi wyrażenie rozpoznanej intencji:

W powyższym przykładzie dwa obcojęzyczne słowa oznaczające ptaka sklejono w bezsensowny ciąg. Dzięki częściowej wadze podsłów znaczenie zostaje zachowane.
Autor podkreśla, że znaczące wyniki można uzyskiwać również bez przestrzegania granic segmentacji podsłów. Prawdopodobnie DALL-E 2, główny przedmiot badania, uogólnił wiedzę wystarczająco dobrze, aby granice podsłów mogły się zacierać bez niszczenia ich znaczenia.
Aby dodatkowo zilustrować opracowane podejścia, praca przedstawia przykłady macaronic prompting w różnych dziedzinach, korzystając z poniższej listy słów-tokenów. Bezsensowne słowa hybrydowe znajdują się po prawej stronie.

Autor stwierdza, że poniższych przykładów DALL-E 2 nie wybrano tendencyjnie spośród najlepszych wyników:

Lingua franca
Praca zauważa także, że kilka takich przykładów działa równie dobrze lub przynajmniej bardzo podobnie zarówno w DALL-E 2, jak i DALL-E Mini (obecnie Craiyon). Jest to zaskakujące, ponieważ DALL-E 2 jest modelem dyfuzyjnym, a DALL-E Mini nie. Systemy trenowano na różnych zbiorach danych, a DALL-E Mini używa tokenizatora BART zamiast preferowanego przez DALL-E 2 tokenizatora CLIP.
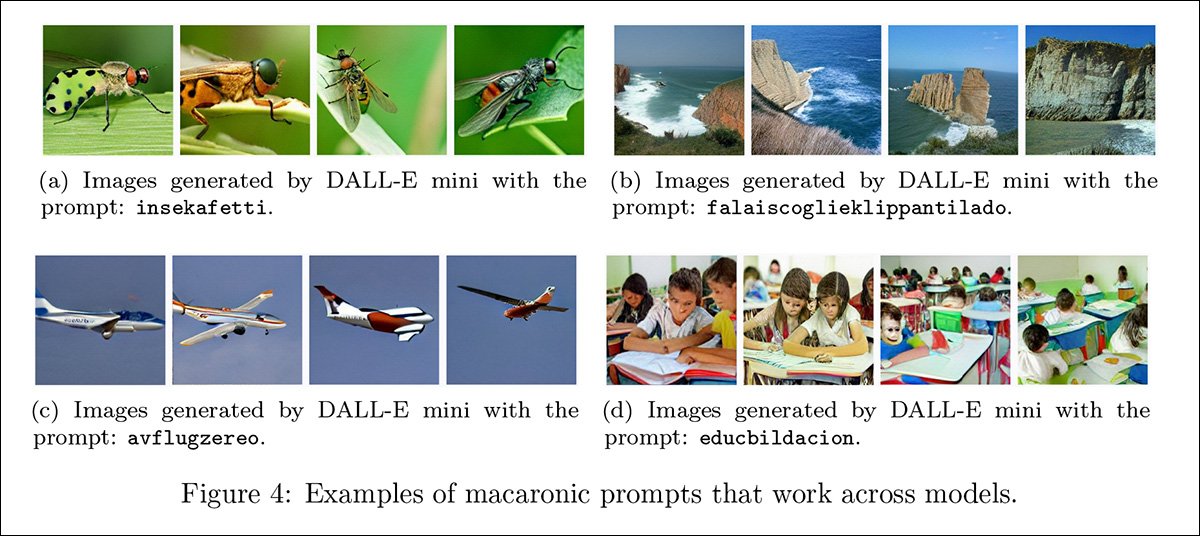
Zaskakująco podobne wyniki DALL-E Mini w porównaniu z poprzednim obrazem, pokazującym wyniki DALL-E 2 dla tego samego bezsensownego wejścia.
Jak widać na pierwszych obrazach powyżej, makaroniczne prompty można też składać w poprawne składniowo zdania, aby generować bardziej złożone sceny. Wymaga to jednak użycia angielskiego jako rusztowania do łączenia pojęć, przez co procedura jest bardziej narażona na przechwycenie przez standardowe systemy cenzury w mechanizmie syntezy obrazów.
Praca zauważa, że hybrydyzację leksykalną, czyli sklejanie słów w celu uzyskania powiązanej treści z systemu syntezy obrazów, można przeprowadzać także w jednym języku, używając kontaminacji słownych.
Prompty ewokatywne
Przedstawiona w pracy metoda evocative prompting opiera się na wywoływaniu szerszej odpowiedzi systemu słowami, które nie bazują ściśle na podsłowach, fragmentach tokenów ani częściowo wspólnych etykietach.
Jednym z jej rodzajów jest pseudołacina, która może między innymi generować obrazy fikcyjnych leków, nawet bez wskazania, że DALL-E 2 ma przywołać pojęcie leku:

Metoda działa też szczególnie dobrze z bezsensownymi promptami odnoszącymi się ogólnie do możliwych lokalizacji geograficznych i jest dość niezawodna w różnych architekturach DALL-E 2 i DALL-E Mini:
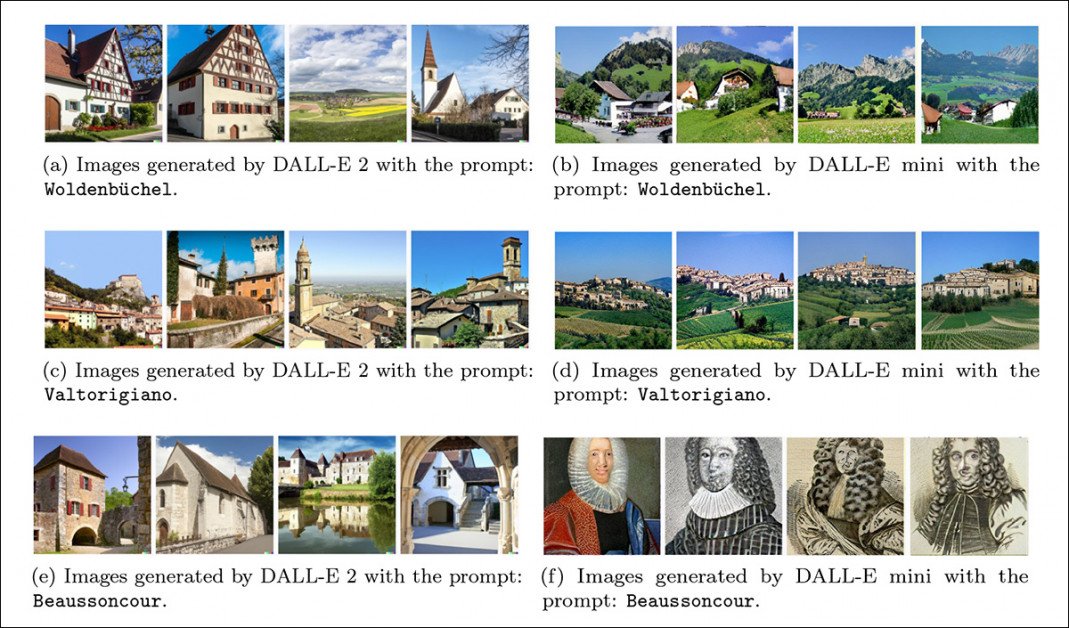
Słowa użyte w tych promptach dla DALL-E 2 i DALL-E Mini przywodzą na myśl prawdziwe nazwy, lecz same w sobie są zupełnie bezsensowne. Mimo to systemy uchwyciły atmosferę tych słów.
Między makaronicznym a ewokatywnym konstruowaniem promptów występuje pewne nakładanie się. Praca stwierdza:
„Różnice w danych treningowych, rozmiarze modelu i architekturze mogą sprawiać, że poszczególne modele interpretują prompty takie jak voiscellpajaraux i eidelucertlagarzard w sposób makaroniczny lub ewokatywny, nawet jeśli wykazano, że reagują na obie metody”.
Praca konkluduje:
„Choć różne właściwości tych modeli — w tym rozmiar, architektura, procedura tokenizacji i dane treningowe — mogą wpływać na ich podatność na ataki tekstowe, wstępne dowody omówione w tej pracy sugerują, że niektóre z tych ataków mogą mimo to działać dość niezawodnie w różnych modelach”.
Prawdopodobnie największą przeszkodą w rzeczywistym eksperymentowaniu z tymi metodami jest ryzyko wykrycia i zablokowania przez system usługodawcy. DALL-E 2 wymaga numeru telefonu powiązanego z każdym kontem, co ogranicza liczbę kont jednorazowych, prawdopodobnie potrzebnych do dogłębnego przetestowania granic takiego hakowania leksykalnego i obchodzenia istniejącej moderacji. Obecnie głównym zabezpieczeniem DALL-E 2 pozostaje niepewność dostępu.
Pierwsza publikacja: 9 sierpnia 2022 r.