
Wywiady
Simon Poghosyan, Założyciel i Dyrektor Generalny GSpeech – Seria Wywiadów

 Dodaj Unite.AI do preferowanych źródeł w Google
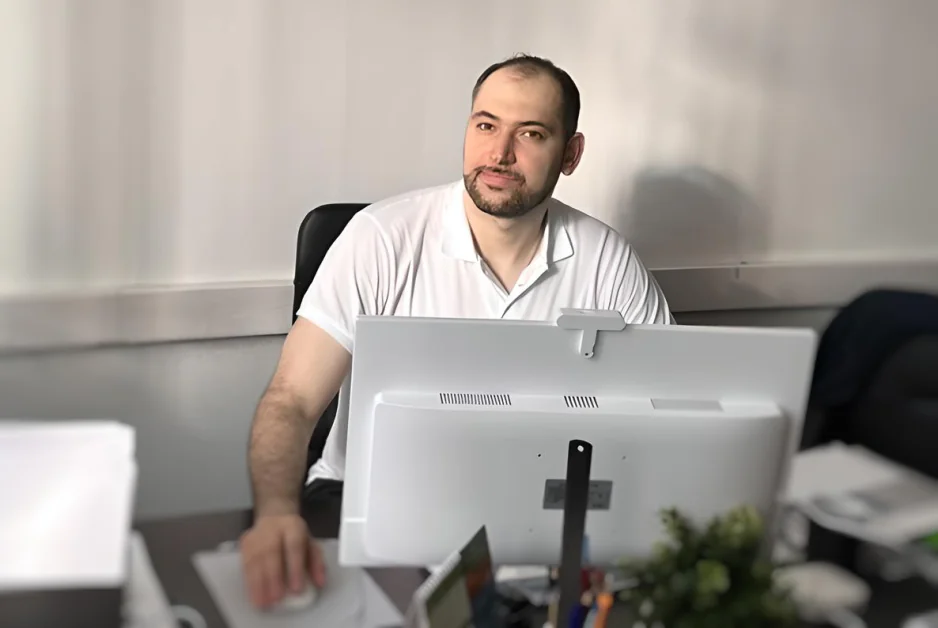
Simon Poghosyan jest założycielem i dyrektorem generalnym GSpeech, platformy internetowej opartej na sztucznej inteligencji, która pomaga uczynić treści internetowe bardziej dostępnymi, konwertując tekst na naturalnie brzmiący dźwięk w ponad 70 językach. Z wykształceniem w dziedzinie projektowania VLSI i silnym zainteresowaniem programowaniem oraz doświadczeniem użytkownika, Simon stworzył GSpeech, aby uprościć sposób, w jaki strony internetowe mogą oferować treści z włączoną funkcją głosową.
Dziś GSpeech generuje około 200 milionów znaków dźwięku każdego miesiąca i jest używany w ponad 70 krajach, a jego dostosowywalne odtwarzacze audio obsługują ponad 200 000 odtworzeń miesięcznie. Po przekroczeniu 1 miliarda wygenerowanych znaków dźwięku, GSpeech nadal rozwija się dynamicznie. Platforma została zaprojektowana, aby być łatwą w integracji — wymaga tylko jednej linii kodu — i wspiera twórców, edukatorów i firmy w tworzeniu bardziej inkluzywnych i angażujących treści.
GSpeech jest również używany we wszystkich naszych angielskich stronach, możesz posłuchać tego artykułu i zobaczyć, jak dobrze GSpeech działa, klikając przycisk odtwarzania.
Twoje doświadczenie w dziedzinie projektowania VLSI (Very Large Scale Integration) i wczesne doświadczenie programistyczne położyły silne podwaliny techniczne. Co skłoniło Cię do zmiany z mikroelektroniki na tworzenie oprogramowania wspomaganego przez sztuczną inteligencję, i jak to doprowadziło do stworzenia GSpeech?
Moja pasja do rozwiązywania problemów zaczęła się w szkole średniej, zainspirowana miłością do matematyki i fizyki. To zainteresowanie doprowadziło mnie do uzyskania tytułu licencjata (2009) i magistra (2011) w dziedzinie projektowania VLSI na Państwowym Uniwersytecie Inżynieryjnym w Armenii, we współpracy z Synopsys Armenia. Studia fizyczne nauczyły mnie precyzji i myślenia analitycznego, ale to podczas drugiego roku studiów odkryłem programowanie — zaczynając od języka Pascal — i natychmiast się w nim zakochałem. Mój przyjaciel i ja wykonywaliśmy prace domowe natychmiast po ich otrzymaniu, chociaż mieliśmy sześć miesięcy na ich wykonanie. Następnie, dla zabawy, zaczęliśmy wykonywać prace innych studentów.
Ta pasja skierowała mnie głębiej w rozwój oprogramowania. Zaczynałem od tworzenia stron internetowych, następnie budowałem własny system zarządzania treścią. Po wykonaniu kilku projektów w dziedzinie automatyzacji procesów i projektowania architektur zarządzania danymi, zrozumiałem, jak bardzo kocham budowanie cyfrowych rozwiązań dla interfejsów internetowych. Przez projekt 2GLux współpracowałem z Edvardem Ananyanem — twórcą popularnej usługi tłumaczeń GTranslate i przyjacielem ze szkoły Quant Gymnasium. On wprowadził mnie w świat WordPressa i Joomy, a koncepcja GSpeech powstała właśnie z nim. Ta wczesna praca doprowadziła do pierwszej wersji naszego narzędzia, umożliwiającego użytkownikom słuchanie tekstu na stronie internetowej, sadząc ziarno tego, co później stało się pełnoprawną platformą sztucznej inteligencji. Do 2023 roku założyłem firmę Smarts Club LLC, aby skalować GSpeech w globalne rozwiązanie audio oparte na sztucznej inteligencji, wspierające ponad 70 języków. Pochwała ze strony Humanity Union za rolę GSpeech w poprawie dostępności ich platformy zaangażowania społecznego odzwierciedla moją misję budowania mostów między cyfrowymi podziałami za pomocą sztucznej inteligencji — wizję, która sięga moich wczesnych dni programowania.
GSpeech pierwotnie powstał jako narzędzie wspierające użytkowników z niepełnosprawnością wzroku. Jak ta wczesna misja wpłynęła na ewolucję platformy w pełnoprawne rozwiązanie tekst-to-speech?
Koncentracja na dostępności napędzała rozwój wysokiej jakości, czasu rzeczywistego audio sztucznej inteligencji, tłumaczeń na ponad 70 języków i bezproblemowej integracji ze stronami internetowymi za pomocą prostego kodu. Ta misja doprowadziła do funkcji takich jak dostosowywalne odtwarzacze audio, panele wyboru języka i głosu, świadoma odtwarzanie, pobieranie audio i szczegółowa analiza użycia — w tym dane kraju, miasta, urządzenia i analizy odtworzeń w czasie — wszystko to zostało zaprojektowane, aby uczynić treści bardziej inkluzywnymi i angażującymi. Po napisaniu ponad 100 000 linii kodu, uruchomiłem GSpeech Cloud Console w 2023 roku — skalowalne rozwiązanie, które balansuje inkluzywność z zaawansowaną funkcjonalnością, umożliwiając firmom i twórcom uczynienie ich treści bardziej dostępnymi, wielojęzycznymi i interaktywnymi w sieci.
Jakie były największe wyzwania techniczne, z którymi spotkałeś się podczas rozwoju GSpeech Cloud Console?
Jednym z największych wyzwań w rozwoju GSpeech Cloud Console było zaprojektowanie skalowalnej architektury dla generacji audio sztucznej inteligencji w czasie rzeczywistym. To wymagało innowacyjnych rozwiązań, aby pobrać odpowiednią treść z sieci, przetworzyć audio na naszych serwerach i przechowywać je w chmurze, aby zapewnić szybką i niezawodną dostawę. Wdrożenie solidnych środków bezpieczeństwa, takich jak szyfrowanie i kontrola dostępu, było kluczowe, aby chronić dynamiczną, generowaną przez użytkownika treść.
Kolejną przeszkodą było wdrożenie tłumaczeń w czasie rzeczywistym przy użyciu zaawansowanych silników neuronowych. Musieliśmy zapewnić niską latencję, dokładne tłumaczenia, a jednocześnie stworzyć intuicyjny interfejs, który pozwoli użytkownikom wybrać język i preferowany profil głosu do odtwarzania, priorytetem było komfort i personalizacja użytkownika. Na koniec opracowaliśmy kreator szablonu audio z wieloma dostosowywalnymi widokami odtwarzacza, pozwalając użytkownikom tworzyć unikalne, wizualnie atrakcyjne odtwarzacze dostosowane do ich stron internetowych. Balansowanie elastyczności, wydajności i łatwości użycia na różnych urządzeniach było satysfakcjonującym wyzwaniem.
Z tłumaczeniami w czasie rzeczywistym w ponad 70 językach i ponad 230 naturalnie brzmiącymi głosami. Jak zapewniasz jakość głosu i utrzymujesz dokładność w tak zróżnicowanym zestawie języków?
Aby utrzymać spójną jakość głosu, integrujemy wiele zaawansowanych modeli tekst-to-speech (TTS), które są nieustannie optymalizowane i aktualizowane. Te wielojęzyczne silniki radzą sobie z treściami wielojęzycznymi z wysoką dokładnością. Wprowadzamy również ponad 100 nowych wibracji głosu, aby dać użytkownikom jeszcze więcej ekspresyjnych i naturalnie brzmiących opcji. Każdego miesiąca GSpeech generuje ponad 200 milionów znaków audio, obsługując użytkowników w ponad 70 krajach, a nasze odtwarzacze online są używane ponad 200 000 razy miesięcznie — i rośnie. Ta skala zapewnia ciągłą informację zwrotną i testowanie w świecie rzeczywistym, które bezpośrednio wpływa na nasze strojenie i kontrolę jakości.
Czy możesz opowiedzieć, jak GSpeech wykorzystuje sztuczną inteligencję i uczenie maszynowe, aby dostarczyć prawdziwie naturalną syntezę głosu? Jak trzymasz się z tyłu za szybkimi postępami w technologiach głosu neuronowego?
GSpeech wykorzystuje zaawansowaną sztuczną inteligencję i uczenie maszynowe, integrując wiele najnowocześniejszych modeli tekst-to-speech, aby wyprodukować syntezę głosu, która brzmi naturalnie. Te modele, zoptymalizowane pod kątem naturalności i wielojęzyczności, przetwarzają dane wejściowe, aby wygenerować wysokiej jakości audio z realistyczną intonacją i rytmem, nawet dla treści wielojęzycznych. Wzmacniamy doświadczenie użytkownika, oferując dostosowywalne style głosu dla różnych języków. Zintegrowaliśmy również aliasy TTS, które pozwalają użytkownikom definiować niestandardowe reguły, aby określone słowa lub frazy były renderowane w audio — na przykład, zastępując określone terminy, aby osiągnąć bardziej dokładną wymowę lub frazowanie. Aby pozostać na bieżąco z technologiami głosu neuronowego, nieustannie oceniamy i integrujemy najnowsze postępy, współpracujemy z liderami branży i planujemy rozwijać własne modele w przyszłości, zapewniając, że GSpeech pozostaje na czele innowacji w syntezie głosu.
Jak ważne jest dostosowanie głosu, kontrola tonu i dostosowanie odtwarzania dla Twoich użytkowników — i jaki jest przypadek użycia, z którym jesteś najbardziej dumny, gdzie te funkcje naprawdę błyszczą?
Dostosowanie głosu, kontrola tonu i dostosowanie odtwarzania są kluczowe dla naszych użytkowników, umożliwiając im tworzenie unikalnych, wysokiej jakości stylów głosu dostosowanych do ich specyficznych potrzeb, od stron internetowych z wiadomościami i blogami po treści edukacyjne dostępne. Wprowadzanie ponad 100 nowych wibracji głosu jeszcze bardziej wzmacnia to, oferując użytkownikom niezrównaną elastyczność w tworzeniu naprawdę wyjątkowych nagraniów głosowych. Jestem najbardziej dumny z GSpeech Studio, nowej platformy edycji i generacji audio, nad którą obecnie pracuję. Pozwala użytkownikom tworzyć wiele kanałów audio, mieszać je z muzyką w tle i eksportować wykończone nagrania głosowe, umożliwiając twórcom produkcję profesjonalnych nagrań audio dla różnych zastosowań. List od ucznia z niepełnosprawnością wzroku, który dziękował GSpeech za umożliwienie niezależnej nauki dzięki dostosowanemu audio, dotknął mnie głęboko. Ten przypadek użycia pokazuje, jak te funkcje czynią treści dostępnymi i przekształcającymi, cel, który śledziłem od moich wczesnych dni programowania.
GSpeech oferuje bezproblemowe integracje z WordPress, Shopify , Wix i więcej. Jaka była Twoja strategia, aby uczynić platformę gotową do użycia dla twórców i firm w różnych ekosystemach?
Nasza strategia dla integracji GSpeech z platformami takimi jak WordPress, Shopify i Wix koncentrowała się na prostocie, kompatybilności i skalowalności. Rozwinięliśmy lekkie, modułowe wtyczki i fragmenty kodu, które integrują się bezproblemowo, wymagając minimalnej konfiguracji — często tylko kilku kliknięć. Oznacza to, że tysiące artykułów i dynamicznych bloków treści mogą natychmiast uzyskać wsparcie głosowe — bez ręcznej pracy. Oferujemy bardzo elastyczne, pięknie zaprojektowane odtwarzacze, które dostosowują się do urządzeń, w tym urządzeń mobilnych, tabletów i komputerów stacjonarnych. Nasze odtwarzacze nie tylko są dostosowywalne, ale także zoptymalizowane pod kątem dostępności i zaangażowania użytkownika. Dla WordPressa osadziliśmy pulpity GSpeech bezpośrednio w panelu administracyjnym za pomocą naszej wtyczki, ułatwiając zarządzanie użytkownikom. Szczegółowa dokumentacja i intuicyjne pulpity prowadzą użytkowników niebędących specjalistami od techniki przez instalację i dostosowanie. Regularne testy zapewniają spójną wydajność w różnych ekosystemach, umożliwiając twórcom i firmom łatwe dodanie funkcji tekst-to-speech wspomaganej przez sztuczną inteligencję.
Patrząc wstecz na podróż od 2012 do dziś, co było największym kamieniem milowym dla Ciebie osobiście lub zawodowo w budowaniu GSpeech?
Największym kamieniem milowym dla GSpeech było wygenerowanie 1 miliarda znaków wysokiej jakości audio sztucznej inteligencji, pokazujące nasz globalny wpływ na dostępność. Równie istotne było opinie, które otrzymaliśmy od organizacji takich jak Humanity Union, które pochwalili GSpeech za poprawę dostępności ich platformy zaangażowania społecznego, oraz od właścicieli blogów, którzy określili go jako „zmianę gry” dla zaangażowania użytkowników. Ponad 110 recenzji pięciogwiazdkowych na platformach takich jak WordPress i AppSumo w ostatnich miesiącach odzwierciedlają to rosnące zaufanie.
GSpeech jest teraz również aktywnie używany przez Namangan regional statistics department in Uzbekistan — instytucję rządową o znaczącym ruchu i widoczności na poziomie krajowym. Widząc, jak instytucja publiczna przyjmuje naszą technologię na tak szeroką skalę, było dla mnie istotnym kamieniem milowym i potężnym znakiem zaufania do naszego rozwiązania.
Jako chrześcijanin i osoba, która służy w ormiańskim kościele, staram się również wspierać inne inicjatywy związane z wiarą, gdy tylko jest to możliwe. Często oferuję GSpeech bezpłatnie stronom internetowym chrześcijańskim jako sposób, aby pomóc im w skuteczniejszym przekazie swojej wiadomości i uczynieniu Pisma bardziej dostępnym za pomocą audio. To mój mały wkład w coś większego. Jednocześnie jestem zaszczycony współpracą z poświęconymi ministerstwami, takimi jak The Cord — związek mesjanistyczny i cenny klient GSpeech — których misja i treści odzwierciedlają moc Pisma w działaniu.
Te momenty — kiedy technologia staje się mostem między wiarą, zrozumieniem i inkluzją — przypominają mi, dlaczego zbudowaliśmy GSpeech od samego początku.
Jaką rolę widzisz dla GSpeech w przyszłości mediów cyfrowych, szczególnie gdy treści audio i interfejsy głosowe stają się coraz bardziej dominujące?
Widzę GSpeech jako lidera w czynieniu mediów cyfrowych bardziej dostępnymi i angażującymi, umożliwiając dostęp do sieci za pomocą sztucznej inteligencji. Naszym celem jest przekształcenie całego doświadczenia online, tak aby strony internetowe stały się naturalnie interaktywne, inkluzywne i wielojęzyczne domyślnie. Z tylko jedną linią kodu, właściciele stron mogą przekształcić tysiące artykułów w treści z włączoną funkcją głosową. Patrząc w przyszłość, rozwijamy GSpeech Studio w potężną i unikalną platformę generacji i edycji audio, umożliwiając użytkownikom tworzenie wielowarstwowych treści audio z muzyką w tle, efektami i precyzyjnym strojeniem. Chcemy uczynić sieć naprawdę słyszalną, intuicyjną i powszechnie dostępną.
GSpeech niedawno został uruchomiony na AppSumo i już zdobył niemal idealną ocenę od wczesnych adoptujących. Co oznacza dla Ciebie odpowiedź społeczności AppSumo, i jak planujesz wykorzystać ten impet w przyszłości?
Uruchomienie GSpeech na AppSumo wprowadziło naszą platformę do milionów oczu, a niemal idealna ocena jest niezwykle potwierdzająca. Użytkownicy, tacy jak ci, którzy prowadzą kursy online, chwalą nasze intuicyjne narzędzia i responsywny serwis, powtarzając opinie Humanity Union. Właściciel bloga określił nasze głosy jako „prawdziwie angażujące” i tłumaczenia jako „imponujące”. Ich pozytywna opinia potwierdza wartość naszego rozwiązania tekst-to-speech wspomaganego przez sztuczną inteligencję i wzmacnia moją pasję do projektu. Wspieranie klientów podczas uruchomienia również zainspirowało nowe pomysły, szczególnie dla GSpeech Studio, który został zainspirowany przez prośby użytkowników o zaawansowane funkcje edycji i eksportu audio. W przyszłości planuję wykorzystać ten impet, aktywnie słuchając naszej społeczności, integrując ich opinie i rozwijając innowacyjne funkcje, aby poprawić dostępność i zaangażowanie, zapewniając, że GSpeech będzie nadal ewoluował jako przełomowe narzędzie dla twórców i firm.
Na koniec, jaki poradziłbyś młodym deweloperom lub przedsiębiorcom, którzy chcą budować dostępne, wspomagane przez sztuczną inteligencję narzędzia w dzisiejszym dynamicznym krajobrazie technologicznym?
Młodym deweloperom i przedsiębiorcom radziłbym wlać serce w swoją pracę i zidentyfikować prawdziwy problem, którym mogą zaproponować unikalne, inteligentne rozwiązanie. Zacznijcie od małych kroków, idźcie stale do przodu i słuchajcie uważnie opinii klientów — oni poprowadzą waszą drogę. Traktujcie swoich użytkowników jak zaufanych przyjaciół, dajcie z siebie wszystko i pozostawajcie cierpliwi. Przyjmijcie technologie sztucznej inteligencji jako potężnych sojuszników; gdy są używane mądrze, wzmacniają waszą zdolność do tworzenia wpływowych, dostępnych narzędzi. Budujcie z pasją, wytrwałością i zaangażowaniem w tworzenie różnicy, a stworzycie rozwiązania, które naprawdę mają znaczenie.
Dziękuję za wspaniały wywiad, wybraliśmy rozwiązanie GSpeech dla naszej strony internetowej ze względu na łatwą integrację. Aby dowiedzieć się więcej, odwiedź GSpeech.


