
Kąt Andersona
Wydajniejsze usuwanie obiektów z wideo dzięki uczeniu maszynowemu

 Dodaj Unite.AI do preferowanych źródeł w Google
Kluczowe punktyE2FGVI łączy trzy etapy uzupełniania wideo w jeden kompleksowy system typu end-to-end…
Zobacz więcej
- E2FGVI łączy trzy etapy uzupełniania wideo w jeden kompleksowy system typu end-to-end, zapewniając znaczący wzrost wydajności.
- System działa piętnaście razy szybciej niż wcześniejsze metody oparte na przepływie optycznym, osiągając jednocześnie wyniki na najwyższym poziomie.
- Nowatorski transformator ogniskowy czasowo rozszerza uwagę z 2D do 3D, umożliwiając spójne generowanie treści między klatkami.
Naukowcy z Chin donoszą o wynikach badań, które przynoszą najlepsze wyniki w tej dziedzinie, a także imponującą poprawę wydajności nowego systemu inpaintingu wideo, który może sprawnie usuwać obiekty z nagrania.
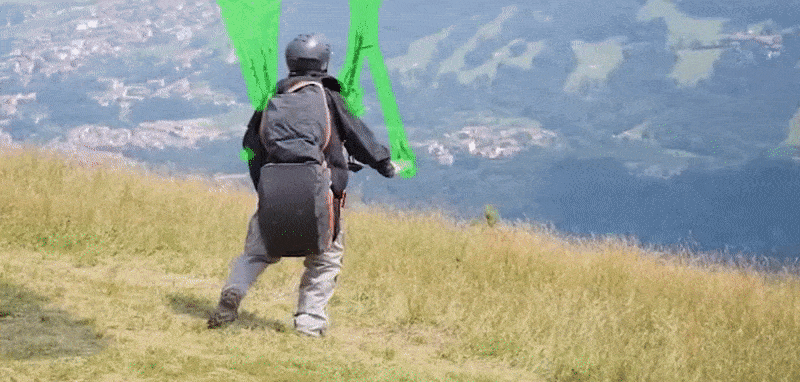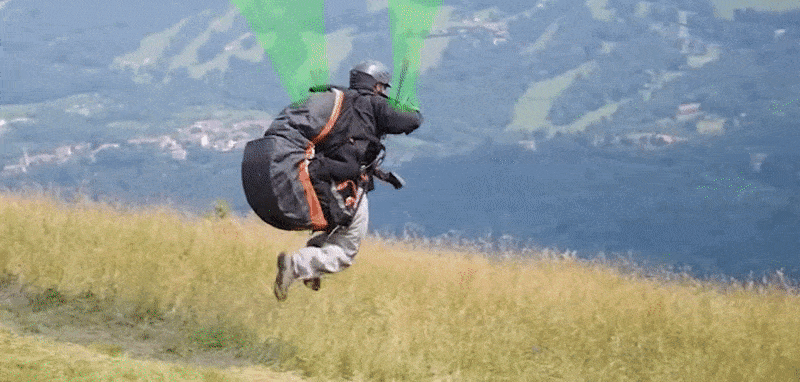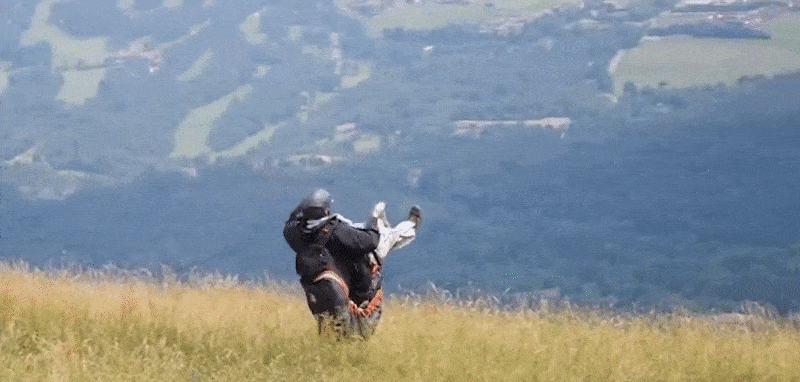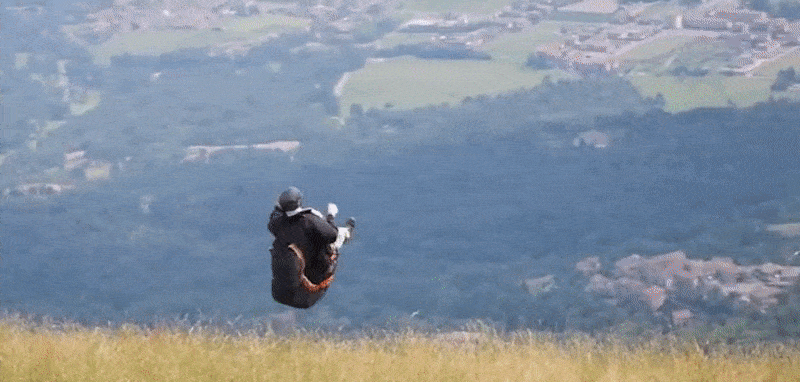
Uprząż lotniarza zostaje usunięta z obrazu przez nową procedurę. Zobacz źródłowe wideo w lepszej rozdzielczości i więcej przykładów. Źródło: https://www.youtube.com/watch?v=N–qC3T2wc4
Technika ta, zwana ramą End-to-End dla Flow-Guided video Inpainting (E2FGVI), jest również w stanie usuwać znaki wodne i inne rodzaje zakryć z zawartości wideo.
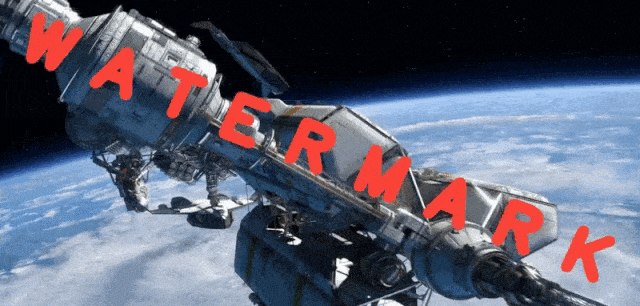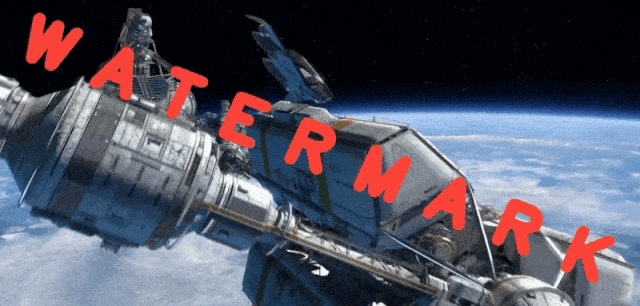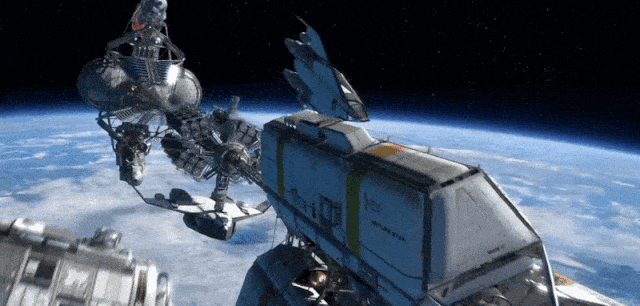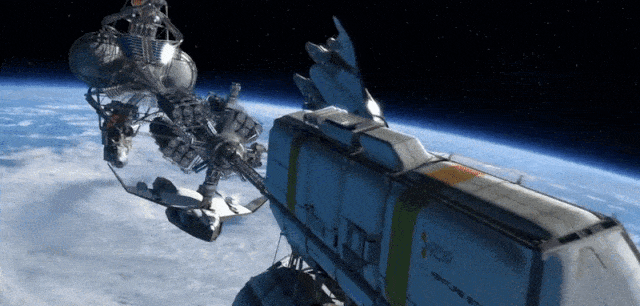
E2FGVI oblicza predykcje dla treści, która leży za zakryciami, umożliwiając usunięcie nawet wyraźnych i trudnych do usunięcia znaków wodnych. Źródło: https://github.com/MCG-NKU/E2FGVI
(Aby zobaczyć więcej przykładów w lepszej rozdzielczości, sprawdź wideo)
Chociaż model przedstawiony w opublikowanym artykule został przeszkolony na filmach wideo o rozdzielczości 432px x 240px (powszechnie niskie rozdzielczości, ograniczone dostępną przestrzenią GPU w stosunku do optymalnych rozmiarów partii i innych czynników), autorzy opublikowali E2FGVI-HQ, który może obsługiwać filmy wideo w dowolnej rozdzielczości.
Kod dla bieżącej wersji jest dostępny na GitHubie, a wersja HQ, opublikowana w ubiegłą niedzielę, może być pobrana z Google Drive i Baidu Disk.

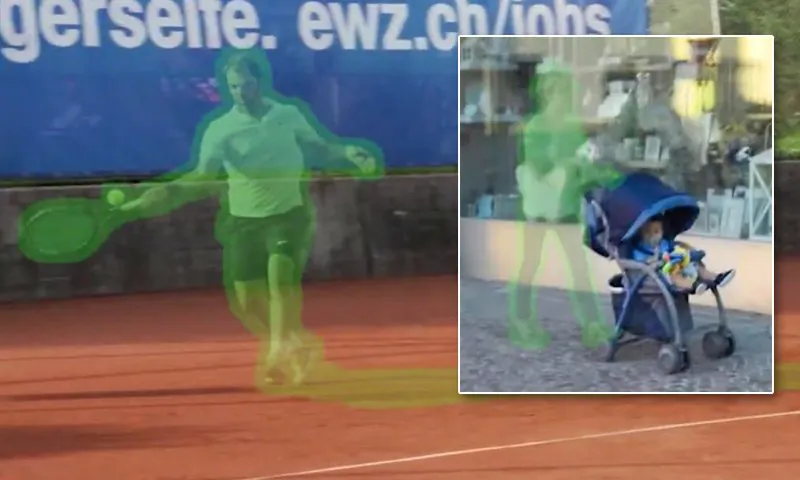
Dziecko pozostaje na zdjęciu.
E2FGVI może przetwarzać filmy wideo o rozdzielczości 432×240 w czasie 0,12 sekund na klatkę na karcie graficznej Titan XP (12GB VRAM), a autorzy donoszą, że system działa piętnaście razy szybciej niż wcześniejsze najnowocześniejsze metody oparte na przepływie optycznym.
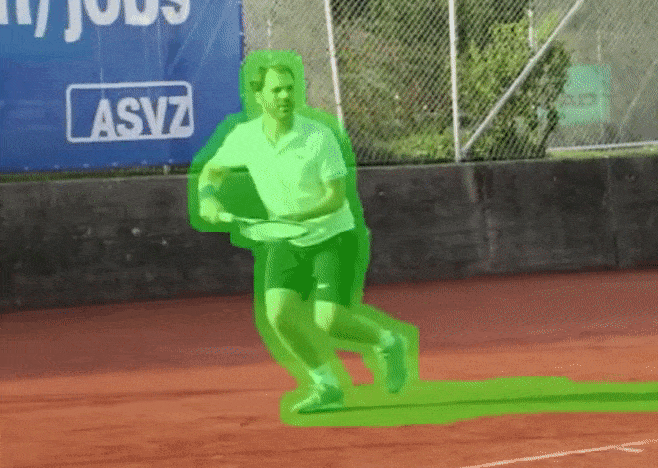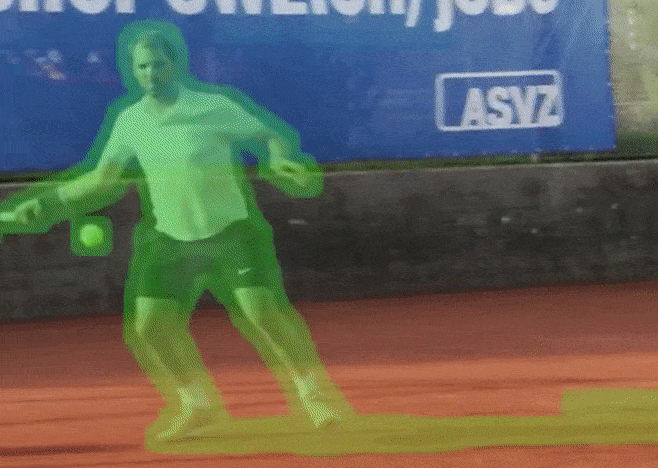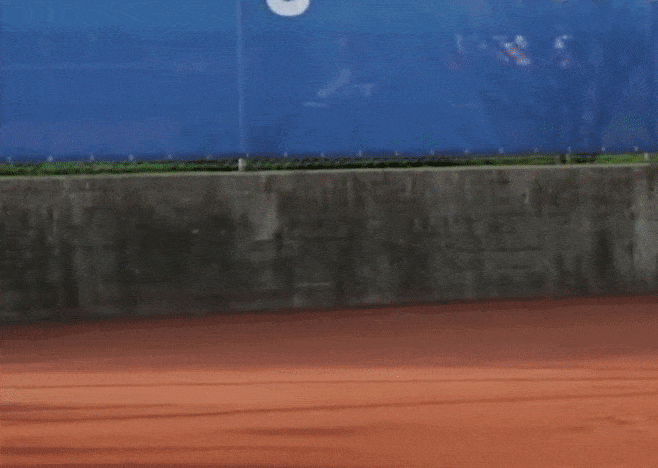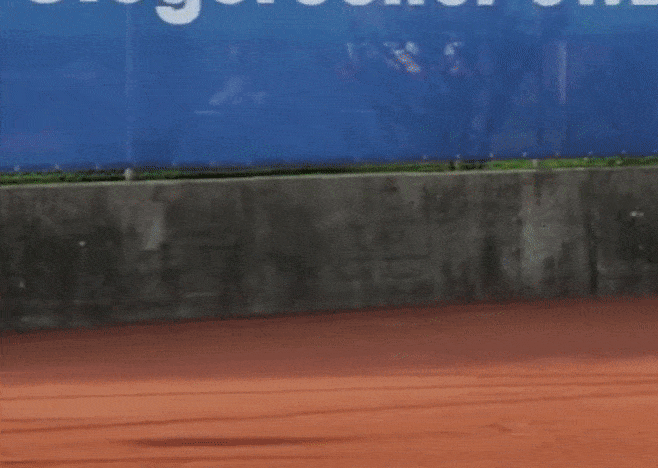
Tenisista robi niespodziewane wyjście.
Testowana na standardowych zbiorach danych dla tej poddziedziny badań nad syntezą obrazu, nowa metoda była w stanie wyprzedzić rywali zarówno w jakościowych, jak i ilościowych rundach oceny.

Testy przeciwko poprzednim podejściom. Źródło: https://arxiv.org/pdf/2204.02663.pdf
Artykuł nosi tytuł Towards An End-to-End Framework for Flow-Guided Video Inpainting i jest współpracą czterech naukowców z Uniwersytetu Nankai, wraz z naukowcem z Hisilicon Technologies.
Czego brakuje na tym obrazie
Oprócz oczywistych zastosowań w efektach wizualnych, wysokiej jakości inpainting wideo ma szansę stać się podstawową cechą nowych technologii syntezowania i modyfikowania obrazu opartych na sztucznej inteligencji.
To jest szczególnie prawdziwe w przypadku aplikacji modyfikujących ciało, takich jak moda, i innych ram, które starają się wyszczuplać sylwetki lub w inny sposób zmodyfikować sceny w obrazach i filmach wideo. W takich przypadkach konieczne jest przekonujące ‘wypełnienie’ dodatkowego tła, które zostaje odsłonięte przez syntezę.

W niedawnej pracy algorytm zmiany kształtu ciała ma za zadanie uzupełnić nowo odsłonięte tło po zmianie rozmiaru postaci. Brakujący obszar oznaczono czerwonym konturem: wcześniej zajmowała go rzeczywista osoba o pełniejszej sylwetce (patrz obraz po lewej). Na podstawie materiału źródłowego z https://arxiv.org/pdf/2203.10496.pdf
Spójny przepływ optyczny
Przepływ optyczny (OF) stał się podstawową technologią w rozwoju usuwania obiektów z filmów wideo. Jak atlas, OF zapewnia jednorazową mapę sekwencji czasowej. Często używany do pomiaru prędkości w inicjatywach komputerowego widzenia, OF może również umożliwić spójne wypełnianie w czasie, gdzie zadanie jako całość może być rozpatrywane w jednym przejściu, zamiast pracy klatka po klatce w stylu animacji Disneya, co nieuchronnie prowadzi do nieciągłości czasowej.
Metody inpaintingu wideo dotychczas koncentrowały się na trzystopniowym procesie: kompletacji przepływu, gdzie film wideo jest zasadniczo mapowany na dyskretny i eksplorowalny obiekt; propagacji pikseli, gdzie dziury w ‘uszkodzonych’ filmach wideo są wypełniane przez dwukierunkową propagację pikseli; i halucynacji treści (wynalazek pikseli, który jest znany większości z deepfake’ów i ram text-to-image, takich jak seria DALL-E) gdzie oszacowana ‘brakująca’ treść jest wymyślana i wstawiana do filmu.
Centralną innowacją E2FGVI jest połączenie tych trzech etapów w systemie end-to-end, eliminując potrzebę ręcznych operacji na treści lub procesie.

Artykuł zauważa, że potrzeba interwencji ręcznej sprawia, że starsze procesy nie korzystają z GPU, co sprawia, że są one dość czasochłonne. Z artykułu*:
‘Przyjmując DFVI jako przykład, ukończenie jednego filmu wideo o rozdzielczości 432 × 240 z DAVIS, które zawiera około 70 klatek, wymaga około 4 minut, co jest nie do przyjęcia w większości aplikacji świata rzeczywistego. Ponadto, poza wymienionymi wyżej wadami, tylko używanie wstępnie przeszkolonej sieci inpaintingu obrazu na etapie halucynacji treści ignoruje relacje treści między sąsiadami czasowymi, prowadząc do nieciągłej generowanej treści w filmach wideo.’
Łącząc trzy etapy inpaintingu wideo, E2FGVI jest w stanie zastąpić drugi etap, propagację pikseli, propagacją cech. W bardziej podzielonych procesach poprzednich prac, cechy nie są tak szeroko dostępne, ponieważ każdy etap jest względnie hermetyczny, a przepływ pracy jest tylko półautomatyczny.
Ponadto, badacze opracowali transformer ogniskowy czasowy dla etapu halucynacji treści, który rozważa nie tylko bezpośrednich sąsiadów pikseli w bieżącej klatce (tj. co się dzieje w tej części klatki w poprzedniej lub następnej klatce), ale także odległych sąsiadów, którzy są oddaleni o wiele klatek i którzy będą wpływać na spójny efekt wszelkich operacji wykonywanych na filmie wideo jako całości.

Architektura E2FGVI.
Nowy centralny sektor przepływu pracy oparty na cechach może wykorzystywać więcej procesów na poziomie cech oraz uczone przesunięcia próbkowania, podczas gdy nowy transformer ogniskowy, według autorów, rozszerza rozmiar okien ogniskowych ‘z 2D do 3D’.
Testy i dane
Aby przetestować E2FGVI, badacze ocenili system w stosunku do dwóch popularnych zbiorów danych do segmentacji obiektów wideo: YouTube-VOS i DAVIS. YouTube-VOS zawiera 3741 klipów szkoleniowych, 474 klipy walidacyjne i 508 klipów testowych, podczas gdy DAVIS zawiera 60 klipów szkoleniowych i 90 klipów testowych.
E2FGVI został przeszkolony na YouTube-VOS i oceniony na obu zbiorach danych. Podczas szkolenia, maski obiektów (zielone obszary na powyższych obrazach i towarzyszące wideo na YouTube) zostały wygenerowane w celu symulacji ukończenia wideo.
Dla metryk, badacze przyjęli szczytowy stosunek sygnału do szumu (PSNR), podobieństwo strukturalne (SSIM), opartą na wideo odległość Fréchet Inception (VFID) i błąd przekształcenia przepływu – ten ostatni w celu pomiaru stabilności czasowej w zmienionym filmie wideo.
Poprzednie architektury, w stosunku do których system został przetestowany, to VINet, DFVI, LGTSM, CAP, FGVC, STTN i FuseFormer.

Z sekcji wyników ilościowych artykułu. Strzałki w górę i w dół wskazują, że wyższe lub niższe liczby są lepsze, odpowiednio. E2FGVI osiąga najlepsze wyniki we wszystkich kategoriach. Metody są oceniane zgodnie z FuseFormer, chociaż DFVI, VINet i FGVC nie są systemami end-to-end, co uniemożliwia oszacowanie ich FLOPs.
Ponadto autorzy przeprowadzili jakościowe badanie z udziałem użytkowników, w której filmy wideo przekształcone pięcioma reprezentatywnymi metodami były pokazywane indywidualnie dwudziestu wolontariuszom, którzy zostali poproszeni o ocenę ich pod względem jakości wizualnej.

Oś pionowa reprezentuje procent uczestników, którzy preferowali wynik E2FGVI pod względem jakości wizualnej.
Autorzy zauważają, że pomimo jednomyślnego preferowania ich metody, jeden z wyników, FGVC, nie odzwierciedla wyników ilościowych, i sugerują, że może to wskazywać, że E2FGVI może, pozornie, generować ‘bardziej przyjemne wizualnie wyniki’.
Pod względem wydajności, autorzy zauważają, że ich system znacznie redukuje operacje zmiennoprzecinkowe na sekundę (FLOPs) i czas inferencji na jednej karcie graficznej Titan na zbiorze danych DAVIS, i obserwują, że wyniki pokazują, że E2FGVI działa piętnaście razy szybciej niż metody oparte na przepływie.
Komentują:
‘[E2FGVI] posiada najniższe FLOPs w porównaniu z wszystkimi innymi metodami. To wskazuje, że proponowana metoda jest bardzo wydajna dla inpaintingu wideo.’
*Moja konwersja odwołań bibliograficznych autorów w tekście do linków.
Pierwotnie opublikowane 19 maja 2022.
Zmienione we wtorek, 28 października 2025, w celu usunięcia błędnego osadzenia wideo i zmiany odniesień do osadzonego wideo w treści artykułu.


