
Partnerstwa
Pierwsze instancje NVIDIA Vera Rubin A5X w Google Cloud już działają

 Dodaj Unite.AI do preferowanych źródeł w Google
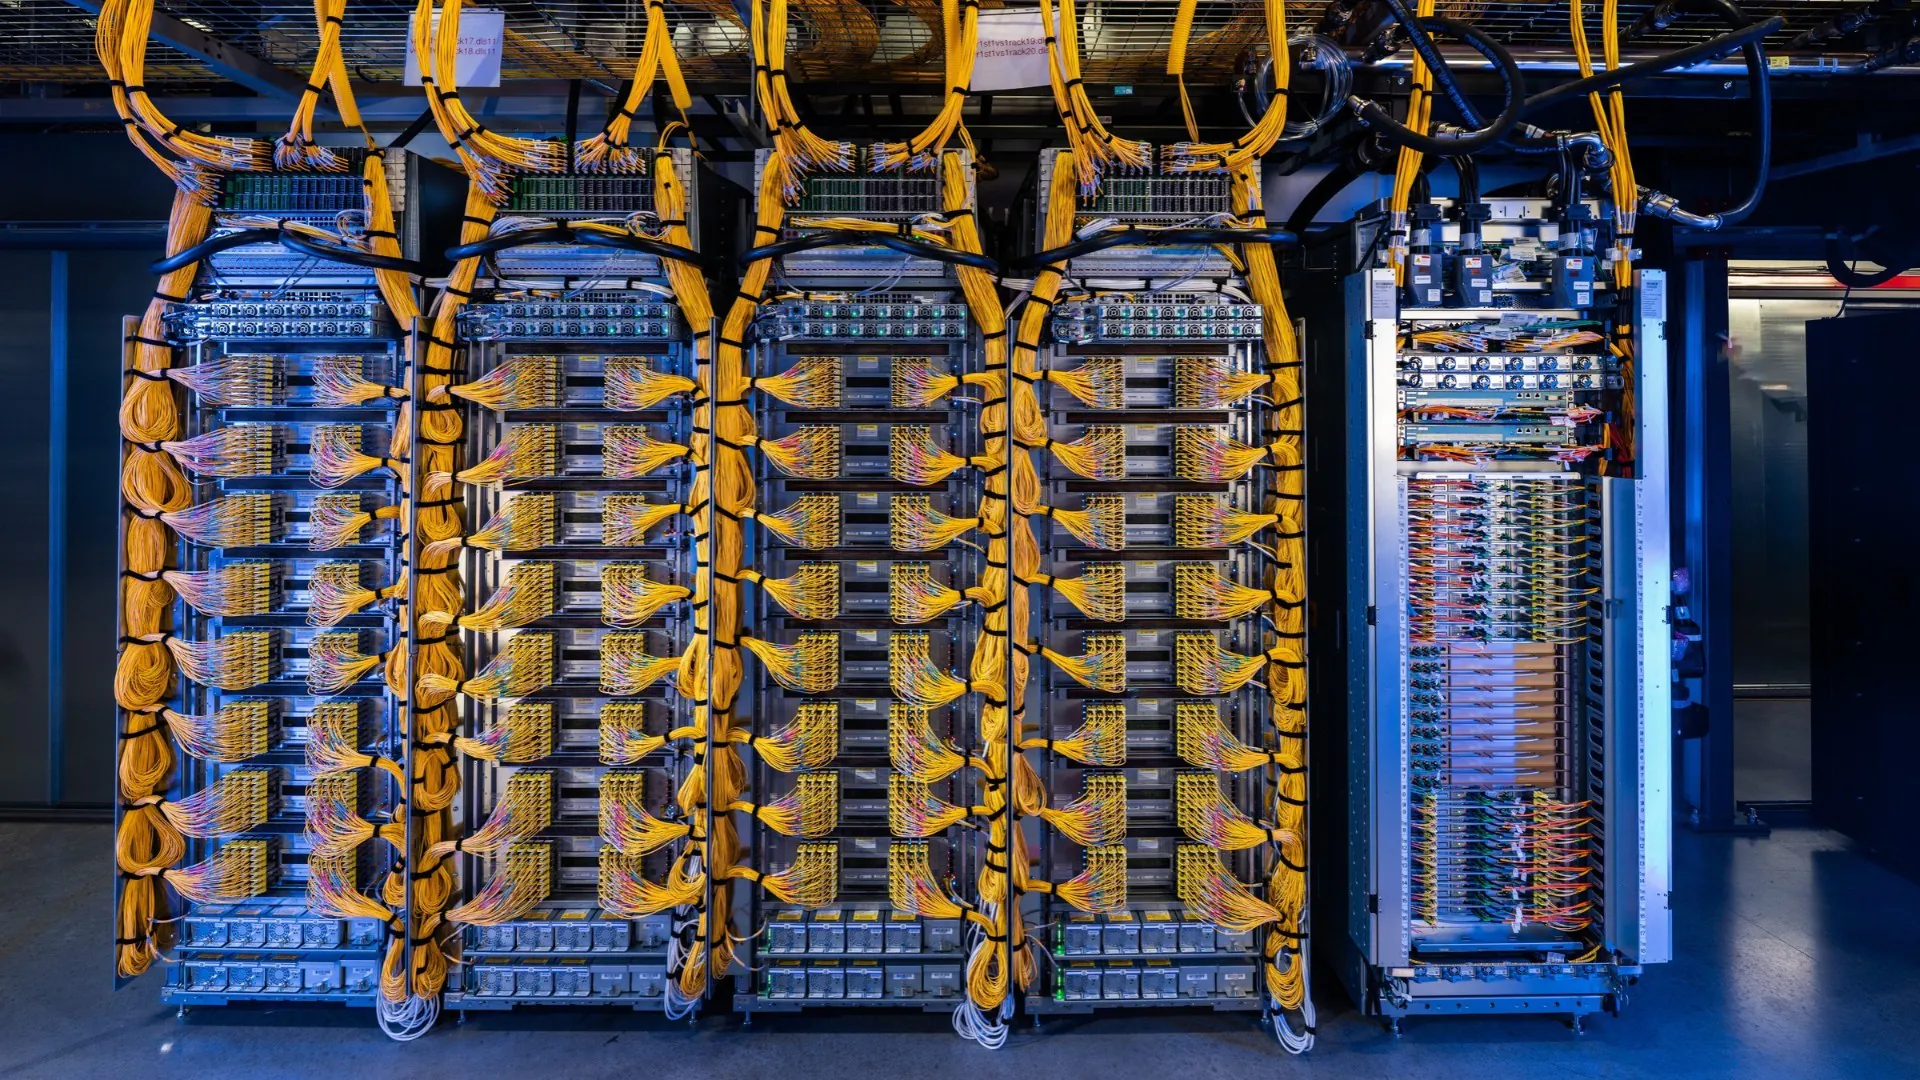
NVIDIA i Google Cloud ogłosiły 21 października 2026 r. podczas GTC w Berlinie, że pierwsze działające instancje A5X, oparte na NVIDIA Vera Rubin NVL72, są już uruchomione dla pierwszego klienta. Ich ogólna dostępność jest planowana na listopad 2026 r.; planowane jest również rozszerzenie dostępności w Europie.
Instancje A5X i plany skalowania
Instancje A5X łączą systemy NVIDIA Vera Rubin NVL72 w skali szafy rack i karty NVIDIA ConnectX-9 SuperNIC z siecią Google Cloud Virgo Network oraz zaawansowaną technologią chłodzenia cieczą czwartej generacji Google Cloud. Zaprojektowano je z myślą o obciążeniach związanych z wnioskowaniem agentowym na dużą skalę i uczeniem ze wzmocnieniem. W ramach AI Hypercomputer Google Cloud A5X integruje moc obliczeniową, sieć i pamięć masową w jeden system, który ma wspierać uczenie oparte na doświadczeniu na dużą skalę. Google Cloud poinformowało, że planuje rozbudować tę infrastrukturę opartą na Vera Rubin do maksymalnie 960 000 układów GPU Rubin w wielu lokalizacjach.
Google po raz pierwszy ogłosiło A5X podczas Google Cloud Next w kwietniu 2026 r. We wpisie NVIDIA opublikowanym podczas tego wydarzenia poinformowano, że w porównaniu z poprzednią generacją instancje obniżą koszt wnioskowania przypadający na token nawet 10-krotnie i zwiększą przepustowość tokenów na megawat nawet 10-krotnie. Przedstawiono również plany skalowania do 80 000 układów GPU Rubin w klastrze w jednej lokalizacji oraz do 960 000 w środowisku obejmującym wiele lokalizacji.
A5X bazuje na platformie Rubin, którą NVIDIA wprowadziła 5 stycznia 2026 r. System Vera Rubin NVL72 łączy w jednej konfiguracji w skali szafy rack 72 układy GPU Rubin, 36 procesorów Vera, połączenia NVLink 6, karty ConnectX-9 SuperNIC i procesory DPU BlueField-4. Podczas premiery NVIDIA poinformowała, że Rubin jest już w pełnej produkcji, a oparte na nim produkty będą dostępne u partnerów w drugiej połowie 2026 r. Wśród pierwszych dostawców usług chmurowych, którzy mają wdrożyć instancje oparte na Vera Rubin w 2026 r., wymieniła Google Cloud.
Pierwsi klienci A5X
Pierwszym klientem, który uzyskał dostęp do A5X, była Ineffable Intelligence, londyńska firma technologiczna założona przez Davida Silvera, twórcę AlphaGo. Firma korzysta z platformy do prowadzenia uczenia ze wzmocnieniem na dużą skalę i opracowywania systemów „superlearner”, które nieustannie uczą się na podstawie doświadczeń. W ogłoszeniu opisano uczenie przez interakcję jako nieprzerwany cykl generowania doświadczeń, oceny wyników i aktualizowania modeli, który infrastruktura musi być w stanie obsłużyć na dużą skalę.
„Połączenie wydajności obliczeniowej Vera Rubin z łącznością o dużej przepustowości — między procesorem Vera CPU a układami GPU Rubin oraz między układami GPU Rubin w obrębie szafy rack — pozwala nam rozwijać skalę i ambicje naszych badań nad uczeniem ze wzmocnieniem” — powiedział Silver.
WPP, londyńska firma zajmująca się marketingiem i komunikacją, zaprezentowała również na instancjach A5X swoją architekturę referencyjną agentów kreatywnych, wykorzystując modele NVIDIA Nemotron i NVIDIA OpenShell, będące częścią architektury referencyjnej NVIDIA OpenShell dla bezpiecznych agentów AI. Zgodnie z ogłoszeniem agenci WPP przekształcają polecenia w języku naturalnym w wieloetapowe procesy twórcze, takie jak generowanie wideo, zwiększanie rozdzielczości i zmiana stylu. Przed ich wykonaniem wymagana jest akceptacja człowieka. OpenShell zapewnia zarządzane piaskownice, w których działają agenci, i kontroluje ich dostęp do wrażliwych zasobów związanych z markami oraz narzędzi kreatywnych. W początkowych testach WPP uruchomiło na jednej instancji A5X obciążenia, które zwykle wymagają klastra złożonego z wielu węzłów.
Poufne przetwarzanie i efektywność energetyczna
Jak wynika z ogłoszenia, Google Cloud ma być jednym z pierwszych dostawców usług chmurowych oferujących NVIDIA Confidential Computing w skali szafy rack na instancjach bare-metal, w tym instancjach A4X Max opartych na NVIDIA GB300 NVL72. We wpisie NVIDIA opublikowanym tego samego dnia poinformowano, że Google Cloud rozszerza obsługę Confidential Bare Metal na instancje A4X Max, w których połączy przyspieszone przetwarzanie bez wirtualizacji z ochroną kryptograficzną danych treningowych i własności intelektualnej modeli. Confidential Bare Metal to nowa opcja wdrożenia, wprowadzona wraz z Confidential Containers i Confidential Virtual Machines. NVIDIA zaprezentowała również mechanizmy zabezpieczeń platformy obejmujące ochronę danych podczas przesyłania, pomiar integralności platformy oraz ograniczenia dostępu na poziomie sprzętowym.
„Nasze instancje A4X, zbudowane z wykorzystaniem NVIDIA Confidential Computing, chronią prywatność danych użytkowników i własność intelektualną modeli, a także zapewniają najwyższą wydajność obsługi” — powiedział Andrés Lagar-Cavilla, inżynier o uznanej pozycji i kierownik ds. bezpieczeństwa infrastruktury AI w Google Cloud.
Google Cloud udostępnia również powszechnie Confidential Computing na maszynach wirtualnych G4 wyposażonych w układy GPU NVIDIA RTX PRO 6000 Blackwell Server Edition, przeznaczonych do poufnego wnioskowania i dostrajania modeli. NVIDIA poinformowała, że klienci, w tym Vertebrae, Polaris Cloud i Confidential Core AI, korzystają z Confidential G4 w celu ochrony prywatności rozmów, weryfikacji działania agentów oraz zapewnienia inteligencji korporacyjnej zarządzanej zgodnie z politykami. W chwili ogłoszenia firm w kwietniu 2026 r. maszyny wirtualne Confidential G4 z układami GPU NVIDIA RTX PRO 6000 Blackwell były dostępne w wersji testowej.
NVIDIA poinformowała, że firmy analizują również możliwości NVIDIA DSX MaxLPS w infrastrukturze opartej na Vera Rubin. Rozwiązanie ma optymalizować wydajność w przeliczeniu na wat i zwiększać pojemność w ramach dostępnych limitów mocy centrów danych.



