
Kąt Andersona
Unikalne rozwiązanie DALL-E 2 dla podwójnych znaczeń

 Dodaj Unite.AI do preferowanych źródeł w Google
Kluczowe punktyDALL-E 2 dzieli niejednoznaczne słowa, takie jak 'bat', na wiele obiektów na jednym…
Zobacz więcej
- DALL-E 2 dzieli niejednoznaczne słowa, takie jak 'bat', na wiele obiektów na jednym obrazie.
- Ten błąd semantyczny pogłębia się, gdy modele kierowane przez CLIP są trenowane na większych zbiorach danych.
- Ponad 80% obrazów DALL-E 2 zawierających homonimy wykazywało niezamierzone podwójne interpretacje.
Każdy, kto uczy się włoskiego, szybko uczy się zwracać uwagę na kontekst, gdy opisujemy miotłę, ponieważ włoskie słowo dla tego zwyczajnego przedmiotu domowego ma ekstremalnie nieodpowiednie drugie znaczenie jako czasownik*. Chociaż uczymy się wcześnie rozplatać semantyczne mapowanie i (odpowiednie) stosowalność słów o wielu znaczeniach, nie jest to umiejętność, którą łatwo można przekazać systemom syntezy obrazów działającym w ogromnej skali, takim jak DALL-E 2 i Stable Diffusion, ponieważ polegają one na module Contrastive Language–Image Pre-training (CLIP), który traktuje obiekty i ich właściwości raczej luźno (jednak coraz bardziej zyskuje w obszarze syntezy obrazów i filmów metodą dyfuzji w przestrzeni ukrytej.
Badając tę lukę, nowe badanie z Bar-Ilan University i Allen Institute for Artificial Intelligence oferuje obszerną analizę stopnia, w jakim DALL-E 2 jest skłonny do takich błędów semantycznych:

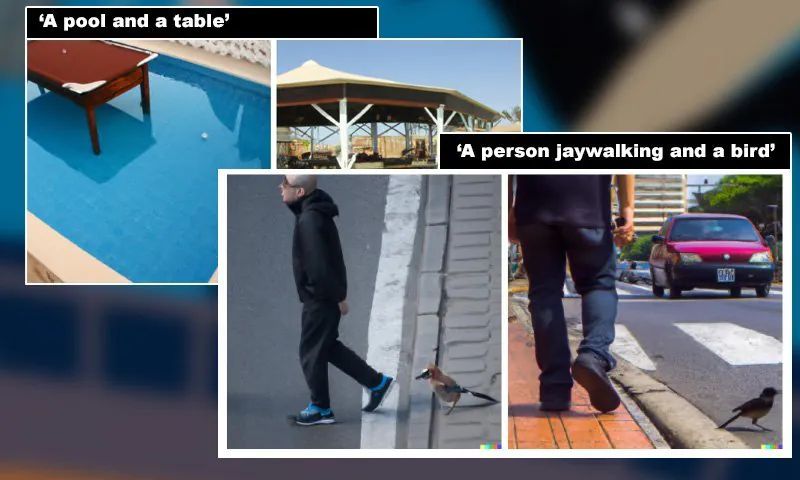
Podwójne znaczenia rozdzielone na wiele interpretacji w DALL-E 2 – choć każdy system dyfuzji w przestrzeni ukrytej może wygenerować takie przykłady. W górnej prawej części obrazu, usunięcie ‘gold’ z podpowiedzi zmienia gatunek ryb, podczas gdy w przypadku ‘zebra crossing’ konieczne jest jawnie określenie powierzchni drogi, aby usunąć zdublowaną asociację. Źródło: https://export.arxiv.org/pdf/2210.10606
Autorzy odkryli, że ta tendencja do podwójnej interpretacji słów i fraz wydaje się nie tylko wspólna dla wszystkich modeli dyfuzyjnych sterowanych przez CLIP, ale także, że staje się gorsza, gdy modele są szkolone na coraz większych ilościach danych. W artykule zauważa się, że ‘zmniejszone’ wersje modeli przekształcających tekst w obraz, w tym DALL-E Mini (obecnie Craiyon), generują te błędy znacznie rzadziej, a Stable Diffusion również mniej błędów – choć tylko dlatego, że często nie wykonuje podpowiedzi, co jest innym rodzajem błędu.

Prosta podpowiedź ‘date’ zmusza DALL-E 2 do wywołania dwóch z kilku znaczeń słowa, podczas gdy słowo ‘fan’ również dzieli się na dwa jego semantyczne mapowania, a w trzecim obrazie fraza ‘cone’ niezawodnie zmienia nieokreślone wcześniej jedzenie w podpowiedzi w lody, które są skojarzone z ‘cone’.
Wyjaśniając, jak wykonujemy wydajne separacje leksykalne, artykuł stwierdza:
‘Podczas gdy symbole – oraz struktury zdaniowe – mogą być niejednoznaczne, po zbudowaniu interpretacji niejednoznaczność ta jest już rozwiązana. Na przykład, podczas gdy angielskie słowo bat w wyrażeniu a flying bat może być interpretowany jako albo drewniany kij, albo zwierzę, nasze możliwe interpretacje zdania są albo latający drewniany kij, albo latające zwierzę, ale nigdy oba jednocześnie. Gdy słowo bat zostało użyte w interpretacji, aby określić obiekt (na przykład drewniany kij), nie może być ponownie użyte do określenia innego obiektu (zwierzęcia) w tej samej interpretacji.’
DALL-E 2, jak zauważa artykuł, nie jest ograniczony w ten sposób:

‘A bat is flying over a baseball stadium’ – pierwszy obraz pochodzi z artykułu, a trzy kolejne uzyskano przez proste wprowadzenie tej samej podpowiedzi do DALL-E 2.
Ta właściwość została nazwana czułością na zasoby.
Autorzy identyfikują trzy nieprawidłowe zachowania wykazywane przez DALL-E 2: że słowo lub fraza mogą być interpretowane i skutecznie rozwidlane na dwa odrębne obiekty, renderując obiekt lub pojęcie dla każdego w tej samej scenie; że słowo może być interpretowane jako modyfikator dwóch różnych obiektów (patrz przykłady powyżej); i że słowo może być interpretowane jednocześnie jako modyfikator i alternatywny obiekt – ilustrowane przez podpowiedź ‘a seal is opening a letter’:

‘A seal is opening a letter’ – pierwsza ilustracja pochodzi z artykułu, a trzy sąsiednie to identyczne reprodukcje z DALL-E 2. Fotorealistyczne przykłady poniżej miały dodatkowy tekst ‘photo, Canon50, 85mm, F5.6, award-winning photo’.
Autorzy identyfikują dwa tryby awaryjne dla modeli dyfuzji w tym zakresie: że wyniki podpowiedzi użytkownika ze słowami o niejednoznacznym znaczeniu często wykazują skojarzone słowo wraz z pewną manifestacją pojęcia; i przeciek pojęć, gdzie właściwości jednego obiektu ‘przeciekają’ do innego renderowanego obiektu.
‘Rozpatrywane łącznie, zjawiska, które badamy, dostarczają dowodów na ograniczenia w umiejętnościach językowych DALLE-2 i otwierają drogi do przyszłych badań, które ujawnią, czy te ograniczenia wynikają z problemów z kodowaniem tekstu, modelem generatywnym, czy oboma. Ogólnie, proponowane podejście może być rozszerzone na inne sytuacje, w których proces dekodowania jest używany do ujawnienia indukcyjnych założeń modelu i słabości modeli przekształcających tekst w obraz.’
Używając 17 słów, które spowodują, że DALL-E 2 podzieli dane wejściowe na wiele wyników, autorzy zaobserwowali, że duplikacja homonimów wystąpiła w ponad 80% z 216 wyrenderowanych obrazów.
Badacze użyli par bodziec–kontrola, aby zbadać, w jakim stopniu konieczne jest używanie specyficznych i najprawdopodobniej przesadnie określonych słów, aby zapobiec tym duplikacjom. Dla testów encji-do-właściwości, stworzono 10 takich par, a autorzy zauważają, że podpowiedzi wywołują wspólną właściwość w 92,5% przypadków, podczas gdy kontrolna podpowiedź wywołuje ją tylko w 6,6% przypadków.
‘[Aby] zademonstrować, rozważmy zebrę i ulicę, tutaj zebra jest encją, ale modyfikuje ulicę, a DALLE-2 nieustannie generuje przejścia dla pieszych, możliwe, że ze względu na podobieństwo pasów zebry do przejścia dla pieszych. I zgodnie z naszym przypuszczeniem, kontrola zebra i ulica żwirowa określa typ ulicy, który zwykle nie ma przejść dla pieszych, i rzeczywiście, wszystkie nasze próbki kontrolne dla tej podpowiedzi nie zawierają przejścia dla pieszych.’





