Modele i platformy AI
Osadzanie kodu: Kompletny przewodnik

 Dodaj Unite.AI do preferowanych źródeł w Google

Osadzanie kodu to przełomowy sposób reprezentowania fragmentów kodu jako gęstych wektorów w przestrzeni ciągłej. Te osadzania przechwytują relacje semantyczne i funkcyjne między fragmentami kodu, umożliwiając potężne aplikacje w programowaniu wspomaganym przez sztuczną inteligencję. Podobnie jak osadzania słów w przetwarzaniu języka naturalnego (NLP), osadzania kodu umieszczają podobne fragmenty kodu blisko siebie w przestrzeni wektorowej, pozwalając maszynom na lepsze zrozumienie i manipulowanie kodem.
Czym są osadzania kodu?
Osadzania kodu konwertują złożone struktury kodu w numeryczne wektory, które przechwytują znaczenie i funkcjonalność kodu. W przeciwieństwie do tradycyjnych metod, które traktują kod jako sekwencje znaków, osadzania przechwytują relacje semantyczne między częściami kodu. Jest to kluczowe dla różnych zadań inżynierii oprogramowania napędzanych przez sztuczną inteligencję, takich jak wyszukiwanie kodu, uzupełnianie kodu, wykrywanie błędów i wiele więcej.
Na przykład, rozważmy dwie funkcje Python:
def add_numbers(a, b):
return a + b
<p>def sum_two_values(x, y):
result = x + y
return result</p>
Chociaż te funkcje wyglądają inaczej składniowo, wykonują one tę samą operację. Dobre osadzanie kodu powinno reprezentować te dwie funkcje za pomocą podobnych wektorów, przechwytując ich podobieństwo funkcyjne pomimo ich różnic tekstowych.

Wektorowe osadzanie
Jak są tworzone osadzania kodu?
Istnieją różne techniki tworzenia osadzań kodu. Jednym z powszechnych podejść jest użycie sieci neuronowych do nauki tych reprezentacji z dużego zbioru danych kodu. Sieć analizuje strukturę kodu, w tym tokeny (słowa kluczowe, identyfikatory), składnię (jak kod jest strukturyzowany) i potencjalnie komentarze, aby nauczyć się relacji między różnymi fragmentami kodu.
Rozważmy proces:
- Kod jako sekwencja: Najpierw fragmenty kodu są traktowane jako sekwencje tokenów (zmiennych, słów kluczowych, operatorów).
- Szkolenie sieci neuronowej: Sieć neuronowa przetwarza te sekwencje i uczy się mapować je na reprezentacje wektorowe o stałym rozmiarze. Sieć uwzględnia czynniki takie jak składnia, semantyka i relacje między elementami kodu.
- Przechwytywanie podobieństw: Celem szkolenia jest umieszczenie podobnych fragmentów kodu (o podobnej funkcjonalności) blisko siebie w przestrzeni wektorowej. Pozwala to na zadania takie jak wyszukiwanie podobnego kodu lub porównywanie funkcjonalności.
Oto uproszczony przykład w języku Python, jak można przetworzyć kod w celu osadzania:
import ast

<p>def tokenize_code(code_string):
tree = ast.parse(code_string)
tokens = []
for node in ast.walk(tree):
if isinstance(node, ast.Name):
tokens.append(node.id)
elif isinstance(node, ast.Str):
tokens.append('STRING')
elif isinstance(node, ast.Num):
tokens.append('NUMBER')
# Dodaj więcej typów węzłów w razie potrzeby
return tokens</p>

<p># Przykład użycia
code = """
def greet(name):
print("Hello, " + name + "!")
"""

<p>tokens = tokenize_code(code)
print(tokens)
# Wyjście: ['def', 'greet', 'name', 'print', 'STRING', 'name', 'STRING']</p>
Ta reprezentacja tokenizowana może być następnie podana do sieci neuronowej w celu osadzania.
Istniejące podejścia do osadzania kodu
Istniejące metody osadzania kodu można sklasyfikować w trzech głównych kategoriach:
Metody oparte na tokenach
Metody oparte na tokenach traktują kod jako sekwencję leksykalnych tokenów. Techniki takie jak Term Frequency-Inverse Document Frequency (TF-IDF) i modele głębokiego uczenia, takie jak CodeBERT, należą do tej kategorii.
Metody oparte na drzewach
Metody oparte na drzewach parsują kod w abstrakcyjne drzewa składniowe (AST) lub inne struktury drzewiaste, przechwytując składnię i semantykę kodu. Przykładami są drzewiaste sieci neuronowe i modele takie jak code2vec i ASTNN.
Metody oparte na grafach
Metody oparte na grafach konstruują grafy z kodu, takie jak grafy przepływu sterowania (CFG) i grafy przepływu danych (DFG), aby reprezentować dynamiczne zachowanie i zależności kodu. GraphCodeBERT jest godnym uwagi przykładem.
TransformCode: Ramy dla osadzania kodu
TransformCode: Nienadzorowane uczenie osadzania kodu
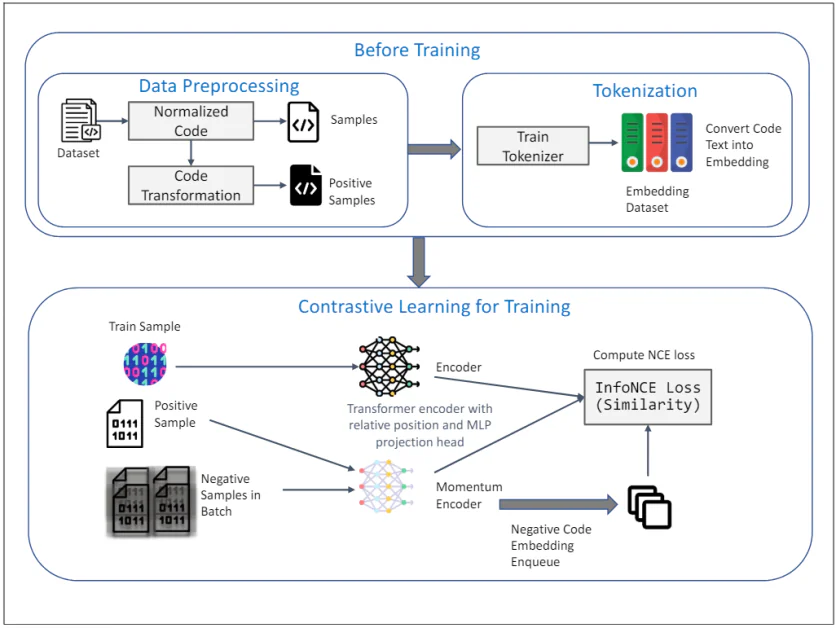
TransformCode to ramy, które adresują ograniczenia istniejących metod, ucząc osadzań kodu w sposób kontrastywny. Jest to niezależne od kodera i języka, co oznacza, że może wykorzystywać dowolny model kodera i obsługiwać dowolny język programowania.
Diagram powyżej ilustruje ramy TransformCode dla nienadzorowanego uczenia osadzania kodu za pomocą kontrastywnego uczenia. Składa się z dwóch głównych faz: Przed szkoleniem i Kontrastywne uczenie podczas szkolenia. Oto szczegółowe wyjaśnienie każdego komponentu:
Przed szkoleniem
1. Przetwarzanie danych:
- Zbiór danych: Początkowy wejściowy zbiór danych zawiera fragmenty kodu.
- Normalizowany kod: Fragmenty kodu przechodzą normalizację w celu usunięcia komentarzy i przemianowania zmiennych na standardową formę. Pomaga to w zmniejszeniu wpływu nazw zmiennych na proces uczenia i poprawia ogólną jakość modelu.
- Transformacja kodu: Znormalizowany kod jest następnie transformowany za pomocą różnych transformacji składniowych i semantycznych w celu wygenerowania próbek pozytywnych. Te transformacje zapewniają, że semantyczne znaczenie kodu pozostaje niezmienne, zapewniając różnorodne i wytrzymałe próbki do kontrastywnego uczenia.
2. Tokenizacja:
- Szkolenie tokenizera: Tokenizer jest szkolony na zbiorze danych kodu w celu konwersji tekstu kodu na osadzania. Obejmuje to rozbicie kodu na mniejsze jednostki, takie jak tokeny, które mogą być przetwarzane przez model.
- Zbiór osadzań: Wytrenowany tokenizer jest używany do konwersji całego zbioru danych kodu na osadzania, które służą jako wejście dla fazy kontrastywnego uczenia.
Kontrastywne uczenie podczas szkolenia
3. Proces szkolenia:
- Próbka szkoleniowa: Próbka z zestawu szkoleniowego jest wybrana jako reprezentacja kodu zapytania.
- Próbka pozytywna: Próbka pozytywna to transformowana wersja próbki zapytania, uzyskana podczas fazy przetwarzania danych.
- Próbki negatywne w partii: Próbki negatywne to wszystkie inne próbki kodu w bieżącej partii, które są różne od próbki pozytywnej.
4. Koder i koder z pamięcią:
- Koder Transformer z względną pozycją i głowicą projekcyjną MLP: Zarówno próbka zapytania, jak i pozytywna są wprowadzane do kodera Transformer. Koder uwzględnia względną pozycję, aby przechwycić strukturę składniową i relacje między tokenami w kodzie. Głowica projekcyjna MLP jest używana do mapowania reprezentacji zakodowanych na niższy wymiar, w którym stosuje się cel kontrastywny.
- Koder z pamięcią: Używany jest również koder z pamięcią, który jest aktualizowany przez średnią ruchomą parametrów kodera zapytania. Pomaga to w utrzymaniu spójności i różnorodności reprezentacji, zapobiegając kolapsowi straty kontrastywnej. Próbki negatywne są kodowane za pomocą tego kodera z pamięcią i umieszczane w kolejce do kontrastywnego uczenia.
5. Cel kontrastywny:
- Obliczanie straty InfoNCE (podobieństwa): Strata InfoNCE (Noise Contrastive Estimation) jest obliczana w celu maksymalizacji podobieństwa między próbką zapytania a pozytywną, a jednocześnie minimalizacji podobieństwa między próbką zapytania a negatywną. Ten cel gwarantuje, że nauczone osadzania są dyskryminacyjne i wytrzymałe, przechwytując semantyczne podobieństwo fragmentów kodu.
Całe ramy wykorzystują siłę kontrastywnego uczenia, aby nauczyć się znaczących i wytrzymałych osadzań kodu z nieoznakowanych danych. Użycie transformacji AST i kodera z pamięcią jeszcze bardziej poprawia jakość i wydajność nauczonych reprezentacji, czyniąc TransformCode potężnym narzędziem dla różnych zadań inżynierii oprogramowania.
Kluczowe cechy TransformCode
- Elastyczność i adaptacyjność: Może być rozszerzony o różne zadania dolnego poziomu wymagające reprezentacji kodu.
- Wydajność i skalowalność: Nie wymaga dużego modelu ani obszernych danych szkoleniowych, obsługuje dowolny język programowania.
- Nienadzorowane i nadzorowane uczenie: Może być stosowane w obu scenariuszach uczenia, włączając etykiety lub cele zadań.
- Dostosowywane parametry: Liczba parametrów kodera może być dostosowana w zależności od dostępnych zasobów obliczeniowych.
TransformCode wprowadza technikę augmentacji danych o nazwie transformacja AST, stosując transformacje składniowe i semantyczne do oryginalnych fragmentów kodu. Generuje to różnorodne i wytrzymałe próbki do kontrastywnego uczenia.
Zastosowania osadzań kodu
Osadzania kodu rewolucjonizowały różne aspekty inżynierii oprogramowania, przekształcając kod z formatu tekstowego na reprezentację numeryczną, którą mogą wykorzystywać modele uczenia maszynowego. Oto kilka kluczowych zastosowań:
Poprawione wyszukiwanie kodu
Tradycyjnie, wyszukiwanie kodu opierało się na dopasowaniu słów kluczowych, co często prowadziło do nieistotnych wyników. Osadzania kodu umożliwiają wyszukiwanie semantyczne, w którym fragmenty kodu są klasyfikowane na podstawie ich podobieństwa w funkcjonalności, nawet jeśli używają różnych słów kluczowych. To znacznie poprawia dokładność i wydajność wyszukiwania istotnego kodu w dużych bazach kodu.
Bardziej inteligentne uzupełnianie kodu
Narzędzia do uzupełniania kodu sugerują istotne fragmenty kodu na podstawie bieżącego kontekstu. Wykorzystując osadzania kodu, te narzędzia mogą zapewnić bardziej dokładne i przydatne sugestie, rozumiejąc semantyczne znaczenie kodu, który jest pisany. To przekłada się na szybsze i bardziej produktywne doświadczenia programistyczne.
Automatyczna korekta kodu i wykrywanie błędów
Osadzania kodu mogą być używane do identyfikacji wzorców, które często wskazują na błędy lub nieefektywności w kodzie. Analizując podobieństwo między fragmentami kodu a znanymi wzorcami błędów, te systemy mogą automatycznie sugerować poprawki lub wskazywać obszary, które mogą wymagać dalszego sprawdzenia.
Poprawiona sumaaryzacja kodu i generowanie dokumentacji
Duże bazy kodu często mają braki w dokumentacji, co utrudnia nowym programistom zrozumienie ich działania. Osadzania kodu mogą tworzyć zwarte podsumowania, które przechwytują istotę funkcjonalności kodu. To nie tylko poprawia utrzymanie kodu, ale także ułatwia transfer wiedzy w zespołach programistycznych.
Poprawione przeglądy kodu
Przeglądy kodu są kluczowe dla utrzymania jakości kodu. Osadzania kodu mogą pomagać recenzentom, wskazując potencjalne problemy i sugerując ulepszenia. Mogą one również ułatwiać porównania między różnymi wersjami kodu, czyniąc proces przeglądu bardziej wydajnym.
Przetwarzanie kodu w różnych językach
Świat rozwoju oprogramowania nie jest ograniczony do jednego języka programowania. Osadzania kodu mają potencjał ułatwienia zadań przetwarzania kodu w różnych językach. Przechwytując relacje semantyczne między kodem napisanym w różnych językach, te techniki mogą umożliwić zadania takie jak wyszukiwanie kodu i analiza w różnych językach programowania.