
Najlepsze
10 najlepszych narzędzi AI do scrapowania stron internetowych (listopad 2026)

 Dodaj Unite.AI do preferowanych źródeł w Google
Unite.AI może otrzymać wynagrodzenie za użycie linków do recenzowanych produktów. Nie wpływa to na nasze oceny redakcyjne. Przeczytaj informację o afiliacji.
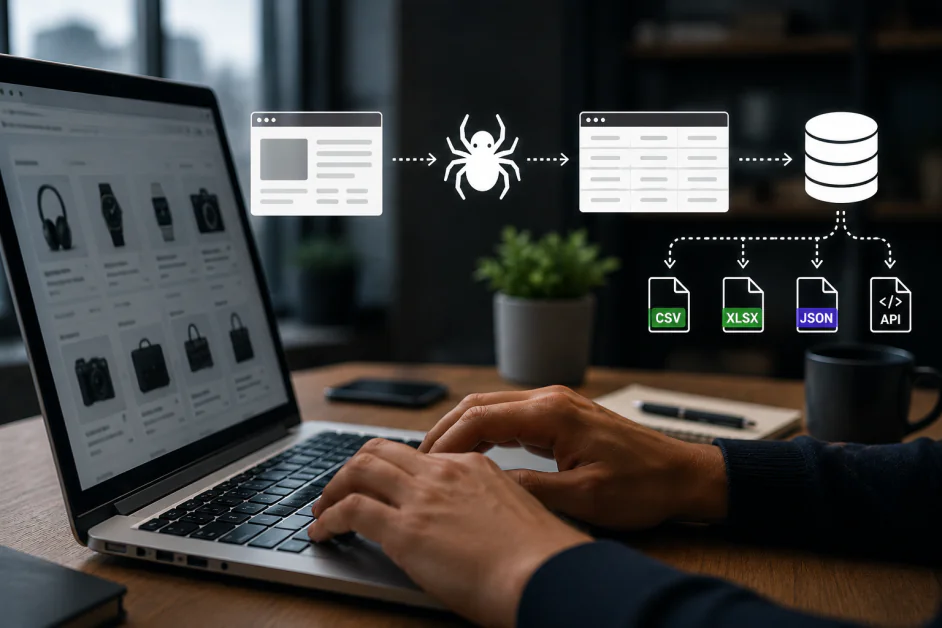
Wybór najlepszego narzędzia AI do scrapowania stron internetowych zależy od tego, co chcesz zrobić po załadowaniu strony. Asystent badawczy potrzebuje czytelnych treści i linków do źródeł. System analizy rynku potrzebuje spójnych danych gromadzonych na dużą skalę. Interaktywny agent może potrzebować przeglądarki, która potrafi przejść przez kilka kolejnych kroków i utrzymać aktywną sesję.
W tym przewodniku omawiamy dziesięć narzędzi do tych zadań, w tym platformy do gromadzenia danych dla przedsiębiorstw, interfejsy API treści, narzędzia do scrapowania niewymagające kodowania, usługi dostarczające dane z wyszukiwarek oraz zarządzane przeglądarki. Oceniamy, w jaki sposób każdy produkt gromadzi informacje, kto może utrzymywać dany proces oraz jakie kompromisy mają znaczenie, gdy prototyp staje się regularnie realizowanym procesem.
Nasz zespół niezależnie ocenił każde rozwiązanie omawiane w tym przewodniku, analizując jego możliwości, praktyczne zalety, ograniczenia oraz przydatność w zastosowaniach uwzględnionych w rankingu.
Porównanie najlepszych narzędzi AI do scrapowania stron internetowych
| Narzędzie AI | Najlepsze zastosowanie | Najważniejsze zalety |
|---|---|---|
| Bright Data | Gromadzenie danych dla przedsiębiorstw i zróżnicowane procesy przetwarzania danych | Scraper APIs, Browser API, Scraper Studio, zbiory danych, serwery proxy |
| Firecrawl | Treści internetowe dla aplikacji AI | Wyszukiwanie, scrapowanie, mapowanie, indeksowanie, Markdown, JSON, interakcja, MCP |
| Apify | Wielokrotnego użytku zadania scrapowania i orkiestracja w chmurze | Actors, Crawlee, harmonogramy, pamięć masowa, serwery proxy, interfejsy API, MCP |
| Browse AI | Gromadzenie danych bez kodowania i monitorowanie zmian | Konfiguracja wspomagana przez AI, roboty, alerty, harmonogramy, integracje |
| SearchAPI | Ustrukturyzowane wyniki wyszukiwania i badania uwzględniające lokalizację | Google, Mapy, zakupy, wideo, powierzchnie wyszukiwania AI, JSON |
| Octoparse | Wizualne scrapowanie z możliwością powtarzalnego uruchamiania w chmurze | Szablony, asystent AI, automatyczne wykrywanie, uruchomienia w chmurze, eksport |
| Browserless | Zarządzane przeglądarki dla Puppeteer i Playwright | Przeglądarki hostowane, trwałe sesje, interfejsy REST API, MCP |
| ScrapingBee | Zarządzana ekstrakcja danych za pośrednictwem interfejsu API aplikacji | Ekstrakcja AI, CSS/XPath, Markdown, scenariusze JS, MCP |
| Oxylabs | Zarządzane pobieranie danych z wymagających publicznych stron internetowych | Web API /Scrape, renderowanie, ustrukturyzowane dane wyjściowe, MCP |
| Diffbot | Automatyczna ekstrakcja danych i analiza informacji o podmiotach | Ekstrakcja, standardowe schematy, indeksowanie, graf wiedzy |
Jak wybrać narzędzie AI do scrapowania stron internetowych
Dopasuj narzędzie do zadania
W przypadku bazy wiedzy AI priorytetem powinny być czytelny tekst, ustrukturyzowane dane wyjściowe i zachowane adresy URL źródeł. Przy regularnie prowadzonych badaniach biznesowych wizualny robot i alerty o zmianach mogą być ważniejsze niż interfejs programistyczny. W przypadku interaktywnego agenta zwróć uwagę na ciągłość sesji i możliwość sterowania przeglądarką. Interfejsy API wyników wyszukiwania służą do czegoś innego: dostarczają dane z wyszukiwarki, natomiast gromadzenie informacji z podlinkowanych stron to osobny etap.
Określ, kto odpowiada za proces
Platforma niewymagająca kodowania pozwala analitykowi bezpośrednio modyfikować poszczególne etapy ekstrakcji danych. Interfejs API zapewnia programistom przejrzysty sposób integracji gromadzenia danych z aplikacją. Platforma zadań działająca w chmurze oferuje planowanie i przechowywanie danych, natomiast w przypadku zarządzanej przeglądarki większa część logiki automatyzacji pozostaje po stronie zespołu. Wybierz rozwiązanie, które powierza utrzymanie procesu osobom znającym zarówno źródłowe strony internetowe, jak i wymagany format danych wyjściowych.
Planuj budżet z myślą o użytecznych danych, a nie imponującej liczbie żądań
Porównaj koszt ukończonego zadania z zestawem potrzebnych pól. Renderowanie, serwery proxy premium, czas działania przeglądarki, ekstrakcja AI, przechowywanie danych i ponawiane próby mogą wpłynąć na łączny koszt. Darmowy kredyt, jednostka przeglądarki i żądanie wyszukiwania to różne miary. W przypadku regularnie wykonywanych zadań, oprócz liczby udanych odpowiedzi, śledź kompletność danych, duplikaty, aktualność oraz koszt przypadający na użyteczny rekord.
10 najlepszych narzędzi AI do scrapowania stron internetowych
1. Bright Data
Bright Data to nasza ogólna rekomendacja dla organizacji, które potrzebują różnych sposobów pozyskiwania danych z internetu w ramach jednej platformy. Oferta obejmuje gotowe Scraper APIs, wstępnie zgromadzone zbiory danych, Scraper Studio, Web Unlocker oraz usługi proxy. Zespół zajmujący się analizą rynku e-commerce może na przykład korzystać z ustrukturyzowanych źródeł danych dotyczących popularnych sieci handlowych, a jednocześnie tworzyć własne rozwiązania do gromadzenia danych z wyspecjalizowanej platformy handlowej. Tak szeroka oferta sprawia, że narzędzie jest szczególnie przydatne, gdy program pozyskiwania danych obejmuje więcej niż jedną stronę internetową lub jeden dział.
W przypadku stron interaktywnych Browser API udostępnia przeglądarki, którymi programiści mogą sterować za pomocą Puppeteer, Playwright lub Selenium. Łączy obsługę przeglądarki z zarządzaniem serwerami proxy i obsługą CAPTCHA, a wsparcie dla Chrome DevTools pomaga inżynierom analizować problematyczne sesje. Jest to przydatne, gdy przed uzyskaniem potrzebnych informacji proces wymaga nawigowania po stronie lub interakcji z nią, zamiast jedynie pobrania istniejącego zbioru danych.
Głównym kompromisem jest konieczność wyboru produktów i zarządzania kosztami. Ruch przeglądarkowy, wyniki scrapingu i zakup zbiorów danych to różne rodzaje obciążeń, dlatego jedna cena nagłówkowa nie oddaje kosztów całej platformy. Bright Data sprawdzi się w zespołach, w których ktoś odpowiada za jakość pozyskiwania danych, zakres obsługiwanych źródeł i wydatki. Projekt o wąsko określonym zakresie może szybciej trafić do środowiska produkcyjnego dzięki prostszemu API do ekstrakcji danych.
Zalety i wady
- Szeroki wybór sposobów pozyskiwania danych na jednej platformie
- Hostowane przeglądarki obsługują sprawdzone biblioteki do automatyzacji
- Gotowe API i zbiory danych skracają czas konfiguracji
- Różne produkty wymagają osobnego planowania kosztów
- Własne potoki nadal wymagają nadzoru ze strony zespołu inżynieryjnego
2. Firecrawl
Firecrawl polecamy programistom, którzy przekształcają treści internetowe w użyteczny kontekst dla aplikacji AI. Narzędzia do wyszukiwania, pobierania danych, mapowania i przeszukiwania witryn obsługują cały proces — od znalezienia strony po zebranie danych z witryny — a formaty Markdown i ustrukturyzowany JSON ograniczają konieczność porządkowania treści po ich pobraniu. Dzięki temu asystent badawczy lub produkt oparty na bazie wiedzy może poświęcić więcej czasu na odpowiadanie na pytania, a mniej na usuwanie menu nawigacyjnych z surowego kodu HTML.
Obecna oferta Interact rozszerza platformę o obsługę przeglądarki w czasie rzeczywistym. Agenci mogą opisywać działania w języku naturalnym lub wykonywać kod przeglądarkowy, zachowywać stan między wywołaniami i ponownie korzystać z uwierzytelnionych profili. To istotne rozszerzenie w przypadku stron, które przed pobraniem danych wymagają kliknięć, użycia filtrów lub zalogowania. Dostęp przez MCP i wiersz poleceń sprawia też, że Firecrawl dobrze sprawdza się w procesach tworzenia agentów, a nie tylko jako konwencjonalne API aplikacji.
Firecrawl najlepiej sprawdza się wtedy, gdy najpilniejszą potrzebą jest pozyskiwanie treści, a aplikacja ma już własne mechanizmy przechowywania i pobierania danych. Zespoły nadal muszą określić granice przeszukiwania witryn, zachować źródłowe adresy URL i odróżniać brak pola od pola pustego. Kod open source daje dodatkową możliwość wdrożenia, ale zespoły powinny sprawdzić konkretne funkcje i wymagania operacyjne wybranego wariantu, zamiast zakładać, że wersje hostowana i zarządzana samodzielnie są identyczne.
Zalety i wady
- Markdown i JSON dobrze sprawdzają się w potokach AI
- Interact obsługuje zadania przeglądarkowe zachowujące stan
- Dostęp przez API, MCP i CLI
- Pobrane treści nadal wymagają weryfikacji
- Wdrożenia zarządzane samodzielnie wymagają pracy operacyjnej
3. Apify
Apify to najlepszy wybór dla zespołów, które chcą korzystać z wielokrotnego użytku narzędzi do scrapingu i mieć platformę do ich obsługi. Za pośrednictwem marketplace’u można udostępniać Actors — gotowe programy, które przyjmują dane wejściowe, działają w chmurze i zwracają wyniki. Istniejące Actors mogą przyspieszyć typowe zadania związane z pozyskiwaniem danych, a własne Actors pozwalają programistom zachować opracowaną przez siebie logikę ekstrakcji. Dzięki temu Apify stanowi użyteczne ogniwo łączące eksperyment z powtarzalnym zadaniem produkcyjnym.
Platforma zapewnia też ważne funkcje operacyjne, w tym harmonogramowanie, przechowywanie wyników, dostęp do serwerów proxy, monitorowanie i integracje. Programiści mogą również tworzyć rozwiązania z użyciem Crawlee — otwartoźródłowej biblioteki do przeszukiwania stron i automatyzacji przeglądarek. Serwer MCP Apify udostępnia Actors agentom AI, dzięki czemu to samo gotowe narzędzie może obsługiwać aplikację, zaplanowany potok lub asystenta bez konieczności tworzenia osobnej implementacji scrapera dla każdego interfejsu.
Wybór Actor zasługuje na tyle samo uwagi co wybór platformy. Poszczególni wydawcy mogą oferować różne ceny, poziomy utrzymania, opcje danych wejściowych i jakość wyników. Pomyślne zakończenie zadania nie dowodzi też, że zebrano wszystkie oczekiwane rekordy. Apify jest szczególnie atrakcyjne, gdy ktoś odpowiada za schemat zadania, monitoruje zmiany oraz uwzględnia w budżecie koszty wybranego Actor i infrastruktury. Ręczne pobranie danych z jednej strony zazwyczaj nie wymaga tak rozbudowanej orkiestracji.
Zalety i wady
- Gotowe i własne Actors działają na tej samej platformie
- Harmonogramowanie, przechowywanie danych i monitorowanie ułatwiają powtarzalne wykonywanie zadań
- MCP umożliwia wykorzystanie Actors w procesach opartych na agentach
- Poziom utrzymania i jakość Actors są zróżnicowane
- Koszty użytkowania i opłaty za Actors wymagają uwzględnienia w budżecie
4. Browse AI
Browse AI polecamy użytkownikom biznesowym, którzy potrzebują regularnie pozyskiwać dane z witryn internetowych, ale nie chcą tworzyć w tym celu projektu programistycznego. Obecna konfiguracja pozwala odczytać wskazaną stronę, zaproponować strukturę danych, a następnie umożliwić użytkownikowi sprawdzenie lub dostosowanie pól. Trenowanie robotów nadal ma kluczowe znaczenie dla powtarzalnego pozyskiwania danych. To praktyczne rozwiązanie dla zespołów operacyjnych i marketingowych, które zbierają do znanych im tabel oferty produktów, wpisy z katalogów lub informacje o konkurencji.
Monitorowanie to jedna z największych zalet tego narzędzia. Roboty mogą sprawdzać strony według harmonogramu, wykrywać nowe lub zmienione elementy i wysyłać alerty z objaśnieniem wprowadzonych zmian. Przepływy pracy mogą łączyć zbieranie danych z wielu stron, a integracje z API, webhookami i arkuszami kalkulacyjnymi ułatwiają przekazywanie wyników do narzędzi, z których zespół już korzysta. Dzięki temu monitorowanie cen może stać się stałym procesem biznesowym, a nie serią ręcznych kontroli w przeglądarce.
Łatwość obsługi nie zwalnia z konieczności jasnego określenia struktury danych. Użytkownicy powinni zdecydować, które zmiany mają wywoływać alert, i sprawdzić, czy paginacja, etapy logowania oraz brak wyników działają prawidłowo. Poważne zmiany w witrynie nadal mogą wymagać interwencji. Browse AI sprawdza się najlepiej, gdy zespół biznesowy może kontrolować wyodrębnione wiersze i utrzymywać robota; programiści potrzebujący ściśle wersjonowanej logiki przeglądarki mogą wybrać usługę opartą na kodzie.
Zalety i wady
- Konfiguracja pól wspomagana przez AI obniża próg wejścia
- Monitorowanie według harmonogramu pozwala wychwycić istotne zmiany
- Integracje z arkuszami kalkulacyjnymi, API i webhookami
- Poważne zmiany w witrynie mogą wymagać ponownego trenowania
- Złożona logika wymaga starannego zaprojektowania przepływu pracy
5. SearchAPI
SearchAPI polecamy jako specjalistyczne narzędzie do pozyskiwania wyników wyszukiwania w postaci uporządkowanych danych. Jego API Google może zwracać linki do wyników i funkcje wyszukiwania w formacie JSON, dzięki czemu nie trzeba utrzymywać parsera dla zmieniającej się strony wyników. Szerszy katalog obejmuje takie źródła jak Maps, zakupy, wiadomości, wideo oraz obsługiwane wyszukiwarki AI. Narzędzie jest szczególnie przydatne, gdy dane o odkrywaniu treści i widoczności w wynikach wyszukiwania są celem samym w sobie, a nie jedynie etapem poprzedzającym indeksowanie innej witryny.
Lokalizacja jest ważnym elementem tego zastosowania. Parametry lokalizacji, kraju, języka i urządzenia pozwalają zespołom analizować rynek w określonym kontekście wyszukiwania. Aplikacja SEO może śledzić zapytanie w jednym mieście, a asystent badawczy — wyszukiwać przydatne źródła i zachowywać otrzymane linki do późniejszego wykorzystania. Dokumentacja dotycząca poszczególnych wyszukiwarek ma znaczenie, ponieważ dostępne parametry i pola wyników różnią się między produktami.
SearchAPI należy wybrać ze względu na wyszukiwarki i pola rzeczywiście potrzebne w danym przepływie pracy. Wynik wyszukiwania nie zawiera pełnej treści strony, do której prowadzi link, a rozbudowane formaty wyników nie mają jednakowego schematu. Zespoły powinny uwzględnić w budżecie liczbę żądań, potwierdzić wymagania dotyczące przepustowości i odpowiednio obsługiwać brakujące sekcje wyników. W przypadku pozyskiwania danych z dowolnych witryn lub interaktywnej sesji przeglądarki lepiej zacząć od innego narzędzia z tego przewodnika.
Zalety i wady
- Uporządkowane wyniki eliminują konieczność utrzymywania parsera SERP
- Szeroki katalog wyszukiwarek i powiązanych silników
- Szczegółowe ustawienia lokalizacji
- Wyniki wyszukiwania nie zastępują pozyskiwania danych ze stron docelowych
- Pola i parametry różnią się w zależności od wyszukiwarki
6. Octoparse
Octoparse prezentuje funkcję AI Copilot i automatyzację z udziałem człowieka. Wideo: Octoparse.
Octoparse sprawdzi się w przypadku analityków, którzy chcą wizualnie zaprojektować scraper, a następnie uruchamiać go wielokrotnie. Obecna platforma oferuje gotowe szablony, konfigurację za pomocą AI Assistant oraz automatyczne wykrywanie stron w aplikacji komputerowej. Użytkownicy mogą dopracować utworzone zadanie, zamiast zaczynać od kodu przeglądarki. Ta elastyczność przydaje się przy zbieraniu danych z katalogów produktów, katalogów kontaktów lub stron z ofertami, gdzie kolejność stron jest równie ważna jak znajdujące się na nich pola.
Wykonywanie zadań w chmurze zmienia przygotowane zadanie w cykliczny proces zbierania danych, który nie wymaga pozostawiania włączonego komputera osobistego. Harmonogramowanie, równoległe przetwarzanie, rotacja adresów IP i integracje eksportu pozwalają realizować większe zadania poza środowiskiem prototypowym na komputerze. Podejście wizualne jest szczególnie atrakcyjne dla zespołów, które znają swoje witryny źródłowe i wymagania dotyczące danych, ale nie chcą utrzymywać własnej usługi automatyzacji przeglądarki.
Octoparse wymaga jednak starannego projektowania zadań. Paginacja, nieskończone przewijanie, etapy wypełniania formularzy i zduplikowane rekordy mogą zmienić znaczenie pozornie udanego uruchomienia. Limity korzystania z chmury i funkcje dostępne w ramach planu powinny odpowiadać planowanemu harmonogramowi i skali. Polecamy to narzędzie zespołom, które chcą mieć większą kontrolę nad etapami pozyskiwania danych niż w przypadku szybkiego narzędzia działającego jednym kliknięciem, pod warunkiem że wyznaczą osobę odpowiedzialną za dostosowanie zadania do zmian na stronach źródłowych.
Zalety i wady
- Szablony i pomoc AI ułatwiają konfigurację
- Edycja wizualna pozwala tworzyć szczegółowe zadania pozyskiwania danych
- Uruchomienia w chmurze umożliwiają zbieranie danych według harmonogramu
- Złożone witryny wymagają dopracowania zadań
- Funkcje chmurowe zależą od wybranego planu
7. Browserless
Polecamy Browserless programistom, którzy chcą sterować przeglądarką, powierzając jej hosting i skalowanie zarządzanej usłudze. Istniejące skrypty Puppeteer lub Playwright mogą łączyć się ze zdalnymi przeglądarkami, dzięki czemu rozwiązanie to jest atrakcyjne dla projektów, w których działa już kod automatyzujący. Jest to szczególnie przydatne, gdy pobieranie danych wymaga kilku interakcji, odbywa się w interfejsie intensywnie wykorzystującym JavaScript albo wymaga sesji, która musi trwać dłużej niż jedno proste żądanie.
Usługa udostępnia również interfejsy API REST do pobierania danych, wykonywania zrzutów ekranu, tworzenia plików PDF i korzystania z niestandardowych funkcji przeglądarki. Hostowany serwer MCP udostępnia narzędzia przeglądarkowe agentom AI, a funkcje sesji i uwierzytelnione profile obsługują procesy wymagające ciągłości. Browserless sprawdzi się więc zarówno u programisty tworzącego własne narzędzie do gromadzenia danych, jak i u agenta, który musi przeglądać strony i zbierać informacje za pomocą prawdziwej przeglądarki.
Przy wyborze kluczowe jest to, w jaki sposób rozliczana jest praca przeglądarki. Bezpłatny plan obejmuje obecnie 1000 jednostek miesięcznie i dwie równocześnie działające przeglądarki, a nie 1000 gwarantowanych pobrań danych. Czas pracy przeglądarki zużywa jednostki, a ruch przez serwery proxy i skuteczne rozwiązanie CAPTCHA wiążą się z dodatkowymi opłatami; limity sesji zależą od planu. Zespoły nadal odpowiadają za logikę ekstrakcji i kontrolę wyników, dlatego Browserless jest najbardziej atrakcyjny, gdy ważniejsza jest kontrola nad przeglądarką niż wizualny kreator robotów.
Zalety i wady
- Pozwala korzystać ze znanych procesów pracy w Puppeteer i Playwright
- Interfejsy API REST umożliwiają pobieranie danych i eksportowanie stron
- Funkcje sesji i MCP sprawdzają się w przypadku agentów interaktywnych
- Czas pracy przeglądarki i dodatki wpływają na zużycie jednostek
- Niestandardowa ekstrakcja nadal wymaga logiki aplikacji
8. ScrapingBee
ScrapingBee to dobry wybór dla programistów, którzy wolą zlecić zarządzanej usłudze pobranie danych niż bezpośrednio sterować długo działającą przeglądarką. Jego interfejs API łączy pobieranie stron i renderowanie JavaScript z obsługą serwerów proxy, a ekstrakcję można przeprowadzać na podstawie reguł CSS lub XPath albo instrukcji AI. To połączenie przydaje się w projektach, które wymagają uporządkowanych danych z kilku witryn, ale nie chcą utrzymywać własnej floty przeglądarek.
Scenariusze JavaScript mogą klikać, przewijać stronę, wpisywać tekst lub czekać przed zebraniem danych. Wynik w formacie Markdown obsługuje procesy pracy z treściami AI, a zrzuty ekranu pozwalają przechwycić wyrenderowaną stronę. Obecna wersja produktu udostępnia również dedykowane interfejsy API dla wybranych serwisów, a także dostęp przez CLI i MCP. Programista może stosować jawne reguły ekstrakcji do pozyskiwania stabilnych pól oraz ekstrakcję opartą na języku naturalnym, gdy struktura strony lub pytanie są mniej przewidywalne.
W praktyce różnica między ScrapingBee a hostowaną platformą przeglądarkową polega na tym, że ScrapingBee skupia się na żądaniu i zwracanym wyniku, natomiast szerszym procesem zajmuje się aplikacja niestandardowa. Obsługa wielu stron, usuwanie duplikatów, harmonogramy odświeżania i walidacja rekordów nadal wymagają osobnego rozwiązania. Zużycie punktów zmienia się również w zależności od używanych funkcji, w tym renderowania i opcji serwerów proxy. Polecamy to narzędzie zespołom tworzącym aplikacje, które cenią prosty interfejs HTTP i chcą zarządzać przepływem danych we własnym kodzie.
Zalety i wady
- Reguły selektorów i ekstrakcja AI zapewniają elastyczność
- Renderowanie i scenariusze obsługują interaktywne strony
- Markdown, CLI i MCP wspierają procesy pracy z AI
- Zaawansowane opcje żądań zwiększają zużycie punktów
- Zadania obejmujące wiele stron nadal wymagają koordynacji
9. Oxylabs
Oxylabs to dobry wybór dla zespołów, które chcą uzyskać zarządzany dostęp do trudno dostępnych publicznych witryn i zwiększać skalę gromadzenia danych. Obecny Web API obejmuje usługę /Scrape do pobierania i porządkowania danych internetowych, a renderowanie JavaScript i obsługa dostępu są wbudowane w usługę. Oferta obejmuje również /Search i infrastrukturę przeglądarkową, dzięki czemu zespoły mogą wybrać podejście odpowiednie do tego, czy zadanie zaczyna się od wyszukiwania, ekstrakcji, czy interakcji.
Opcje dostosowane do konkretnych witryn pozwalają pobierać przydatne pola z popularnych źródeł wyszukiwania i handlu elektronicznego, a połączenia z agentami za pośrednictwem MCP i Agent Skills włączają gromadzenie danych do procesów pracy z AI. Oxylabs nadal osobno dokumentuje również interfejs Classic Web Scraper API. To rozróżnienie ma znaczenie w przypadku istniejących integracji: zespół utrzymujący Classic API powinien korzystać z odpowiedniej dokumentacji, zamiast zakładać, że przykład dotyczący nowszego Web API można zastosować zamiennie.
Oxylabs sprawdza się najlepiej, gdy trudność dostępu do witryny, wymagana przepustowość lub koszt utrzymania infrastruktury dostępowej uzasadniają wybór zarządzanej platformy. Aplikacja nadal musi określać wymagany schemat danych, okres aktualności oraz sposób obsługi niekompletnych rekordów. Przed wdrożeniem należy dopasować wybraną generację API, opcje dotyczące witryn docelowych i model rozliczeń do konkretnego zadania. Do niewielkiej, ręcznej ekstrakcji lepiej może pasować wizualny scraper.
Zalety i wady
- Zarządzana infrastruktura do renderowania i dostępu
- Opcje ekstrakcji danych strukturalnych dostosowane do konkretnego celu
- Aktualne Web API obsługuje integracje z agentami
- Klasyczne i aktualne interfejsy API wymagają osobnej konfiguracji
- Jakość wyników nadal wymaga weryfikacji w aplikacji
10. Diffbot
Polecamy Diffbot, gdy zrozumienie informacji na stronie jest ważniejsze niż odtworzenie jej układu. Extract wykorzystuje widzenie komputerowe i przetwarzanie języka naturalnego do klasyfikowania stron oraz tworzenia ustrukturyzowanych danych JSON zgodnych ze standardowymi schematami. Zespołom zbierającym artykuły lub informacje o produktach z wielu źródeł może to ograniczyć ilość kodu do parsowania specyficznego dla poszczególnych witryn, potrzebnego do przekształcania stron w porównywalne rekordy.
Knowledge Graph odpowiada na pokrewną, ale odrębną potrzebę: pracę z encjami, takimi jak organizacje, osoby i artykuły, zebranymi wcześniej z publicznie dostępnych zasobów internetowych. Rekordy mogą łączyć informacje z wielu źródeł i wiązać encje za pomocą znaczących relacji. Dzięki temu Diffbot przydaje się do wzbogacania danych, analiz firm i zastosowań analitycznych, które wymagają kontekstu wykraczającego poza pola widoczne na jednej stronie.
Kompromisem jest konieczność dopasowania do modelu danych Diffbot. Standaryzowana ekstrakcja jest przydatna, gdy typy stron i pola odpowiadają danemu zadaniu, ale nietypowe pole lub specjalistyczna interakcja mogą wymagać innego podejścia. Zespoły powinny odróżniać ekstrakcję danych z wybranych adresów URL od przeszukiwania istniejącego grafu wiedzy, a następnie odpowiednio ocenić zakres pokrycia i aktualność źródeł. Diffbot lepiej sprawdzi się w zespołach technicznych tworzących znormalizowane produkty informacyjne niż u osób, które chcą jedynie skopiować kilka wierszy do arkusza kalkulacyjnego.
Zalety i wady
- Automatyczna klasyfikacja ogranicza nakład pracy związany z tworzeniem parserów
- Standardowe schematy ułatwiają normalizację podobnych stron
- Knowledge Graph zapewnia kontekst dotyczący encji
- Standardowe pola mogą nie spełniać specjalistycznych wymagań
- Ekstrakcja danych i dostęp do grafu służą różnym procesom pracy
Często zadawane pytania
Co sprawia, że narzędzie do scrapowania stron internetowych wykorzystuje AI?
AI może pomagać w identyfikowaniu pól, interpretowaniu treści stron, tworzeniu kroków ekstrakcji lub sterowaniu działaniami przeglądarki. Niektóre narzędzia wykorzystują AI podczas konfiguracji, a inne przy każdej ekstrakcji. Usługa może też wspierać aplikacje AI, dostarczając czyste treści bez używania modelu językowego przy każdym żądaniu. Wybierz funkcje, które rozwiązują problem związany ze zbieraniem danych, zamiast kierować się samą etykietą.
Czym różni się scrapowanie od automatyzacji przeglądarki?
Scrapowanie polega na zbieraniu informacji. Automatyzacja przeglądarki wykonuje działania na stronie, takie jak otwieranie menu, wpisywanie zapytania lub przechodzenie przez wieloetapowy proces. Obie metody często się uzupełniają: zautomatyzowana przeglądarka przechodzi do odpowiedniego stanu strony, a następnie etap ekstrakcji pobiera wymagane pola. Bezpośrednie żądanie API jest zwykle prostszym rozwiązaniem, jeśli takie interakcje nie są potrzebne.
Które narzędzia sprawdzą się najlepiej w zespole bez wiedzy technicznej?
Naszą pierwszą rekomendacją do prostego, cyklicznego zbierania danych i monitorowania zmian jest Browse AI. Dobrą alternatywą jest Octoparse, jeśli zespół chce mieć większą kontrolę wizualną nad poszczególnymi etapami zadania. Oba narzędzia sprawdzają się najlepiej, gdy ktoś weryfikuje uzyskane rekordy i potrafi rozpoznać zmiany w witrynie źródłowej.
Jakie dane z procesu scrapowania należy zachować w potoku AI lub RAG?
Zachowaj źródłowy adres URL, czas pobrania, tytuł strony oraz tekst lub ustrukturyzowane pola potrzebne aplikacji. Markdown może zachować czytelną strukturę dokumentu, a JSON nadaje się do zapisu określonych typów rekordów. Usuń zduplikowane treści i nie mieszaj tekstu nawigacyjnego z główną zawartością. Zachowanie informacji o pochodzeniu ułatwia późniejsze śledzenie i odświeżanie odpowiedzi.
Kiedy warto korzystać z zarządzanej przeglądarki?
Zarządzana przeglądarka przydaje się, gdy zbieranie danych wymaga uruchamiania JavaScriptu, wykonywania kilku interakcji lub zachowania ciągłości sesji, a zespół chce uniknąć samodzielnego hostowania procesów przeglądarki. Browserless to wyspecjalizowane rozwiązanie dla istniejącego kodu Puppeteer lub Playwright. W przypadku pojedynczej statycznej strony prostsze pobranie danych lub API do ekstrakcji może zużywać mniej zasobów.
Czy 1000 darmowych jednostek oznacza tyle samo co 1000 operacji scrapowania?
Nie. Każdy dostawca stosuje własne zasady naliczania jednostek i kredytów. Browserless rozlicza połączenia z przeglądarką w przedziałach do 30 sekund, a ruch przez serwer proxy i rozwiązywanie CAPTCHA powodują dodatkowe zużycie jednostek. Inne usługi naliczają opłaty zależnie od opcji żądania, liczby rekordów lub wykorzystanych zasobów obliczeniowych. Oszacuj koszt całego procesu zamiast utożsamiać różne limity bezpłatnych planów.
Czy można ufać wynikowi ekstrakcji AI bez weryfikacji?
Poprawna odpowiedź w formacie JSON może nadal pomijać rekord lub błędnie interpretować pole. Określ wymagane pola, sprawdzaj typy i zakresy, weryfikuj przykładowe strony źródłowe i monitoruj zmiany liczby rekordów. W przypadku zadań cyklicznych wyraźne stany błędu i pustego wyniku są bardziej przydatne niż uznawanie każdej odpowiedzi za kompletny zbiór danych.
Podsumowanie: narzędzia AI do scrapowania stron internetowych
Bright Data to nasz najlepszy wybór do realizacji szeroko zakrojonych projektów związanych z danymi internetowymi, a Firecrawl to najlepszy punkt wyjścia, jeśli chcesz przekształcać strony internetowe w treści gotowe do wykorzystania przez AI. Wybierz Apify, jeśli kluczowe znaczenie dla projektu mają narzędzia wielokrotnego użytku, zaplanowane zadania i operacje w chmurze.
Zespołom biznesowym Browse AI ułatwia regularne monitorowanie, a Octoparse zapewnia wizualne narzędzia do dopracowywania bardziej złożonych zadań związanych z ekstrakcją danych. SearchAPI to specjalistyczny wybór, gdy wymaganym wynikiem są ustrukturyzowane dane z wyszukiwania.
Browserless to dobry wybór dla deweloperów, którzy chcą korzystać z zarządzanego środowiska do obsługi przeglądarek i znanych bibliotek automatyzacji. ScrapingBee to solidna alternatywa, gdy zarządzane żądanie ekstrakcji danych lepiej pasuje do aplikacji. Oxylabs sprawdzi się przy wymagającym pobieraniu danych z publicznie dostępnych stron internetowych, a Diffbot wyróżnia się standaryzowaną ekstrakcją danych i analizą encji.
Najlepszym wyborem na dłuższą metę jest rozwiązanie, które dostarcza potrzebnych informacji w ramach procesu, który zespół potrafi utrzymywać. Dopasuj metodę gromadzenia danych do zadania, zachowaj kontekst źródłowy i oceniaj wartość na podstawie użytecznych wyników, a nie liczby stron objętych żądaniem.




