Kąt Andersona
Matowanie obrazu AI rozumiejące sceny

 Dodaj Unite.AI do preferowanych źródeł w Google
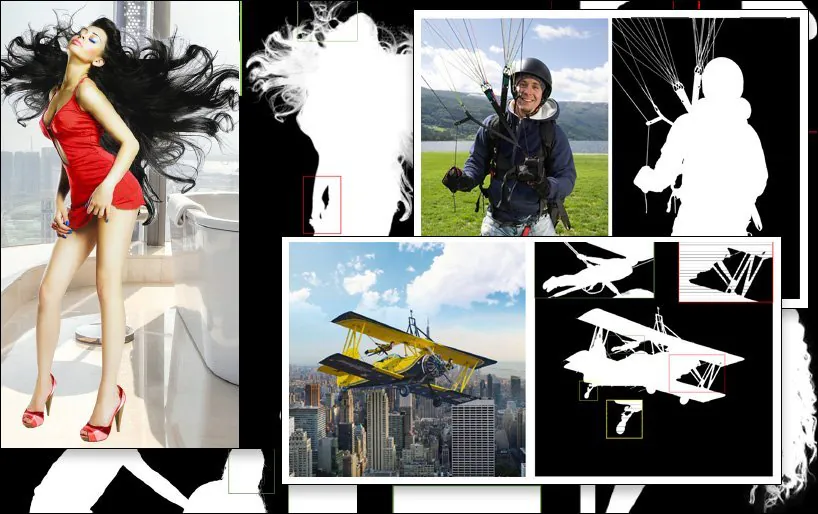
W dodatkowym filmie dokumentalnym towarzyszącym wydaniu DVD z 2003 roku filmu Alien3 (1992), legenda efektów wizualnych Richard Edlund wspominał z przerażeniem „sztukę sumo” fotochemicznego wyodrębniania mat, które dominowało w pracy nad efektami wizualnymi od późnych lat 30. do późnych lat 80. Edlund opisał niepewną naturę tego procesu jako „sztukę sumo”, w porównaniu do cyfrowych technik niebiesko/zielono‑ekranowych, które przejęły wczesne lata 90. (i od tego czasu wrócił do tej metafory).
Wyodrębnienie elementu pierwszoplanowego (takiego jak osoba lub model statku kosmicznego) z tła, aby wycięty obraz mógł zostać skomponowany na płaszczyźnie tła, pierwotnie realizowano poprzez nagranie obiektu pierwszoplanowego przed jednolitym niebieskim lub zielonym tłem.
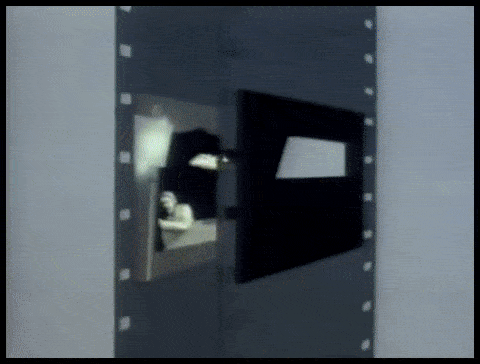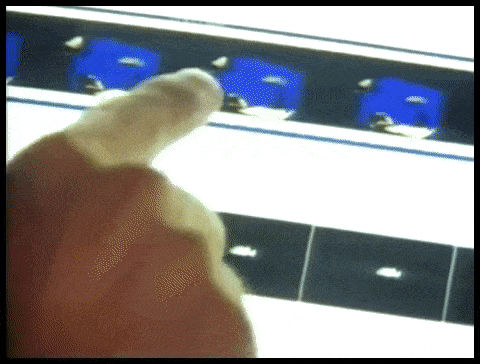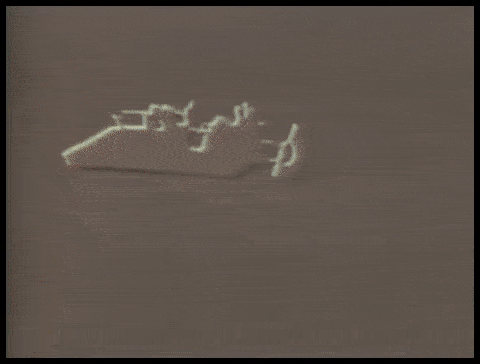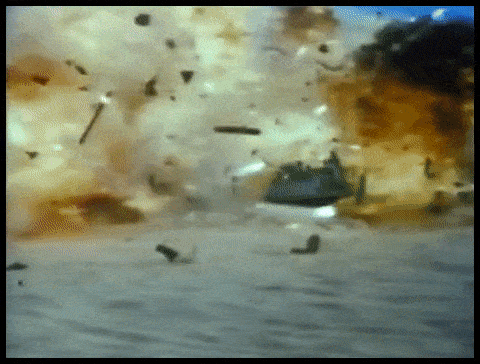
Żmudne procesy fotochemicznego wyodrębniania w ujęciu VFX wykonanym przez ILM dla ‘Powrotu Jedi’ (1983).
W uzyskanym materiale wideo kolor tła był następnie izolowany chemicznie i używany jako szablon do ponownego wydrukowania obiektu pierwszoplanowego (lub osoby) w optycznym drukarce jako „unoszący się” obiekt w przeciwnie przezroczystej warstwie filmu.
Proces ten znany był jako color separation overlay (CSO) – choć termin ten ostatecznie stał się bardziej kojarzony z prymitywnymi efektami wideo ‘Chromakey’ w niskobudżetowej telewizji lat 70. i 80., które realizowano przy użyciu metod analogowych, a nie chemicznych czy cyfrowych.

Demonstracja Color Separation Overlay z 1970 roku dla brytyjskiego programu dziecięcego ‘Blue Peter’. Source: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
W każdym razie, niezależnie od tego, czy chodzi o elementy filmowe, czy wideo, wyodrębniony materiał mógł być następnie wstawiany do dowolnego innego materiału.
Choć znacznie droższy i zastrzeżony proces sodu‑parowego Disneya (oparty na żółtym kluczu i także używany w horrorze Alfreda Hitchcocka z 1963 roku The Birds) zapewniał lepszą definicję i wyraźniejsze maty, fotochemiczne wyodrębnianie pozostawało żmudne i niepewne.

Zastrzeżony proces wyodrębniania sodu‑parowego Disneya wymagał teł bliskich żółtemu zakresowi spektrum. Na zdjęciu Angela Lansbury jest zawieszona na linach podczas produkcji sekwencji pełnej efektów VFX dla ‘Bedknobs and Broomsticks’ (1971). Source
Poza cyfrowym matowaniem
W latach 90. rewolucja cyfrowa zrezygnowała z chemikaliów, ale nie z potrzeby zielonych ekranów. Stało się możliwe usunięcie zielonego (lub innego) tła jedynie poprzez wyszukiwanie pikseli w określonym zakresie tolerancji tego koloru, w programach do edycji pikseli, takich jak Photoshop, oraz w nowej generacji pakietów do kompozycji wideo, które potrafiły automatycznie usuwać kolorowe tła. Niemal natychmiast, sześćdziesiąt lat przemysłu drukowania optycznego zostało zapisane w historii.
Ostatnie dziesięć lat badań nad komputerowym widzeniem przyspieszanym przez GPU wprowadza wyodrębnianie mat do trzeciej ery, stawiając przed badaczami zadanie opracowania systemów, które potrafią wyodrębniać maty wysokiej jakości bez potrzeby zielonych ekranów. Same na arXiv publikacje dotyczące innowacji w wyodrębnianiu pierwszoplanowego opartego na uczeniu maszynowym pojawiają się co tydzień.
Umieszczanie nas w obrazie
To miejsce zainteresowania akademickiego i przemysłowego wyodrębnianiem AI już wpłynęło na rynek konsumencki: surowe, ale działające implementacje są nam wszystkim znane w postaci filtrów Zoom i Skype, które mogą zamienić tło naszego salonu na tropikalne wyspy i inne sceny podczas połączeń wideo.
Jednak najlepsze maty nadal wymagają zielonego ekranu, jak Zauważył Zoom w zeszłą środę.

Po lewej, mężczyzna przed zielonym ekranem, z dobrze wyodrębnionymi włosami dzięki funkcji Wirtualnego Tła Zoom. Po prawej, kobieta przed zwykłym domowym otoczeniem, z włosami wyodrębnionymi algorytmicznie, mniej dokładnie i przy większych wymaganiach obliczeniowych. Source: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Kolejny post na platformie pomocy Zoom ostrzega, że wyodrębnianie bez zielonego ekranu wymaga także większej mocy obliczeniowej w urządzeniu przechwytującym.
Potrzeba wycięcia
Ulepszenia w jakości, przenośności i oszczędności zasobów systemów wyodrębniania mat ‘w terenie’ (tj. izolowanie osób bez potrzeby zielonych ekranów) są istotne dla wielu sektorów i zastosowań, nie tylko filtrów wideokonferencji.
W rozwoju zbiorów danych, ulepszone rozpoznawanie twarzy, pełnej głowy i całego ciała daje możliwość zapewnienia, że niepożądane elementy tła nie zostaną wprowadzone do modeli widzenia komputerowego dotyczących ludzi; dokładniejsze izolowanie znacznie poprawiłoby techniki segmentacji semantycznej przeznaczone do rozróżniania i integracji domen (np. ‘cat’, ‘person’, ‘boat’), oraz usprawniłoby systemy syntezy obrazu oparte na VAE i transformerach, takich jak nowy DALL‑E 2 od OpenAI; lepsze algorytmy wyodrębniania zmniejszyłyby potrzebę kosztownego ręcznego rotoskopowania w drogiej produkcji VFX.
W rzeczywistości rosnąca popularność metodologii multimodalnych (zwykle tekst/obraz), w których domena taka jak „cat” jest kodowana zarówno jako obraz, i powiązane odniesienia tekstowe, już wkracza w przetwarzanie obrazów. Jednym z niedawnych przykładów jest architektura Text2Live, która wykorzystuje trening multimodalny (tekst/obraz) do tworzenia wideo, między innymi, kryształowych łabędzi i szklanych żyraf.
Matowanie AI świadome sceny
Duża część badań nad automatycznym matowaniem opartym na AI skupiała się na rozpoznawaniu krawędzi i ocenie grupowań pikseli w obrazie lub klatce wideo. Jednak nowe badania z Chin proponują pipeline wyodrębniania, który poprawia wyznaczanie granic i jakość maty, wykorzystując opisy tekstowe sceny (podejście multimodalne, które zyskało na znaczeniu w sektorze badań nad widzeniem komputerowym w ciągu ostatnich 3‑4 lat), twierdząc, że ulepszyło wcześniejsze metody na wiele sposobów.

Przykład wyodrębniania SPG‑IM (ostatni obraz, w prawym dolnym rogu), porównany z konkurencyjnymi metodami wcześniejszymi. Source: https://arxiv.org/pdf/2204.09276.pdf
Wyzwanie stojące przed podsektorem badań nad wyodrębnianiem polega na stworzeniu przepływów pracy, które wymagają minimalnej ilości ręcznej anotacji i interwencji człowieka – najlepiej żadnej. Poza kosztami, badacze nowego artykułu zauważają, że anotacje i ręczne segmentacje wykonywane przez zewnętrznych pracowników z różnych kultur mogą powodować, że obrazy są oznaczane lub nawet segmentowane na różne sposoby, co prowadzi do niespójnych i niezadowalających algorytmów.
Jednym z przykładów jest subiektywna interpretacja tego, co definiuje „obiekt pierwszoplanowy”:

Z nowego artykułu: wcześniejsze metody LFM i MODNet (‘GT’ oznacza Ground Truth, czyli „idealny” wynik często uzyskiwany ręcznie lub metodami nie‑algorytmicznymi) mają różne i różnie skuteczne podejścia do definicji treści pierwszoplanowej, podczas gdy nowa metoda SPG‑IM skuteczniej wyznacza „bliską treść” dzięki kontekstowi sceny.
Aby temu zaradzić, badacze opracowali dwustopniowy pipeline zatytułowany Situational Perception Guided Image Matting (SPG‑IM). Dwustopniowa architektura enkoder‑dekoder składa się z Situational Perception Distillation (SPD) oraz Situational Perception Guided Matting (SPGM).

Architektura SPG‑IM.
Najpierw SPD wstępnie trenuje przekształcenia cech wizualno‑tekstowych, generując podpisy adekwatne do powiązanych obrazów. Następnie prognozowanie maski pierwszoplanowej jest możliwe dzięki połączeniu pipeline’u z nową techniką predykcji uwagi (saliency).
Następnie SPGM generuje szacowaną matę alfa na podstawie surowego obrazu RGB oraz maski wygenerowanej w pierwszym module.
Celem jest prowadzenie przez percepcję sytuacyjną, w której system posiada kontekstowe rozumienie zawartości obrazu, co pozwala mu np. sformułować wyzwanie wyodrębnienia skomplikowanych włosów z tła, uwzględniając znane cechy takiego konkretnego zadania.

W poniższym przykładzie SPG‑IM rozumie, że linki są nieodłączną częścią „parasutki”, podczas gdy MODNet nie zachowuje i nie definiuje tych szczegółów. Podobnie powyżej, pełna struktura urządzenia placu zabaw jest arbitralnie tracona w MODNet.
Nowy artykuł nosi tytuł Situational Perception Guided Image Matting i pochodzi od badaczy z OPPO Research Institute, PicUp.ai oraz Xmotors.
Inteligentne automatyczne maty
SPG‑IM oferuje także sieć Refinement Network o nazwie Adaptive Focal Transformation (AFT), która może przetwarzać lokalne szczegóły i globalny kontekst osobno, ułatwiając tworzenie „inteligentnych mat”.

Zrozumienie kontekstu sceny, w tym przypadku „dziewczyna z koniem”, może potencjalnie ułatwić wyodrębnianie pierwszoplanowe w porównaniu do wcześniejszych metod.
W artykule stwierdzono:
‘Wierzymy, że reprezentacje wizualne pochodzące z zadania wizualno‑tekstowego, np. opisywanie obrazów, koncentrują się na bardziej semantycznie kompleksowych sygnałach pomiędzy a) obiekt‑obiekt i b) obiekt‑środowisko, aby generować opisy obejmujące zarówno informacje globalne, jak i szczegóły lokalne. Ponadto, w porównaniu do kosztownej anotacji pikselowej przy matowaniu obrazu, etykiety tekstowe mogą być zbierane masowo przy bardzo niskich kosztach.’
Gałąź SPD architektury jest wspólnie wstępnie trenowana z transformatorowym dekoderem tekstowym VirTex Uniwersytetu Michigan, który uczy się reprezentacji wizualnych na podstawie semantycznie gęstych opisów.

VirTex wspólnie trenuje ConvNet i Transformatory za pomocą par obraz‑opis, i przenosi uzyskane wnioski na dalsze zadania wizji komputerowej, takie jak wykrywanie obiektów. Source: https://arxiv.org/pdf/2006.06666.pdf
Wśród innych testów i badań ablacjnych, badacze porównali SPG‑IM z najnowocześniejszymi metodami opartymi na trimapie trimap, takimi jak Deep Image Matting (DIM), IndexNet, Context‑Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA oraz Semantic Image Mapping (SIM).
Inne testowane wcześniejsze ramy obejmowały podejścia bez trimapu LFM, HAttMatting oraz MODNet. Dla uczciwego porównania, testowane metody zostały dostosowane do różniących się metodologii; tam gdzie kod nie był dostępny, techniki z artykułu odtworzono na podstawie opisanej architektury.
W artykule stwierdzono:
‘Nasze SPG‑IM przewyższa wszystkie konkurencyjne metody bez trimapu ([LFM], [HAttMatting] i [MODNet]) o dużą przewagę. Jednocześnie nasz model wykazuje niezwykłą przewagę nad najnowocześniejszymi (SOTA) metodami opartymi na trimapie i maskach pod względem wszystkich czterech metryk w publicznych zestawach danych (tj. Composition‑1K, Distinction‑646 i Human‑2K), oraz naszym benchmarkiem Multi‑Object‑1K.’
Można wyraźnie zauważyć, że nasza metoda zachowuje drobne szczegóły (np. końcówki włosów, przezroczyste tekstury i krawędzie) bez użycia trimapu. Co więcej, w porównaniu z innymi konkurencyjnymi modelami bez trimapu, nasze SPG‑IM potrafi zachować lepszą globalną spójność semantyczną.


Pierwsze opublikowanie 24 kwietnia 2022.