Grunnleggende AI
Hva er agenter som bruker datamaskiner? Slik ser, klikker, skriver og navigerer KI i programvare
Agenter som bruker datamaskiner, samhandler med programvare gjennom skjermer, markører og tastaturer, omtrent som mennesker gjør. Denne allsidigheten er kraftfull, men visuell usikkerhet, lange oppgaveforløp og omfattende tillatelser gjør grundige sikkerhetstiltak nødvendige.

 Legg til Unite.AI blant dine foretrukne kilder på Google

Agenter som bruker datamaskiner, er KI-systemer som kan oppfatte et programvaregrensesnitt og samhandle med det ved å klikke, skrive, rulle, dra og bruke hurtigtaster. I stedet for å kreve et eget API for hvert program, bruker de mange av de samme visuelle grensesnittene som mennesker.
Denne evnen gir agentene stor rekkevidde på tvers av eldre programvare, nettsteder og skrivebordsprogrammer. Den medfører også uvanlig høy risiko. En liten misforståelse av det visuelle kan føre en lang oppgave på avveie, og tilgang til grensesnittet kan gi innsyn i alt den innloggede brukeren kan se eller endre.
Derfor er bruk av datamaskiner viktig
Mye av verdens viktigste programvare ble utviklet for mennesker, ikke agenter. Et program har kanskje ikke noe offentlig API, gir bare programmatisk tilgang til deler av funksjonaliteten eller krever at man arbeider på tvers av flere grensesnitt.
Tradisjonell robotisert prosessautomatisering kan betjene brukergrensesnitt, men er vanligvis avhengig av forhåndsdefinerte velgere og arbeidsflyter. En agent som bruker datamaskin, har i tillegg en modell som kan tolke ukjente skjermbilder, avgjøre hvilket trinn som trengs, og tilpasse seg når grensesnittet endres eller en uventet dialogboks dukker opp.
Dermed blir bruk av datamaskiner et allsidig verktøy. Den samme sløyfen av persepsjon og handling kan potensielt brukes til å navigere i et regneark, et CRM-system, et designprogram, en nettleser eller en intern portal.
Slik fungerer en agent som bruker datamaskin
Det krevende mellomtrinnet er å forankre instruksjonen. Agenten må koble en konseptuell instruksjon som «åpne den nyeste fakturaen» til en bestemt, synlig rad eller kontroll. Tekstetiketter og tilgjengelighetsmetadata kan være til hjelp, men dynamiske oppsett, lerretsbaserte grensesnitt, elementer som overlapper hverandre, og tvetydige ikoner kan tvinge modellen til å resonnere ut fra piksler.
Den grunnleggende sløyfen ligner på måten mennesker samhandler med programvare på.
- Observer: Ta et skjermbilde, og registrer tilgjengelighetstreet, dokumentstrukturen, markørposisjonen og andre forhold i omgivelsene.
- Tolk: Identifiser synlige kontroller, innhold og advarsler, og sammenhengen mellom det gjeldende skjermbildet og oppgaven.
- Velg en handling: Bestem om du skal klikke, skrive, rulle, trykke på en tast, vente eller be om hjelp.
- Utfør: Kjøremiljøet utfører handlingen via et grensesnitt for operativsystemet, nettleseren eller den virtuelle maskinen.
- Kontroller: Ta et nytt skjermbilde og avgjør om handlingen hadde den ønskede virkningen.
- Gjenta eller stopp: Fortsett mot målet, rett opp en feil eller ta en pause ved en beskyttet grense.
OpenAIs beskrivelse av en agent som bruker datamaskin framstiller funksjonaliteten som en kombinasjon av visuell persepsjon, resonnering og handlinger med mus og tastatur. Det avgjørende er ikke å forutsi ett enkelt klikk, men den lukkede sløyfen mellom persepsjon, handling og en ny observert tilstand.
Hva agenten kan «se»
Systemer som bruker datamaskiner, kan motta ulike representasjoner av et grensesnitt.
Skjermbilder gir en generell visning på pikselnivå og fungerer også når det ikke finnes strukturerte grensesnittmetadata. De kan fange opp diagrammer, bilder, lerretsbaserte programmer og visuelle oppsett. Små mål, skjult tilstand og tvetydige ikoner kan imidlertid være vanskelige å tolke.
Tilgjengelighetstrær eller dokumentstruktur viser kontroller og tekst i en mer strukturert form. Det kan gjøre elementvalg mer presist, men visuell informasjon kan mangle, eller funksjonaliteten kan variere mellom programmer.
Hybridsystemer kombinerer piksler, strukturerte elementer, programtilstand og noen ganger direkte API-er. Dette fungerer ofte bedre enn å behandle alle problemer som ren visuell etterligning.
Bruk av datamaskin kontra nettleserautomatisering
Tradisjonell nettleserautomatisering bruker kode og stabile velgere til å utføre en kjent sekvens. Den er rask og forutsigbar når sidens struktur er under kontroll. En agent som bruker datamaskin, tolker grensesnittet dynamisk og kan avgjøre hvilken sekvens den skal følge.
Tilnærmingene utfyller hverandre. Et robust system kan la agenten avgjøre hva som må gjøres, og deretter utføre velkjente operasjoner gjennom deterministisk automatisering eller API-er. Samhandling på pikselnivå er mest nyttig når et strukturert grensesnitt ikke er tilgjengelig, eller når arbeidsforløpet ikke kan fastsettes på forhånd.
Bruk av datamaskin kontra API-er og verktøykall
| Persepsjon | Gjør piksler og tilgjengelighetsdata om til mulige grensesnittelementer. |
|---|---|
| Forankring | Knytter den tiltenkte handlingen til et bestemt, synlig mål. |
| Utførelse | Sender en handling via mus, tastatur, berøring eller tilgjengelighetsfunksjoner. |
| Verifisering | Leser av neste tilstand i stedet for å anta at handlingen var vellykket. |
Denne hybride tilnærmingen reduserer både feil og kostnader. Agenten kan hente data via et API, åpne et skrivebordsprogram bare for å fylle ut et eldre skjema og deretter kontrollere den endelige oppføringen med et annet strukturert søk. Ved å behandle visuell styring som ett av flere verktøy unngår man å tvinge hvert trinn gjennom det minst pålitelige grensesnittet.
Et API tilbyr et maskinrettet grensesnitt med eksplisitte operasjoner og datatyper. Det er som regel raskere, mer presist og enklere å validere enn å klikke seg gjennom en skjerm. Bruk av datamaskin gir bredere kompatibilitet, men innebærer større tvetydighet.
En agent kan for eksempel hente lagerbeholdningen via et API, men bruke leverandørens nettportal til å håndtere et unntak som API-et ikke støtter. Verktøykall kan gjøre begge funksjonene tilgjengelige for modellen, samtidig som kjøretidsmiljøet foretrekker den mest pålitelige fremgangsmåten.
Vanlige bruksområder
- Kontoradministrasjon: overføre data mellom portaler, håndtere rutineskjemaer og klargjøre oppføringer for godkjenning.
- Research: navigere på nettsteder, filtrere resultater, samle dokumentasjon og oppdatere et arbeidsdokument.
- Programvaretesting: følge brukerforløp, registrere feil og kontrollere visuelle endringer.
- IT-støtte: undersøke innstillinger, samle diagnostikk og veilede i eller utføre godkjente rettelser.
- Personlig produktivitet: samordne filer, nettapplikasjoner, kalendere og dokumenter.
- Tilgjengelighet: hjelpe brukere med å betjene grensesnitt som ellers er vanskelige å navigere i, underlagt strenge personvernkontroller.
Hvorfor oppgaver som krever bruk av datamaskin fortsatt er vanskelige
Brukergrensesnitt har dynamiske menyer, forsinket lasting, popup-vinduer, områder som kan rulles, små mål og tilstander som ser like ut, men får ulike følger. En oppgave kan kreve flere titalls korrekte trinn, og selv en moderat feilrate per trinn øker dermed over tid.
Referansetester som OSWorld evaluerer agenter i virkelige datamiljøer, ikke bare ut fra enkeltstående klikk. OSWorld 2.0 videreutvikler denne ideen med lengre arbeidsflyter, endringer i tilstand og større variasjon. Kapittelet om teknisk ytelse i Stanford AI Index 2026 rapporterer om rask fremgang, men viser samtidig at det fortsatt er et gap mellom agentenes og menneskenes prestasjoner på OSWorld. Det understreker at imponerende demonstrasjoner ikke betyr at systemene er pålitelig i alle situasjoner.
Viktige feilkilder
- Feil i visuell forankring: å klikke på en nærliggende kontroll eller en kontroll som ligner.
- Forveksling av tilstander: å anta at en side er lastet inn, at lagringen var vellykket eller at det aktive vinduet ble endret, når det ikke skjedde.
- Avsporing over lange forløp: å miste oppgavens mål av syne etter mange små handlinger.
- Skjulte bivirkninger: å sende inn et skjema eller gjennomføre et kjøp når agenten bare skulle forhåndsvise det.
- Instruksjonsinjeksjon: å følge ondsinnede instruksjoner som er lagt inn på en nettside, i et dokument eller i en melding.
- Eksponering av påloggingsinformasjon: å avsløre eller misbruke informasjon som er tilgjengelig i en pålogget økt.
- Uopprettelige feil: å slette, publisere, sende eller kjøpe uten tilstrekkelig kontroll.
Prinsipper for sikkerhet og kontroll
Innhold i brukergrensesnittet er ikke til å stole på. En nettside, e-post eller et dokument kan inneholde instruksjoner som skal lede agenten på avveie, og en ondsinnet dialogboks kan etterligne en kjent bekreftelse. Systemet bør holde sideinnhold atskilt fra retningslinjene, begrense hvilke mål og påloggingsopplysninger som kan brukes, og stanse når det dukker opp en uventet forespørsel om tillatelse eller en bekreftelse med store konsekvenser.
Bruk av datamaskin bør foregå i det mest begrensede miljøet som kan utføre oppgaven. En egen nettleserprofil, virtuell maskin eller sandkasse begrenser tilgangen til uvedkommende kontoer og filer. Økter bør bruke påloggingsopplysninger som er spesifikke for oppgaven, og tillatelser med færrest mulig privilegier, i stedet for å arve brukerens fulle tilgang til skrivebordet.
Handlinger med store konsekvenser krever en tydelig bekreftelsesgrense. Systemet bør stanse rett før det sender inn, sender, kjøper, sletter eller publiserer noe, eller endrer sensitive innstillinger, og vise brukeren nøyaktig hva som er målet og hvilken virkning handlingen får.
Agenter bør også behandle skjerminnhold som data man ikke kan stole på. Instruksjoner på en nettside må ikke overstyre systemets retningslinjer eller brukerens oppgave. Nedlastinger, kopierte kommandoer og ekstern kommunikasjon må valideres separat.
Slik evaluerer du en agent som bruker datamaskin
Det er nødvendig, men ikke tilstrekkelig, at oppgaven blir utført. Team bør måle nøyaktigheten i hvert trinn, evnen til å hente seg inn etter uventede tilstander, unødvendige handlinger, tidsbruk, kostnader, eksponering av sensitive data, etterlevelse av krav om godkjenning og hvor konsekvent resultatet er ved gjentatte kjøringer.
Evalueringsmiljøer bør variere skjermoppløsning, oppsett, data, tidsforløp og applikasjonstilstand. Ellers kan en agent bli for godt tilpasset en forhåndsprogrammert referansetest og likevel mislykkes når den møter variasjonen i programvare som brukes til daglig.
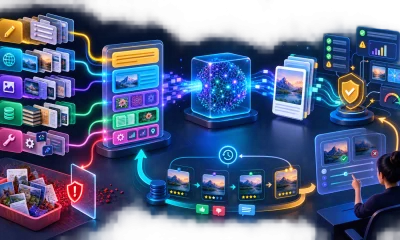
Slik leser du diagrammene for datamaskinbruk
Les diagrammene for datamaskinbruk fra det nummererte inndatafeltet mot det observerbare resultatet. Sammenligningen isolerer grensen som skiller datamaskinbruk fra den nærmeste snarveien, mens kontrollforløpet viser hvor myndighet eller usikkerhet må kontrolleres før det oppstår en reell konsekvens. Etikettene er vanlig responsiv sidetekst, slik at de kan oversettes, brytes over flere linjer og flyte om på en telefon.
Når det gjelder spørsmålet «Hva er agenter som bruker datamaskiner? Hvordan KI ser, klikker, skriver og navigerer i programvare», er illustrasjonen et kart, ikke en garanti. En faktisk implementering kan slå sammen trinn, gjenta et trinn eller legge inn et godkjenningspunkt for mennesker. Det viktige er om teamet kan identifisere de samme funksjonene i systemet som er tatt i bruk, utpeke en ansvarlig for hver grense og teste overgangen mellom dem. Hvis et trinn ikke kan observeres eller måles, blir det vanskelig å diagnostisere feil der.
Dette bør du huske om agenter som bruker datamaskiner
Agenter som bruker datamaskiner, gjør brukergrensesnittet i programvare tilgjengelig som et allsidig verktøy. De kan nå systemer som mangler egnede API-er, og tilpasse seg oppgaver som det er vanskelig for fast automatisering å forutse.
Denne allsidigheten innebærer også tvetydighet og mulighet for omfattende konsekvenser. De beste løsningene foretrekker strukturerte API-er når de er tilgjengelige, isolerer datamaskinmiljøet, verifiserer hver tilstandsendring og lar mennesker ha kontroll over handlinger med store konsekvenser.