
AI-modeller og plattformer
Forskere utvikler en metode for å sammenligne nevrale nettverk

 Legg til Unite.AI blant dine foretrukne kilder på Google
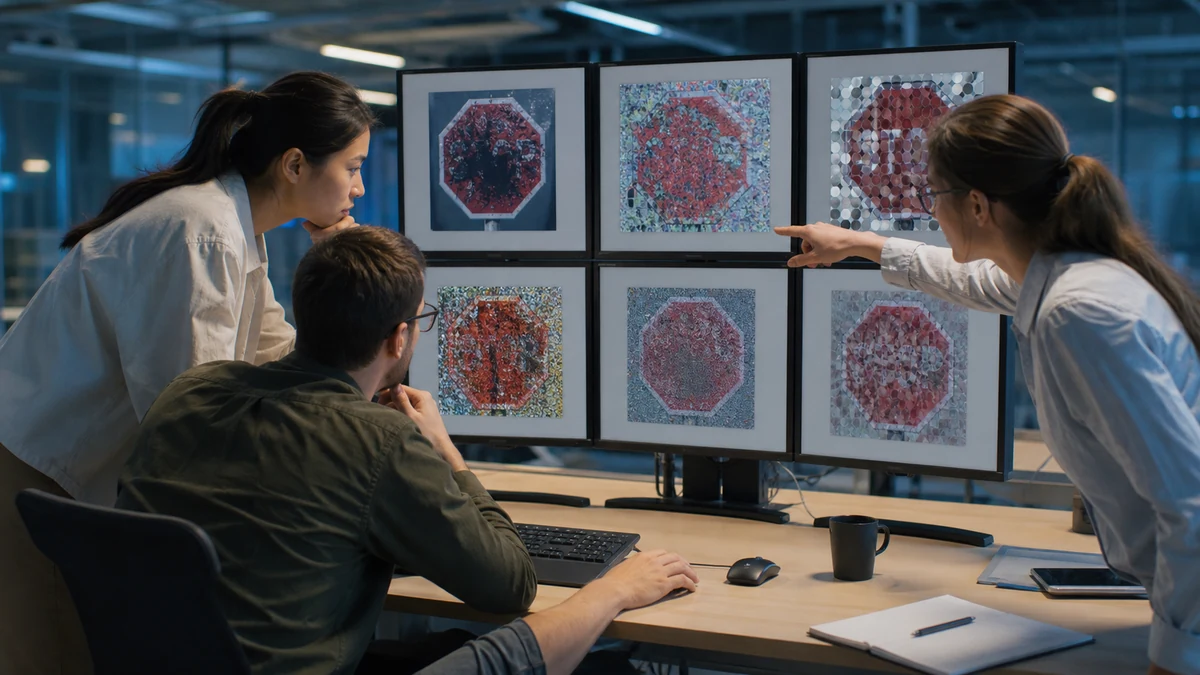
Et team av forskere ved Los Alamos National Laboratory har utviklet en ny metode for å sammenligne nevrale nettverk. Ifølge teamet ser denne nye metoden inn i “black boxen” av kunstig intelligens (KI), og den hjelper dem å forstå atferden til nevrale nettverk. Nevrale nettverk, som gjenkjenner mønster innen datasett, brukes i en rekke applikasjoner som ansiktsgjenkjenningssystemer og selvstyrte kjøretøy.
Teamet presenterte sin artikkel, “If You’ve Trained One You’ve Trained Them All: Inter-Architecture Similarity Increases With Robustness,” på Konferansen om Usikkerhet i Kunstig Intelligens.
Haydn Jones er en forsker i avdelingen for Avansert Forskning i Kybersystemer ved Los Alamos og hovedforfatter av forskningsartikkelen.
Bedre Forståelse av Nevrale Nettverk
“Kunstig intelligens-forskningsmiljøet har ikke nødvendigvis en fullstendig forståelse av hva nevrale nettverk gjør; de gir oss gode resultater, men vi vet ikke hvordan eller hvorfor,” sa Jones. “Vår nye metode gjør et bedre arbeid med å sammenligne nevrale nettverk, som er et kritisk skritt mot bedre forståelse av matematikken bak KI.
Den nye forskningen vil også spille en rolle i å hjelpe eksperter å forstå atferden til robuste nevrale nettverk.
Selv om nevrale nettverk er høytytende, er de også skjøre. Små endringer i forhold, som et delvis dekket stoppskilt som blir prosessert av et selvstyrt kjøretøy, kan få nettverket til å feilidentifisere skiltet. Dette betyr at kjøretøyet kanskje ikke stopper, noe som kan være farlig.
Adversariell trening av nevrale nettverk
Forskerne ønsket å forbedre disse typene nevrale nettverk ved å se på måter å forbedre nettverksrobustheten på. En av tilnærmingene innebærer å “angripe” nettverk under treningprosessen, hvor forskerne med vilje introduserer feil mens de trener KI til å ignorere dem. Prosessen, som kalles adversarial trening, gjør det vanskeligere for nettverkene å bli lurt.
Teamet anvendte den nye målingen av nettverkslikhet på adversarialt trenede nevrale nettverk. De ble overrasket over å finne at adversarial trening får nevrale nettverk i området maskinsyn til å konvergere til lignende datarepresentasjoner, uavhengig av nettverksarkitekturen, når angrepsstørrelsen øker.
“Vi fant at når vi trener nevrale nettverk til å være robuste mot adversarial angrep, begynner de å gjøre de samme tingene,” sa Jones.
Dette er ikke første gang eksperter har søkt å finne den perfekte arkitekturen for nevrale nettverk. Men de nye funnene viser at introduksjonen av adversarial trening lukker gapet betydelig, noe som betyr at KI-forskningsmiljøet kanskje ikke trenger å utforske så mange nye arkitekturer siden det nå er kjent at adversarial trening får diverse arkitekturer til å konvergere til lignende løsninger.
“Ved å finne at robuste nevrale nettverk er like hverandre, gjør vi det lettere å forstå hvordan robust KI kan virkelig fungere,” sa Jones. “Vi kan kanskje til og med avdekke hint om hvordan persepsjon skjer hos mennesker og andre dyr.”



