
AI-modeller og plattformer
Mistral AI: Setter nye standarder Beyond Llama2 i åpen kildekode-rommet

 Legg til Unite.AI blant dine foretrukne kilder på Google

Store språkmodeller (LLM) har nylig kommet i rampelyset, takket være fremragende utførelser som ChatGPT. Da Meta introduserte sine Llama-modeller, ble det igangsatt en fornyet interesse for åpen kildekode-LLM-er. Målet? Å skape rimelige, åpne kildekode-LLM-er som er like gode som toppmodellene som GPT-4, men uten den høye prislappen eller kompleksiteten.
Dette kombinert av rimelighet og effisiens åpnet ikke bare opp nye veier for forskere og utviklere, men satte også scenen for en ny æra av teknologiske fremsteg i naturlig språkbehandling.
Nylig har generative AI-startups hatt en god økonomi med finansiering. Together samlet inn 20 millioner dollar, med mål om å forme åpen kildekode-AI. Anthropic samlet også inn en imponerende 450 millioner dollar, og Cohere, i samarbeid med Google Cloud, sikret 270 millioner dollar i juni i år.
Introduksjon til Mistral 7B: Størrelse og tilgjengelighet

Mistral AI, basert i Paris og medgrunnlagt av tidligere ansatte fra Google’s DeepMind og Meta, annonserte sin første store språkmodell: Mistral 7B. Denne modellen kan enkelt lastes ned av hvem som helst fra GitHub og også via en 13,4-gigabyte torrent.
Dette startup lyktes å sikre rekordhøy seed-finansiering før de hadde et produkt ute. Mistral AI sin første modell med 7 milliarder parametermodell overgår Llama 2 13B i alle tester og slår Llama 1 34B i mange målinger.
I sammenligning med andre modeller som Llama 2, tilbyr Mistral 7B lignende eller bedre evner, men med mindre beregningsmessig overhead. Mens grunnleggende modeller som GPT-4 kan oppnå mer, kommer de til en høyere kostnad og er ikke like brukervennlige siden de hovedsakelig er tilgjengelige gjennom API-er.
Når det gjelder kodingsoppgaver, gir Mistral 7B CodeLlama 7B en utfordring. Pluss, den er komprimert nok til 13,4 GB for å kjøre på standardmaskiner.
I tillegg har Mistral 7B Instruct, som er tilpasset spesifikt for instruksjonsdatasett på Hugging Face, vist stor ytelse. Den overgår andre 7B-modeller på MT-Bench og står skulder til skulder med 13B-samtalemodeller.

Hugging Face Mistral 7B Eksempel
Ytelsesbenchmarking
I en detaljert ytelsesanalyse ble Mistral 7B målt mot Llama 2-familien. Resultatene var klare: Mistral 7B overgikk Llama 2 13B i alle benchmarktester. Faktisk, den matchet ytelsen til Llama 34B, spesielt i kode- og resonneringsbenchmark.
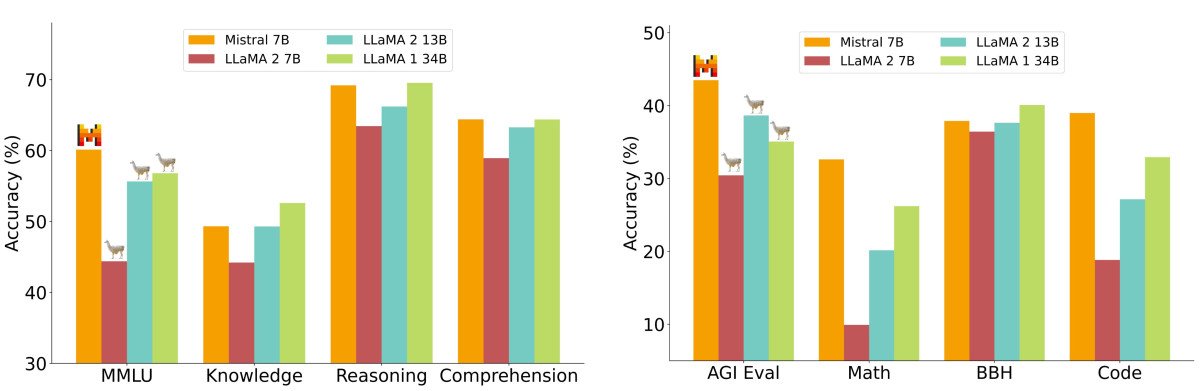
Benchmarkene ble organisert i flere kategorier, som f.eks. Commonsense Reasoning, World Knowledge, Reading Comprehension, Math og Code, blant andre. En særlig merkbart observasjon var Mistral 7B sin kost-ytelsesmetrikk, betegnet “ekvivalent modellstørrelse”. I områder som resonnering og forståelse, viste Mistral 7B en ytelse lik en Llama 2-modell tre ganger sin størrelse, noe som indikerer potensielle besparelser i minne og en økning i gjennomstrømming. Imidlertid, i kunnskapsbenchmark, lignet Mistral 7B Llama 2 13B, noe som trolig skyldes dens parameterbegrensninger som påvirker kunnskapskomprimering.
Hva gjør egentlig Mistral 7B-modellen bedre enn de fleste andre språkmodellene?
Forenkling av oppmerksomhetsmekanismer
Mens detaljene i oppmerksomhetsmekanismer er tekniske, er deres grunnleggende idé relativt enkel. Forestill deg å lese en bok og highlighte viktige setninger; dette er analogt til hvordan oppmerksomhetsmekanismer “highlighter” eller gir viktighet til bestemte datapunkter i en sekvens.
I sammenheng med språkmodeller, muliggjør disse mekanismene at modellen kan fokusere på de mest relevante delene av inndata, slik at utdata er kohesive og kontekstuell akkurat.
I standardtransformatorer beregnes oppmerksomhetsskår med formelen:

Transformers Attention Formula
Formelen for disse skårene inneholder en kritisk steg – matrisemultiplikasjon av Q og K. Utfordringen her er at når sekvenslengden øker, utvider begge matriser seg i henhold til, noe som fører til en beregningsintensiv prosess. Dette skalerbarhetsproblemet er en av de største grunnene til at standardtransformatorer kan være langsomme, spesielt når de håndterer lange sekvenser.

Flervalgsoppmerksomhet (MQA) akselererer ting ved å bruke ett sett “nøkkel-verdi”-hoder, men ofrer noen ganger kvalitet. Nå, du kan lure på, hvorfor ikke kombinere hastigheten til MQA med kvaliteten til flervalgsoppmerksomhet? Det er der Gruppert-spørsmålsoppmerksomhet (GQA) kommer inn.
Gruppert-spørsmålsoppmerksomhet (GQA)

Gruppert-spørsmålsoppmerksomhet
GQA er en midterløsning. I stedet for å bruke bare ett eller flere “nøkkel-verdi”-hoder, grupperer den dem. På denne måten oppnår GQA en ytelse nær den detaljerte flervalgsoppmerksomheten, men med hastigheten til MQA. For modeller som Mistral, betyr dette effektiv ytelse uten å ofre for mye kvalitet.
Glidevinduoppmerksomhet (SWA)

Glidevinduet er en annen metode som brukes til å prosessere oppmerksomhetssekvenser. Denne metoden bruker et faststørrelse oppmerksomhetsvindu rundt hver token i sekvensen. Med flere lag som stablet denne vindusoppmerksomheten, får de øverste lagene til slutt en bredere perspektiv, som omfatter informasjon fra hele inndata. Denne mekanismen er analog til de respektive feltene som ses i Convolutional Neural Networks (CNN).
På den andre siden, “dilatert glidevinduoppmerksomhet” i Longformer-modellen, som er konseptuelt lik glidevindusmetoden, beregner bare noen få diagonaler av matrisen. Denne endringen resulterer i at minnebruk øker lineært i stedet for kvadratisk, noe som gjør det til en mer effektiv metode for lengre sekvenser.
Mistral AI sin gjennomsiktighet vs. sikkerhetsproblemer i desentralisering
I deres annonsering, betonet Mistral AI også gjennomsiktighet med uttalelsen: “Ingen triks, ingen proprietær data.” Men samtidig er deres eneste tilgjengelige modell for øyeblikket ‘Mistral-7B-v0.1’ en forhåndstrænet basismodell, og derfor kan den generere en respons til enhver forespørsel uten moderering, noe som reiser potensielle sikkerhetsproblemer. Mens modeller som GPT og Llama har mekanismer for å avgjøre når de skal svare, kan Mistral sin fullstendig desentraliserte natur utnyttes av dårlige aktører.
Imidlertid har desentraliseringen av store språkmodeller sine fordeler. Mens noen kan misbruke det, kan folk utnytte dens kraft for samfunnets beste og gjøre intelligensen tilgjengelig for alle.
Deployeringsfleksibilitet
En av høydepunktene er at Mistral 7B er tilgjengelig under Apache 2.0-lisensen. Dette betyr at det ikke finnes noen reelle barrierer for å bruke det – enten du bruker det for personlige formål, et stort selskap eller selv en regjering. Du trenger bare riktig system for å kjøre det, eller du må investere i skytjenester.
Mens det finnes andre lisenser som den enklere MIT-lisensen og den kooperative CC BY-SA-4.0, som krever kreditering og lignende lisensiering for derivater, gir Apache 2.0 en solid grunnlag for store prosjekter.
Endelige tanker
Oppblomstringen av åpne kildekode-store språkmodeller som Mistral 7B markerer en avgjørende skifte i AI-industrien, og gjør høykvalitets språkmodeller tilgjengelige for et bredere publikum. Mistral AI sine innovative tilnærminger, som Gruppert-spørsmålsoppmerksomhet og Glidevinduoppmerksomhet, lover effektiv ytelse uten å ofre for mye kvalitet.
Mens den desentraliserte naturen til Mistral stiller visse utfordringer, understreker dens fleksibilitet og åpne kildekode-lisensiering potensialet for å demokratisere AI. Etterhvert som landskapet utvikler seg, vil fokuset uunngåelig være på å balansere kraften til disse modellene med etiske overveielser og sikkerhetsmekanismer.
Hva er neste skritt for Mistral? 7B-modellen var bare begynnelsen. Teamet planlegger å lansere enda større modeller snart. Hvis disse nye modellene matcher 7B sin ytelse, kan Mistral raskt stige som en toppspiller i industrien, allerede i løpet av deres første år.


