
Andersons vinkel
Identifisering av kjendis-deepfakes fra ytre ansiktsregioner

 Legg til Unite.AI blant dine foretrukne kilder på Google
Viktige punkterICT detects deepfakes by comparing inner and outer face identities rather than swap…
Vis mer
- ICT detects deepfakes by comparing inner and outer face identities rather than swap artifacts.
- The method outperforms competitors on low-resolution video where artifact-based detection fails.
- ICT relies on MS-Celeb-1M data limiting its effectiveness to celebrities with abundant public images.
Et nytt samarbeid mellom Microsoft (MSFT ) og et kinesisk universitet har foreslått en ny måte å identifisere kjendis-deepfakes på, ved å utnytte svakheter i nåværende deepfake-teknikker for å gjenkjenne identiteter som har blitt “prosjektert” på andre mennesker.
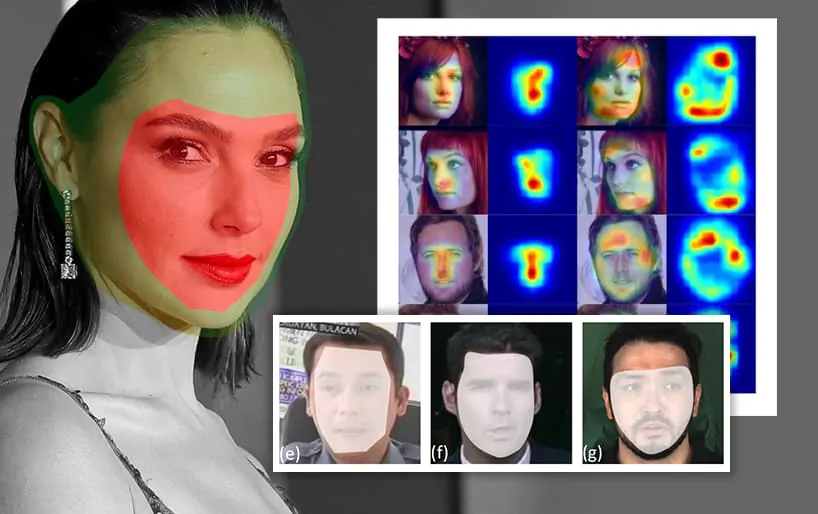
Tilnærmingen kalles Identity Consistency Transformer (ICT), og fungerer ved å sammenligne de ytre delene av ansiktet (kinnben, kjeveben, hårlinje og andre ytre marginale linjementer) med ansiktets indre del. Systemet utnytter vanlig tilgjengelig offentlig bilde-data av berømte personer, som begrenser dens effektivitet til populære kjendiser, hvis bilder er tilgjengelige i store antall i datamengder for datamaskinsyn og på internettet.

Områdene som forfalskes med sju teknikker: DeepFake i FF+ og Google DeepFake Detection, DeepFaceLab, Face2Face, FSGAN og DF-VAE. Populære pakker som DeepFaceLab og FaceSwap har tilsvarende begrenset dekning. Kilde: https://arxiv.org/pdf/2203.01318.pdf
Som bildet ovenfor illustrerer, er nåværende populære metoder for deepfaking ganske ressurskrevende, og avhenger av “kompatible” vertsansikter (bildet eller videoen av en person som skal ha sin identitet erstattet av deepfake) for å minimere bevis på ansikts-erstattning.
Selv om varierende metoder kan omfatte hele pannen og en stor del av kinneben- og kjevebensområdene, er alle mer eller mindre begrenset innenfor rammen av vertsansiktet.

Et kart over fremtredende områder som viser indre og ytre identitet beregnet av ICT. Når den indre identiteten stemmer, men den ytre ikke gjør det, vurderer ICT bildet som falskt.
I tester, viste ICT seg å være i stand til å detektere deepfake-innhold i fake-vennlige omgivelser som lavoppløselig video, hvor innholdet av hele videoen er degradert av kompresjonsartefakter, noe som hjelper til å skjule resterende bevis for deepfake-prosessen – en omstendighet som forvirrer mange konkurrerende deepfake-deteksjonsmetoder.

ICT overgår konkurrentene i å gjenkjenne deepfake-innhold. Kildevideoen på slutten av artikkelen gir flere eksempler og bedre oppløsning. Kilde: https://www.youtube.com/watch?v=zgF50dcymj8
Den artikkelen heter Protecting Celebrities with Identity Consistency Transformer, og kommer fra ni forskere tilknyttet University of Science and Technology of China, Microsoft Research Asia og Microsoft Cloud + AI.
Troverdighetsgapet
Det finnes minst to grunner til at populære ansikts-erstattingsalgoritmer som DeepFaceLab og FaceSwap neglisjerer de ytre områdene av de byttede ansikts-identitetene.
Først og fremst er trening av deepfake-modeller tidskrevende og ressurskritisk, og adopsjonen av “kompatible” vertsansikter/kropper frigjør GPU-sykluser og epoker til å konsentrere seg om de relativt uforanderlige indre områdene av ansiktet som vi bruker til å skille identitet (siden variabler som vektfluktuasjon og aldring er minst sannsynlig å endre disse kjerne-ansikts-trekkene på kort sikt).
For det andre har de fleste deepfake-tilnærmingene (og dette er absolutt tilfelle med DeepFaceLab, programvaren som brukes av de mest populære eller notoriske praktikerne) begrensede evne til å replikere “ansiktskant”-margene som kinne- og kjeveområder, og er begrenset av det faktum at deres oppstrøms (2017) kode ikke omfattende behandlet dette problemet.
I tilfeller hvor identitetene ikke matcher godt, må deepfake-algoritmen “inpaint” bakgrunnsområder rundt ansiktet, noe den gjør klønete til beste, selv i hendene på de beste deepfakers, som Ctrl Shift Face, hvis materiale ble brukt i artikkelenes studier.

Stillbilder fra Ctrl Shift Face sitt deepfake, der ansiktet til Jim Carrey legges over Gary Oldman. Arbeidet er blant de beste eksemplene på DeepFaceLab og etterbehandling, men begrenset håndtering av ansiktets ytterkanter krever enorm innsats med datakuratering og trening. Kilde: https://www.youtube.com/watch?v=x8igrh1eyLk
Dette “taskenspillertriks”, eller avledning av oppmerksomhet, slipper stort sett unna offentlig oppmerksomhet i den nåværende bekymringen over deepfakes’ økende realisme, fordi våre kritiske evner rundt deepfakes ennå er under utvikling forbi “sjokk og ærefrykt”-stadiet.
Delte identiteter
Den nye artikkelen påpeker at de fleste tidligere metoder for deepfake-deteksjon avhenger av artefakter som avslører bytteprosessen, som inkonsistente hodeposisjoner og blink, blant mange andre teknikker. Bare denne uken har en ny deepfake-deteksjonsartikkel forslagt å bruke “signatur”-en til de ulike modelltypene i FaceSwap-rammeverket for å hjelpe med å identifisere forfalsket video laget med det (se bildet nedenfor).

Identifisering av deepfakes ved å karakterisere kjennetegn ved ulike modelltyper i FaceSwap-rammeverket. Kilde: https://arxiv.org/pdf/2202.12951.pdf
I motsetning til dette skaper ICTs arkitektur to separate, innebygde identiteter for en person, hver av dem må være verifisert før hele identiteten kan konkluderes å være “sann” film eller bilde.

Arkitektur for trenings- og testfasene til ICT.
Splittingen av identiteter blir mulig gjennom en visuell Transformer, som utfører ansikts-gjenkjenning før den deler de undersøkte områdene inn i tokens som tilhører de indre eller ytre identitetene.

Fordeling av bildefragmenter mellom to parallelle identitetsrepresentasjoner.
Artikkelen sier:
‘Uheldigvis tenderer eksisterende ansikts-verifisering [metoder] til å karakterisere den mest diskriminerende regionen, dvs. det indre ansiktet for verifisering og mislykkes i å fange identitetsinformasjonen i det ytre ansiktet. Med Identity Consistency Transformer, trener vi en modell for å lære en par identitetsvektorer, en for det indre ansiktet og den andre for det ytre ansiktet, ved å designe en Transformer slik at de indre og ytre identitetene kan læres samtidig i en sammenhengende modell.’
Ettersom det ikke finnes noen eksisterende modell for denne identifiseringsprotokollen, har forfatterne utviklet en ny type konsistens-tap som kan fungere som en målestokk for autentisitet. “Inner token” og “outer token” som resulterer fra identitets-utvinningmodellen, blir lagt til de mer konvensjonelle patch-embeddings produsert av ansikts-gjenkjenning-rammeverk.
Data og Trening
ICT-nettverket ble trent på Microsoft Research’s MS-Celeb-1M-dataset, som inneholder 10 millioner kjendis-ansiktsbilder som dekker 100000 identiteter, inkludert skuespillere, politikere og mange andre typer fremtredende personer. Ifølge prosedyren for tidligere metode Face X-ray (en annen Microsoft Research-initiativ), bytter ICTs egen rutine for å lage forfalskninger indre og ytre regioner av ansikter fra dette datasettet for å skape materiale som kan testes på algoritmen.
For å utføre disse interne byttingene, identifiserer ICT to bilder i datasettet som viser lignende hodeposisjoner og ansikts-landemerker, genererer en maskeringsregion av sentrale trekk (inn i hvilken en bytte kan utføres), og utfører en deepfake-bytte med RGB-fargerekting.
Grunnen til at ICT er begrenset til kjendis-identifikasjon er at den avhenger (i sin mest effektive variasjon) av en ny referanse-sett som inkorporerer avledede ansikts-vektorer fra en sentral korpus (i dette tilfelle MS-Celeb-1M, selv om referansen kunne utvides til nett-tilgjengelig bilde, som bare sannsynligvis ville eksistere i tilstrekkelig kvalitet og kvantitet for velkjente offentlige personer).
Disse avledede vektor-sett-paret fungerer som autentisitetstokene for å verifisere de indre og ytre ansikts-regionene samtidig.
Forfatterne påpeker at tokenene som blir oppnådd fra disse metodene representerer “høy-nivå”-egenskaper, noe som resulterer i en deepfake-deteksjonsprosess som er mer sannsynlig å overleve utfordrende miljøer som lav-oppløselig eller annen degradert video.
Kritisk, er ICT ikke på jakt etter artifact-basert bevis, men er fokusert på identitets-verifiseringsmetoder mer i samsvar med ansikts-gjenkjenningsteknikker – en tilnærming som er vanskelig med lav-volum-data, som er tilfelle med undersøkelsen av hendelser med deepfake-hevn-porno mot ikke-berømte mål.
Tester
Trent på MS-Celeb-1M, ble ICT deretter delt inn i referanse-assistert og “blind” versjoner av algoritmen, og testet mot en rekke konkurrerende datasett og metoder. Disse inkluderte FaceForensics++ (FF++), et datasett av 1000 autentiske og deepfake-videoer skapt over fire metoder inkludert Face2Face og FaceSwap; Google’s Deepfake Detection (DFD), også bestående av tusenvis av Google-genererte deepfake-videoer; Celeb-DeepFake v1 (CD1), som inneholder 408 ekte og 795 syntetiske, lav-artefakt-videoer; Celeb-DeepFake v2, en utvidelse av V1 som inneholder 590 ekte og 5 639 fake-videoer; og Kinas 2020 Deeper-Forensics (Deeper).
Disse er datasettene; deteksjonsmetodene i test-utfordringene var Multi-task, MesoInc4, Capsule, Xception-c0, c2 (en metode brukt i FF++), FWA/DSP-FW fra University at Albany, Two-Branch, PCL+I2G, og Yuval Nirkin’s kontekst-discrepancy-metode.
De ovennevnte deteksjonsmetodene er rettet mot å detektere bestemte typer ansikts-manipulasjon. I tillegg til disse, testet artikkelenes forfattere mer generelle deepfake-deteksjons-tilbud Face X-ray, Michigan State University’s FFD, CNNDetection, og Patch-Forensics fra MIT CSAIL.
De mest synlige resultater fra testen er at de konkurrerende metodene dramatisk faller i effektivitet når video-oppløsning og kvalitet synker. Ettersom noen av de mest alvorlige potensiale for deepfake-penetrering av våre diskriminerende krefter ligger (ikke minst nå) i ikke-HD eller annen kvalitets-kompromittert video, synes dette å være et betydelig resultat.

I grafen ovenfor viser de blå og røde kurvene at ICT tåler bildeforringelse godt, bortsett fra gaussisk støy, som er mindre sannsynlig i Zoom- og webkameravideo. De konkurrerende metodenes pålitelighet faller derimot kraftig.
I resultattabellen ovenfor ser vi effektiviteten av de ulike deepfake-deteksjonsmetodene på de usette datasettene. Grå og stjernemerkede resultater indikerer sammenligning fra opprinnelig publiserte resultater i lukkede prosjekter, som ikke kan verifiseres eksternt. Over nesten alle sammenlignbare rammeverk, overgår ICT de konkurrerende deepfake-deteksjons-tilnærmingene (vist i fet skrift) over de testede datasettene.

Som et tilleggstest, kjørte forfatterne innhold fra YouTube-kanalen til den anerkjente deepfaker Ctrl Shift Face, og fant at konkurrerende metoder oppnådde bemerkelsesverdig lavere identifiseringspoeng:

Bemerkelsesverdig her er at FF++-metodene (Xception-c23) og FFD, som oppnår noen av de høyeste poengene over noen av testdataene i den nye artikkelenes generelle tester, her oppnår et mye lavere poeng enn ICT i en “virkelig verden”-kontekst av høy-innsats deepfake-innhold.
Forfatterne konkluderer artikkelen med håpet om at dens resultater styre deepfake-deteksjons-samfunnet mot lignende initiativer som konsentrerer seg om mer lett generaliserbare høy-nivå-egenskaper, og vekk fra “den kalde krigen” av artifact-deteksjon, hvor de siste metodene stadig blir gjort utdaterte av utviklinger i deepfake-rammeverk, eller av andre faktorer som gjør slike metoder mindre motstandsdyktige.
Se på den tilhørende supplementære videoen nedenfor for flere eksempler på ICT som identifiserer deepfake-innhold som ofte overgår alternative metoder.
Først publisert 4. mars 2022.


