
Intervjuer
Dr. Mathilde Pavis, juridisk leder, OpenOrigins – Intervju-serie

 Legg til Unite.AI blant dine foretrukne kilder på Google
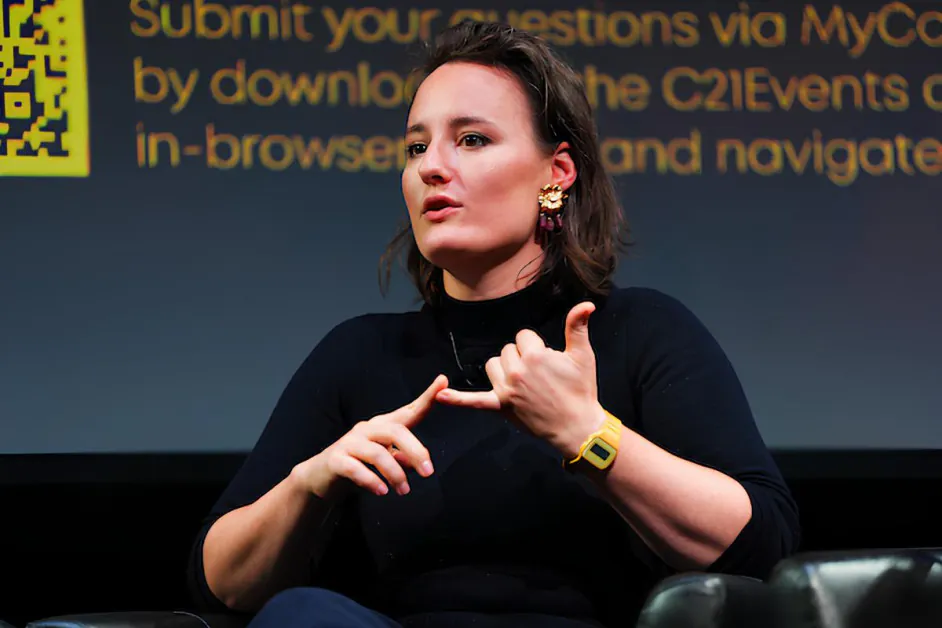
Dr. Mathilde Pavis, juridisk leder i OpenOrigins, er en ledende ekspert på AI-regulering og digital mediestyring, med spesialisering på deepfakes, syntetisk media og innholdsgodkjenning. Hun rådgir selskaper, myndigheter og fagforeninger om etterlevelse, lisensiering og risiko i generativ AI, og har arbeidet med Microsoft (MSFT ) og ElevenLabs på AI-politikk og strategi. Hun har også rådgitt UNESCO om AI og immaterielle rettigheter, og bidrar regelmessig med ekspertvitnesbyrd til britiske beslutningstakere.
OpenOrigins utvikler teknologi for å bekjempe desinformasjon og deepfakes ved å lage verifiserbare, uforanderlige poster om digitalt innhold. Plattformen fokuserer på å etablere tydelig godkjenning, som gjør det mulig for medier, skapere og plattformer å bevise når og hvordan innholdet ble skapt, redigert og distribuert – en stadig viktigere evne ettersom syntetisk media blir mer avansert og vanskeligere å oppdage.
Du har rådgitt myndigheter, globale institusjoner som UNESCO, og selskaper som Microsoft og ElevenLabs om AI-regulering. Hva ledet deg til å fokusere spesielt på deepfakes, digitale kopier og syntetisk media, og hvordan har den reisen formet din beslutning om å etablere Replique?
Min arbeid med deepfakes begynte ikke med teknologien – det begynte med et mye eldre juridisk puslespill. Da jeg startet å forskke på immaterielle rettigheter for min doktorgrad i 2013, ble jeg slått av hvor mye mindre beskyttelse utøvere mottar sammenlignet med forfattere, komponister eller filmprodusenter. I praksis betyr det at dine ord eller din musikk blir bedre beskyttet i loven enn din stemme, ditt ansikt og din kropp. Den ubalansen føltes merkelig, og det gjorde meg til å stille en dypere spørsmål: hvordan vurderer vi kulturelt og juridisk arbeidet til noen hvis bidrag er deres ansikt, stemme og kropp på skjermen?
Det spørsmålet ledet meg inn i utøverrettigheter og data. På den tiden ble det ansett som et nisjeområde med liten kommersiell relevans. Jeg ble aktivt rådet til å flytte inn i mer “lucrative” felt som patenter eller tradisjonell opphavsrett. Antagelsen var at spørsmål om en persons likhet eller stemme i hovedsak ble håndtert uformelt – gjennom bransjenormer eller “gentlemannsavtaler i Hollywood”. Men for meg signaliserte mangelen på formell beskyttelse en åpning, ikke en dødvei for min forskning, så jeg fortsatte med det.
Hva som har endret seg, er at i dag er nesten alle utøvere. Våre liv er formidlet gjennom kameraer – på telefoner, bærbare datamaskiner, videomøter og sosiale plattformer. Uansett om det er for arbeid eller personlig bruk, er mennesker konstant opptatt av å filme og dele versjoner av seg selv. De juridiske spørsmål som en gang bare gjaldt skuespillere eller musikere, gjelder nå for alle med en smarttelefon.
Deepfakes skapte ikke disse problemene – de avdekket og akselererte dem. Forskningen jeg hadde gjort fra 2013 og utover, ble plutselig viktig. Rundt 2017 og 2018 begynte utviklingen av nevralt nettverk – spesielt fra steder som MIT og UC Berkeley – å demonstrere hvor overbevisende en persons ansikt, stemme og kropp kunne bli digitalt manipulert. Innen ett år ble den kapasiteten kjent som “deepfakes”, og den fikk først fart i svært skadelige måter, spesielt gjennom ikke-samtykkende seksuelt innhold som rammet kvinner og barn.
Først senere kom de kommersielle implikasjonene, da de kreative industrien begynte å bruke syntetisk media. Da kom de kontraktmessige og økonomiske spørsmålene jeg hadde arbeidet med, til å dominere. Nesten over natten ble det som en gang ble ansett som et teoretisk eller doktrinært område av loven, et høyt praktisk, kommersielt signifikant og sosialt presserende felt.
I kjernen har den juridiske utfordringen ikke endret seg: mennesker ønsker å dele aspekter av seg selv, men ønsker likevel å beholde meningsfull kontroll. Eksisterende rammer strever med den nyanseringen. De tenderer til å behandle individer som enten helt private eller fullstendig offentlige – enten beskyttet eller fair game. Men de fleste mennesker eksisterer et sted midt imellom. Den spenningen er nå sentral, ikke bare for profesjonelle utøvere, men for alle som deltar i digitalt liv.
Jeg ble kjent som noen som forsket og arbeidet i dette området, noe som ledet meg til å arbeide med myndigheter som ønsket å beskytte mennesker mot deepfakes, og selskaper som ønsket å gjøre digitale kloningprodukter trygge å bruke, som ElevenLabs. Hos Replique bringer jeg alt jeg har lært til mennesker og selskaper som ønsker å bruke digital kloning eller digitalt replikasjonsteknologi ansvarlig og trygt. Jeg har i praksis omdannet min “blå himmel”-forskning til en rådgivningsvirksomhet som bringer spesialisert juridisk rådgivning til de kreative industrene.
Som juridisk leder i OpenOrigins, et selskap som fokuserer på å etablere en uforanderlig post om innholdsgodkjenning for å bekjempe deepfakes, hvordan ser du på godkjenning-baserte systemer i forhold til tradisjonelle deepfake-oppdagingstiltak?
Å sammenligne deepfake-oppdagingstøy kan raskt bli en “epler og appelsiner”-øvelse, fordi deres effektivitet avhenger av kontekst og formål. Fra en politisk synsvinkel, trenger vi en rekke komplementære verktøy – det finnes ingen enkelt “best” løsning, og Open Origins er bare en del av det videre økosystemet. Der OpenOrigins’ teknologi utmerker seg som en deepfake-oppdagingløsning, er i situasjoner hvor en innholdsskaper eller informasjonsorganisasjon trenger å bevise autentisiteten av innholdet de deler med partnere, publikum eller offentligheten.
Ved å tilby verifiserbar godkjenning og “kvitteringer” ved skapningstidspunktet, tilbyr det en sterk form for forebygging ved å demonstrere at innholdet ikke er en deepfake. Imidlertid er denne tilnærmingen mindre nyttig for vanlige internettbrukere som ønsker å raskt vurdere innhold de møter på nettet. I slike tilfeller avhenger oppdaging mer av probabilistiske og innholdsanalysemåter enn godkjenning-basert verifisering. Vi trenger ulike verktøy for ulike behov, og vi må akseptere at det ikke finnes noen sølvkule mot deepfakes.
Fra et juridisk synspunkt, hva er for øyeblikket den største gapet i hvordan jurisdiksjoner håndterer samtykke og eierskap i AI-generert eller AI-replisert innhold?
Oof, hvor lenge har du? Svaret avhenger av hva vi mener med AI-generert eller replisert innhold. Problemene varierer avhengig av om du ser på et AI-generert bilde av et hus eller en katt. Eller en digital rekonstruksjon av en persons ansikt eller stemme. La oss holde oss til temaet deepfakes og digitalt repliseringsinnhold, og svare på spørsmålet i sammenheng med “digital kloning”.
Når det gjelder samtykke, er hovedproblemet at de fleste kontrakter – enten det er ansettelsesavtaler eller plattformsvilkår – inneholder brede, vagt formulerede klausuler som gir omfattende rettigheter over brukerinnhold. Disse kan tolkes som en form for “bakdør-samtykke” hvor å godkjenne vilkår kan anses å bety å samtykke til bruk som kloning, selv om de fleste mennesker ville sterkt bestride den tolkningen. Dette skaper et betydelig gap mellom juridisk tolkning og brukerforventning, noe som for øyeblikket fordeler selskaper mens reguleringen ligger etter.
Når det gjelder eierskap, finnes det ingen klart juridisk svar på hvem som eier en digital kopi, fordi eksisterende rammer som datavern, opphavsrett og personlige rettigheter ikke var designet for denne teknologien. I dag blir de fleste mennesker scannet og klonet på jobben, på forespørsel og med finansiering fra en arbeidsgiver eller en kunde. Og disse enhetene forventer vanligvis en høy grad av kontroll over denne eiendommen, noe som er forståelig, men ofte problematisk fordi eiendommen er en digital kopi av ditt ansikt eller din stemme, og kan få deg til å si ting du aldri har sagt, eller gjøre ting du aldri har gjort.
Spørsmålet om “hvem eier din kopi?” er veldig viktig, men ubesvart i loven i dag.
Du har arbeidet tett på talekloningsteknologier. Hva er de mest misforståtte juridiske risikoene når det gjelder syntetiske stemmer, både for selskaper og enkeltpersoner?
Det mest misforståtte spørsmålet i juridisk overensstemmelse er balansen mellom et selskaps kommersielle interesser i å finansiere og utnytte en digital kopi, og enkeltpersonens rett til personvern og digital verdighet. Den spenningen ligger over flere juridiske regimer (primært immaterielle rettigheter, datavern og personvern) som aldri var designet til å fungere sammen og tolker kloning på grunnleggende forskjellige måter. Som resultat er det komplekst og ofte uklart å oversette dette til praktiske, forretningsvennlige praksiser. Selskaper overse derfor ofte nøkkelrisiko eller incurre betydelige kostnader for å navigere dem ordentlig. Dette skaper et pervert resultat hvor ansvarlig overensstemmelse blir den vanskeligere og dyrere veien, snarere enn standarden.
Hvordan bør bedrifter tenke på samtykkearkitektur i AI-systemer, spesielt når det gjelder likhet, identitet og treningsdata?
Selskaper bør designe sine systemer rundt tre kjerneevner. Først må de sikre informert, kontekstuell samtykke ved innlogging. For det andre må de gjøre det enkelt for brukerne å trekke tilbake samtykket og slette noen eller all deres data, noe som er teknisk utfordrende og ofte overse, men essensielt for overensstemmelse med lover som UK og EU GDPR og lignende regimer i USA. Å vedlikeholde samtykke over tid betyr å bygge systemer hvor tilbaketrekking er operasjonelt glatt og i tråd med forretningsmodellen.
Samtykke må være granulert. Og for det tredje bør brukerne kunne håndtere tillatelser på filnivå, oppdatere deres likhetsdata og forstå hvordan den brukes. Dette krever gjennomsiktighet og kontroll – verktøy som tillater brukerne å overvåke, gjennomgå og moderere hvordan deres digitale kopier blir deployert. Denne graden av fleksibilitet er fortsatt sjelden, men det er der konkurranser fordelen ligger.
I din erfaring med å rådgive både startup-selskaper og myndigheter, hvor er den største misforståelsen mellom hvordan AI utvikles og hvordan den reguleres?
Misforståelsen mellom hvordan AI utvikles og hvordan den reguleres, kommer ned til fundamentalt forskjellige mål. Myndigheter regulerer i offentlighetens interesse, mens AI-selskaper (ofte venture-finansiert) primært drives av vekst, inntekt og fortjeneste. Disse prioriteringene konflikt ikke alltid, men de trekker ofte i forskjellige retninger, med regulering sett på som en begrensning snarere enn en støtte.
Dette skaper en strukturell spenning: reguleringer og innovatører opererer med forskjellige incitamenter, verdier og språk. Det gjør harmonisering vanskelig i praksis, selv om det ikke er umulig. Vi begynner å se en ny bølge av teknologiselskaper som ligner mer på offentlige mål, men de forblir unntakene snarere enn regelen – spesielt blant de som lykkes å skala opp.
OpenOrigins fokuserer på å verifisere innhold ved skapningstidspunktet ved hjelp av kryptografisk godkjenning. Hvor kritisk er denne opprinnelses-først-tilnærmingen sammenlignet med etter-distribusjonssikkerhetstiltak?
Dette løper tilbake til mitt svar ovenfor. Å autentisere innhold ved skapningstidspunktet, “upstream”, er langt mer effektivt enn å forsøke å verifisere det ved distribusjonstidspunktet eller forbrukstidspunktet, dvs. “downstream”. Å autentisere innhold ved skapningstidspunktet er som å spore mat fra øyeblikket den dyrkes på gården, snarere enn å prøve å gjøre det ut fra hva som er på din tallerken. Hvis du vet hvor kycklingen ble oppdrettet, hvordan den ble behandlet og hvordan den ble flyttet gjennom forsyningskjeden, kan du stole på hva du spiser. Hvis du derimot prøver å gjette på alt dette bare ved å se på den ferdige retten, er du avhengig av gjetting. Det samme gjelder for å skille mellom menneskeskapt og AI-generert innhold på nettet: godkjenning ved kilde gir verifiserbar sikkerhet, mens nedstrøms-oppdaging er innebygget mer usikker og reaktiv.
Hva rolle ser du for standarder som C2PA i fremtiden for media, og er de tilstrekkelige på egen hånd til å gjenopprette tillit på nettet?
C2PA er en velkommen initiativ, og på mange måter støtter den samme bevegelsen for innholdsgodkjenning som OpenOrigins. De er en viktig del av innholdssikkerhets- og innholdsgodkjenning-økosystemet. Som med alle sikkerhetsverktøy, finnes det ingen sølvkule.
For skapere og talenter i bransjer som film, musikk og spill, hva praktiske skritt bør de ta i dag for å beskytte seg mot uautorisert digital replikasjon?
Kunstnere i dag står overfor to distinkte risikoer: replikasjonen av deres arbeid (slik som musikk, bilder eller skriving) og replikasjonen av deres likhet, inkludert deres ansikt, stemme og kropp. Med minimalt innputt kan AI-systemer nå reproducere begge med høy grad av trofasthet. I praktisk sammenheng begynner beskyttelsen med å være bevisst på hva du deler på nettet, og å erkjenne at all innhold som publiseres kan bli skrapet og brukt i treningsdatasett, ofte uten tydelig samtykke eller synlighet.
Den risikoen er nå en basisrealitet for å operere på nettet. Men den mer umiddelbare og kontrollerbare risikoen ligger ofte i kontraktene. Avtaler kunstnere inngår med sine samarbeidspartnere, distributører eller plattformer, kan inkludere klausuler som tillater AI-bruk, gjenbruk eller salg av innhold for treningsformål – ofte uten meningsfull deltakelse i nedstrøms-inntekt.
For kunstnere gjør dette kontraktgjennomgang kritisk. Å forstå hvordan ditt arbeid og din likhet kan bli brukt, lisensiert eller ombrukt, er nå like viktig som den kreative prosessen selv. Mye av den nåværende debatten (over unions-, bransjeorganisasjoner og plattformer) sentrerer rundt å korrigere denne ubalansen og sikre at skapere beholder både kontroll og rettferdig kompensasjon.
Så to nøkkelråd: Vær forsiktig med hva du deler på nettet, og les dine kontrakter og søk etter AI-klausuler før du signerer.
Ser du fremover tre til fem år, tror du vi kommer til å nå et punkt hvor hvert enkelt digitalt innhold må bære verifiserbar godkjenning, eller vil tillit forbli fragmentert over plattformer og jurisdiksjoner?
Jeg ville ønske å si ja, men realistisk, nei – ikke innen fem år. I teknologi føles fem år langt; i forhold til å endre brukeratferd og vaner, er det veldig kort. De fleste forbrukere er usannsynlig å basere sine beslutninger på om innhold kommer med autentisert godkjenning. Plattformer følger vanligvis brukeretterspørsel, og optimaliserer for engasjement snarere enn godkjenning.
Det kunne skifte hvis reguleringen griper inn. Vi ser allerede tidlige bevegelser i steder som California, hvor merking og modereringskrav dukker opp, men å skala dette globalt vil ta tid – sannsynligvis nærmere en tiår enn fem år.
En annen området for endring er sektorsspesifikt: industrier som journalistikk, finans, forsikring og helse kan begynne å kreve godkjenning og autentisering fordi tillit er grunnleggende for deres operasjoner.
Til slutt, bør ikke forbrukerne bry seg om godkjenninginformasjon på kort sikt, men de vil sannsynligvis bry seg om kvaliteten på innholdet og kvaliteten på informasjonen. Hvis AI-generert innhold blir for homogent eller “fargeløst”, kan publikum begynne å verdsette menneskeskapt innhold mer eksplisitt. Det kunne drive en segmentering av markedet, hvor noen plattformer prioriterer skala og AI-generert innhold, og andre kuraterer for autentisitet, godkjenning og høy-tillit, menneskeledet materiale – men den skiftet forblir en ukjent.
Takk for dine flotte svar, lesere som ønsker å lære mer bør besøke OpenOrigins.


